November 13, 2026
Qwen vs Gemini för översättning och varför riktningen har betydelse
Du har två modeller och en lista över språkpar, och du måste bestämma vilken modell du ska anförtro projektet åt. De flesta jämförelser mellan Qwen och Gemini svarar med ett samlat betyg. Jag anser att ett enda betyg döljer det som avgör resultatet, vilket är översättningsriktningen.
Jag arbetar med hur vi testar modellerna som körs på MachineTranslation.com, så jag kan jämföra Qwen och Gemini på 98 språkpar som poängsatts utifrån identisk text. Gemini fick högre poäng i 68 av dessa par och Qwen i 29, och den genomsnittliga skillnaden är 0,08 poäng av 10. De totala siffrorna visar inte i sig vilken modell man bör välja för urdu till engelska eller för engelska till haitisk kreol.
Den här artikeln visar var de två modellerna ligger nära varandra och var var och en leder. Den tar också upp vad jag inte kan säga ännu. Mina data slutar den 8 augusti 2026, innan Google tillkännagav Gemini 4 i oktober, så den beskriver de tidigare versionerna av båda modellerna.
Viktiga slutsatser
- Över 98 språkpar som poängsatts utifrån identisk text (12 juli till 8 augusti 2026) fick Gemini högre poäng i 68 par, Qwen i 29, och ett par slutade oavgjort.
- Den genomsnittliga skillnaden är liten, 9,06 för Gemini mot 8,98 för Qwen, och 60 av de 98 paren ligger inom 0,1 poäng.
- Vid översättning till engelska leder Qwen med mer än 0,1 poäng i 7 av 27 par och Gemini i 3; de övriga 17 ligger inom 0,1 poäng.
- Vid översättning från engelska leder Gemini med mer än 0,1 poäng i 13 av 29 par och Qwen i inget.
- Datan slutar innan Google tillkännagav Gemini 4 i oktober 2026, så den beskriver de tidigare Gemini-versionerna och kräver en ny körning innan någon betraktar den som aktuell.
Är Qwen eller Gemini bättre för översättning?
Det beror på riktningen, eftersom de två modellerna ligger nära varandra när målspråket är engelska och Gemini får högre poäng i de flesta andra par. Sett över alla 98 par fick Gemini högre poäng i 68. I poängen från MachineTranslation.com från 12 juli till 8 augusti 2026 hade Gemini ett genomsnitt på 9,06 av 10 och Qwen 8,98, en genomsnittlig skillnad på 0,08 poäng.
Panelen räknar endast segment där ChatGPT, Claude, DeepSeek, Gemini och Qwen alla fick ett faktiskt poängresultat, så varje modell bedöms utifrån identisk källtext. Varje språkpar har minst 30 segment. Jag använder denna panel eftersom den tar bort ett vanligt fel, vilket är att jämföra modeller utifrån olika text.
Till antalet sett ligger Gemini före i 68 par (69 %), Qwen i 29 (30 %) och ett par slutade oavgjort. Antalet i sig överdriver skillnaden, eftersom 60 av de 98 paren ligger inom 0,1 poäng. Följande avsnitt delar upp resultaten efter riktning och efter marginal.
Vilka översättningsriktningar gynnar respektive modell?
Gemini leder när engelska är källspråk eller när ingetdera språket är engelska, och Qwen ligger jämsides med den eller leder när engelska är målspråk. Från engelska leder Gemini med mer än 0,1 poäng i 13 av 29 par och Qwen i inget. Till engelska leder Qwen med den marginalen i 7 av 27 par och Gemini i 3.
| Riktning | Par | Gemini leder med mer än 0,1 | Inom 0,1 poäng | Qwen leder med mer än 0,1 | Genomsnittlig skillnad |
|---|---|---|---|---|---|
| Till engelska | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Från engelska | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Inget av språken engelska | 42 | 14 | 27 | 1 | Gemini +0,13 |
Till engelska ligger 17 av 27 par inom 0,1 poäng, Qwen leder i 7 och Gemini leder i 3. Från engelska ligger 16 av 29 par inom 0,1 poäng, Gemini leder i 13 och Qwen leder inte i något. Där inget av språken är engelska ligger 27 av 42 inom 0,1 poäng, Gemini leder i 14 och Qwen leder i 1.
Qwen ligger inom 0,1 poäng från Gemini eller leder i 24 av de 27 paren till engelska. I genomsnitt per riktning leder Qwen med cirka 0,04 poäng till engelska, medan Gemini leder med cirka 0,16 poäng från engelska och 0,13 poäng mellan två språk som inte är engelska.
Jag vet inte varför denna uppdelning uppstår, och dessa data kan inte svara på det. En förklaring som jag skulle testa först är blandningen av träningstext bakom respektive modell, men jag har inte kört det testet. Qwen uppvisar ett liknande mönster gentemot ChatGPT. I samma panel fann vår jämförelse mellan Qwen och ChatGPT att de två var nästan jämspelta till engelska, med ChatGPT i ledning i 89 % av de övriga paren.
Vilka språkpar uppvisar de största skillnaderna?
De största skillnaderna gynnar Gemini. Den leder med 0,51 till 0,95 poäng för ryska till kazakiska, engelska till haitisk kreol, engelska till tagalog, spanska till grekiska och arabiska till persiska. Qwens största försprång är mindre, mellan 0,15 och 0,26 poäng, och fyra av dess fem främsta är par till engelska.
| Språkpar | Gemini-poäng | Qwen-poäng | Skillnad |
|---|---|---|---|
| Ryska till kazakiska | 9,27 | 8,32 | Gemini +0,95 |
| Engelska till haitisk kreol | 9,19 | 8,27 | Gemini +0,92 |
| Engelska till tagalog | 9,14 | 8,43 | Gemini +0,70 |
| Spanska till grekiska | 8,90 | 8,33 | Gemini +0,57 |
| Arabiska till persiska | 8,84 | 8,34 | Gemini +0,51 |
| Urdu till engelska | 8,56 | 8,81 | Qwen +0,26 |
| Kinesiska till engelska | 9,00 | 9,19 | Qwen +0,19 |
| Svenska till engelska | 8,29 | 8,46 | Qwen +0,16 |
| Kinesiska till indonesiska | 9,03 | 9,19 | Qwen +0,16 |
| Burmesiska till engelska | 8,94 | 9,09 | Qwen +0,15 |
Jag skulle inte betrakta dessa som slutgiltiga rankningar. De två största skillnaderna, ryska till kazakiska och engelska till haitisk kreol, bygger på mindre urval än medianparet. Engelska till tagalog, spanska till grekiska och arabiska till persiska bygger på större urval, så jag skulle lita mer på de tre. Jag skulle testa om de två skillnaderna med små urval innan jag förlitar mig på dem.
Vad innebär en skillnad på 0,1 poäng?
Enligt min mening är en skillnad under 0,1 poäng för liten för att utse en vinnare. Av de 98 paren faller 60 inom den marginalen, och varje par bedöms på ett begränsat antal segment. Gränsen på 0,1 är min egen arbetströskel, och jag har inte utfört något signifikanstest på dessa par.
Ett poängresultat missar också vissa skillnader. I våra tester med vanliga fraser körde vi "sorry" på arabiska genom 22 AI-modeller. Gemini och Qwen valde båda det vardagliga آسف. ChatGPT och det kombinerade resultatet valde det formella عذرًا. Varje modell fick 9,5 i poäng, så de två orden skiljer sig i stilnivå och poängen rörde sig inte.
Det är därför jag läser marginalen och stilnivåexemplen tillsammans. En liten skillnad med en synlig skillnad i stilnivå kräver ett mänskligt beslut. En stor skillnad baserad på ett litet urval kräver ett nytt test.
Gör Qwen och Gemini olika typer av misstag?
Ja, för i vårt citattest från fotbolls-VM 2026 gjorde båda modellerna minst ett val som de andra modellerna inte gjorde, och poängen rörde sig knappt. Gemini översatte en Mbappé-fras som "with each game" och återgav ett Wirtz-citat ord för ord, medan Qwen gav en annan tolkning av ett Scaloni-citat. Poängen för dessa fall varierade från 9,2 till 9,5.
Detaljerna kommer från vårt citattest från VM. På Mbappés citat om att blicka framåt behöll de andra modellerna "match" medan Gemini skrev "with each game", en liten miss i stilnivå som fick 9,4 i poäng. På ett Wirtz-citat översatte Gemini en fras ord för ord och ändrade innebörden, vilket också gav 9,4. På Scalonis citat samlades de flesta modeller kring en tolkning medan Qwen skrev "that is what matters" och fick 9,4. På Mbappés taktiska citat valde Claude och DeepSeek brittisk fotbollsengelska medan Gemini, Qwen och de andra valde amerikansk engelska, och Qwen fick 9,2, vilket var lägre än resten.
Jag ser dessa som små vanor. Geminis exempel handlar om stilnivå och bokstavliga formuleringar. Qwens handlar om vilken tolkning av en mening man ska välja. Fyra exempel är för få för att kallas ett mönster, men de visar vilken typ av skillnad ett enskilt poängresultat döljer.
Vilken Qwen-modell är bäst för översättning?
Jag kan inte avgöra det utifrån våra data, eftersom poängen på MachineTranslation.com behandlar Qwen som en enda modell utan versionsangivelse. Alibabas Qwen3.8-familj nådde Hugging Face i augusti 2026, så det finns nu flera versioner, och poängen i den här artikeln skiljer dem inte åt.
Jag skulle vilja dela upp detta efter version, men jag kan inte göra det ännu. Siffran på plattformsたいnivå kan vara ett genomsnitt av fler än en Qwen-version som kördes under tidsfönstret. Om du väljer mellan Qwen-versioner för ett projekt skulle jag jämföra dem på ett urval av din egen text.
Vilka är några alternativ till Gemini för översättning?
ChatGPT, Claude, DeepSeek, Qwen, Grok och Mistral AI körs alla på MachineTranslation.com, och rätt alternativ beror på paret. I våra poäng från den 12 juli till den 8 augusti 2026 ligger Qwen inom 0,1 poäng från Gemini eller före i 24 av 27 par till engelska. Våra franska poäng för Mistral AI visar att dess genomsnitt från franska till engelska ligger 0,40 poäng över Geminis.
Om ditt alternativ är ChatGPT beror svaret också på paret. I vår publicerade uppdelning av spanska till engelska vann Gemini 31% av segmenten och ChatGPT vann 21%. På franska vinner ingen av modellerna i båda riktningarna. Eftersom valet förändras beroende på par väljer MachineTranslation.com inte ett enda alternativ. Plattformen kör dem tillsammans.
Mitt förslag är att utgå från paret och riktningen, och sedan se vilket alternativ som passar.
Hur visar MachineTranslation.com var Qwen och Gemini inte är överens?
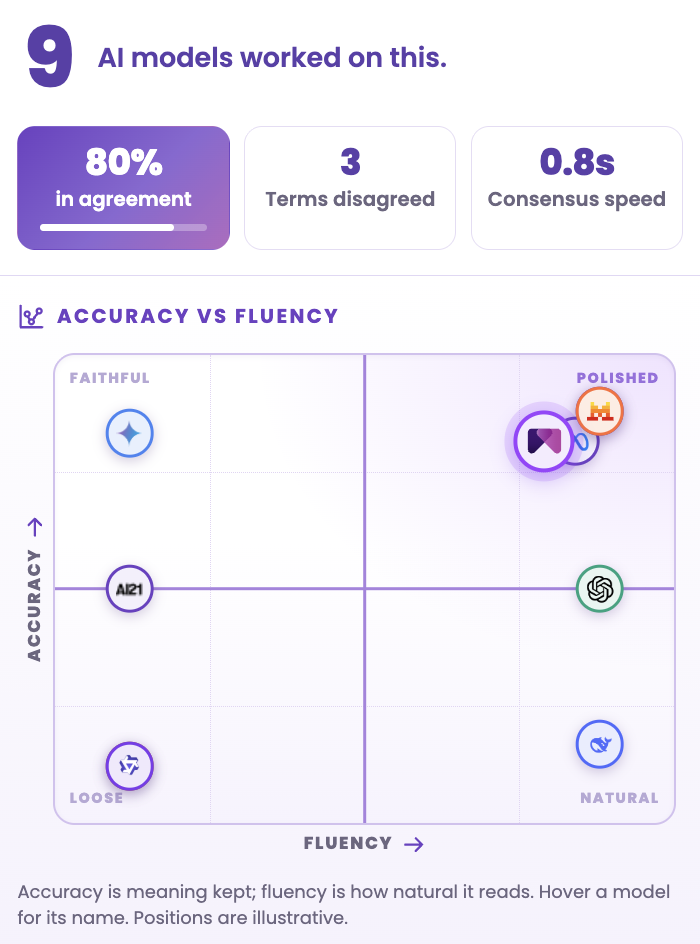
MachineTranslation.com kör båda modellerna på varje översättning och visar var modellerna är överens och var de skiljer sig åt. Panelen för samstämmighet rapporterar hur många AI-modeller som arbetade med texten, andelen som var överens, hur många termer som var omtvistade och hur snabbt konsensus uppstod.
Hur aktuella är dessa resultat?
Dessa resultat omfattar July 12 to August 8, 2026, så de beskriver de versioner av Gemini och Qwen som kördes då. Google tillkännagav Gemini 4 i October 2026. Alibabas Qwen3.8-familj anlände i August 2026. Min rekommendation är att köra panelen igen innan du förlitar dig på dessa siffror för ett nytt projekt.
Jag förväntar mig att metoden att jämföra identisk text med en marginal för brus håller. Jag förväntar mig att storleken på skillnaderna kommer att förändras. Jag skulle betrakta varje par där ledaren skiftar vid en ny körning som ett tecken på att den tidigare skillnaden rymdes inom bruset.
Hur skulle jag välja mellan Qwen och Gemini för ett projekt?
Min ståndpunkt är att välja utifrån par och riktning och att undvika att välja en enda gång för ett helt projekt. I praktiken innebär det att betrakta en skillnad på under 0,1 poäng som oavgjort och att förvänta sig att den ledande modellen växlar mellan par. Det här är den ordning jag skulle följa.
- Lista varje språkpar i projektet och markera dess riktning.
- Kontrollera skillnaden för varje par i den här artikeln. Behandla en skillnad under 0,1 poäng som oavgjort.
- Där skillnaden är större, börja med den ledande modellen och testa ett urval av din egen text.
- Om ditt innehåll rör sig i båda riktningarna bör du räkna med att ledaren skiftar mellan paren.
- Kontrollera igen när någon av modellerna släpper en ny version.
Båda modellerna körs sida vid sida med 20 andra vid varje översättning på MachineTranslation.com. Den version som de flesta av dem är överens om returneras, så valet behöver inte göras en enda gång för hela projektet. Den fullständiga uppsättningen modellresultat finns i vår modelljämförelsetestning.
Vanliga frågor
1. Är Qwen eller Gemini bäst för översättning?
Det beror på riktningen, eftersom Qwen ligger inom 0,1 poäng från Gemini eller leder i 24 av 27 par till engelska. Gemini fick fortfarande högre poäng i 68 av 98 par i MachineTranslation.com:s resultat från den 12 juli till den 8 augusti 2026. Den genomsnittliga skillnaden är 0,08 poäng av 10, så jag skulle välja utifrån språkkombination.
2. Vilken Qwen-modell är bäst för översättning?
Jag kan inte avgöra det utifrån våra data, eftersom MachineTranslation.com:s poäng behandlar Qwen som en enda modell utan versionsmärkning. Alibabas Qwen3.8-familj nådde Hugging Face i augusti 2026, så det finns nu flera versioner. Tills poängen särskiljer dem skulle jag jämföra versionerna på ett urval av din egen text innan du väljer en för ett projekt.
3. Vilka är några alternativ till Gemini för översättning?
ChatGPT, Claude, DeepSeek, Qwen, Grok och Mistral AI körs alla på MachineTranslation.com. I våra resultat från 12 juli till 8 augusti 2026 ligger Qwen inom 0,1 poäng från Gemini eller före i 24 av 27 par till engelska. Mistral AI:s genomsnitt för franska till engelska låg 0,40 poäng över Geminis. Rätt alternativ beror på paret.
4. Är Gemini bättre än ChatGPT för översättning?
Det beror på språkparet, eftersom ingen enskild AI-modell vinner överallt. I vår publicerade sammanställning för spanska till engelska vann Gemini 31 % av segmenten och ChatGPT vann 21 %. På franska vinner ingen av modellerna i båda riktningarna. Jag skulle kontrollera paret och riktningen du behöver innan du väljer mellan dem.
5. Är Gemini träffsäker för översättning?
Ja, eftersom Gemini hade ett genomsnitt på 9,06 av 10 över 98 språkpar i MachineTranslation.coms poäng från 12 juli till 8 augusti 2026. Träffsäkerheten varierar dock fortfarande beroende på par. Dess försprång är störst från engelska, och Qwen ligger före den med mer än 0,1 poäng i 7 av 27 par till engelska.