October 2, 2026
Qwen vs Grok: Vilken AI-modell översätter bättre?
Qwen och Grok är båda generella AI-modeller, inte översättningsspecifika verktyg, och båda ingår i den modellpool som MachineTranslation.com kör för varje översättning. Det spelar roll för hur man ska tolka det som följer. Detta är en inblick i hur två av plattformens egna modeller presterar mot varandra, med de verkliga förbehåll som följer med denna typ av data, och inte en tävling mellan två externa utmanare och plattformen i sig.
Vad är Qwen och Grok?
Qwen är Alibabas familj av stora språkmodeller, för närvarande inne på sin Qwen3.8-generation, och lades till i MachineTranslation.coms modellpool som en del av plattformens pågående expansion. Grok är xAIs modellserie, för närvarande på Grok 4.7 i skrivande stund, och har gått igenom flera versioner sedan den version som denna artikel ursprungligen jämförde, och lades till på plattformen separat. Ingen av modellerna byggdes specifikt för översättning. Båda är generella system som råkar kunna hantera många språk som en del av en bredare språklig kapacitet, vilket är en annan utgångspunkt än en plattform som byggts och testats specifikt utifrån översättningskvalitet.
Hur står sig Qwen och Grok i jämförelse utifrån MachineTranslation.coms egen data?
Under de senaste 28 dagarna av plattformstrafik fick Grok i genomsnitt högre poäng än Qwen: 9.26 av 10 mot 8.87. Groks 10% sämsta översättningar hade fortfarande ett snitt på 9.2, medan Qwens sämsta 10% sjönk till 7.6, vilket är ett större glapp i botten än vad enbart genomsnittet antyder.
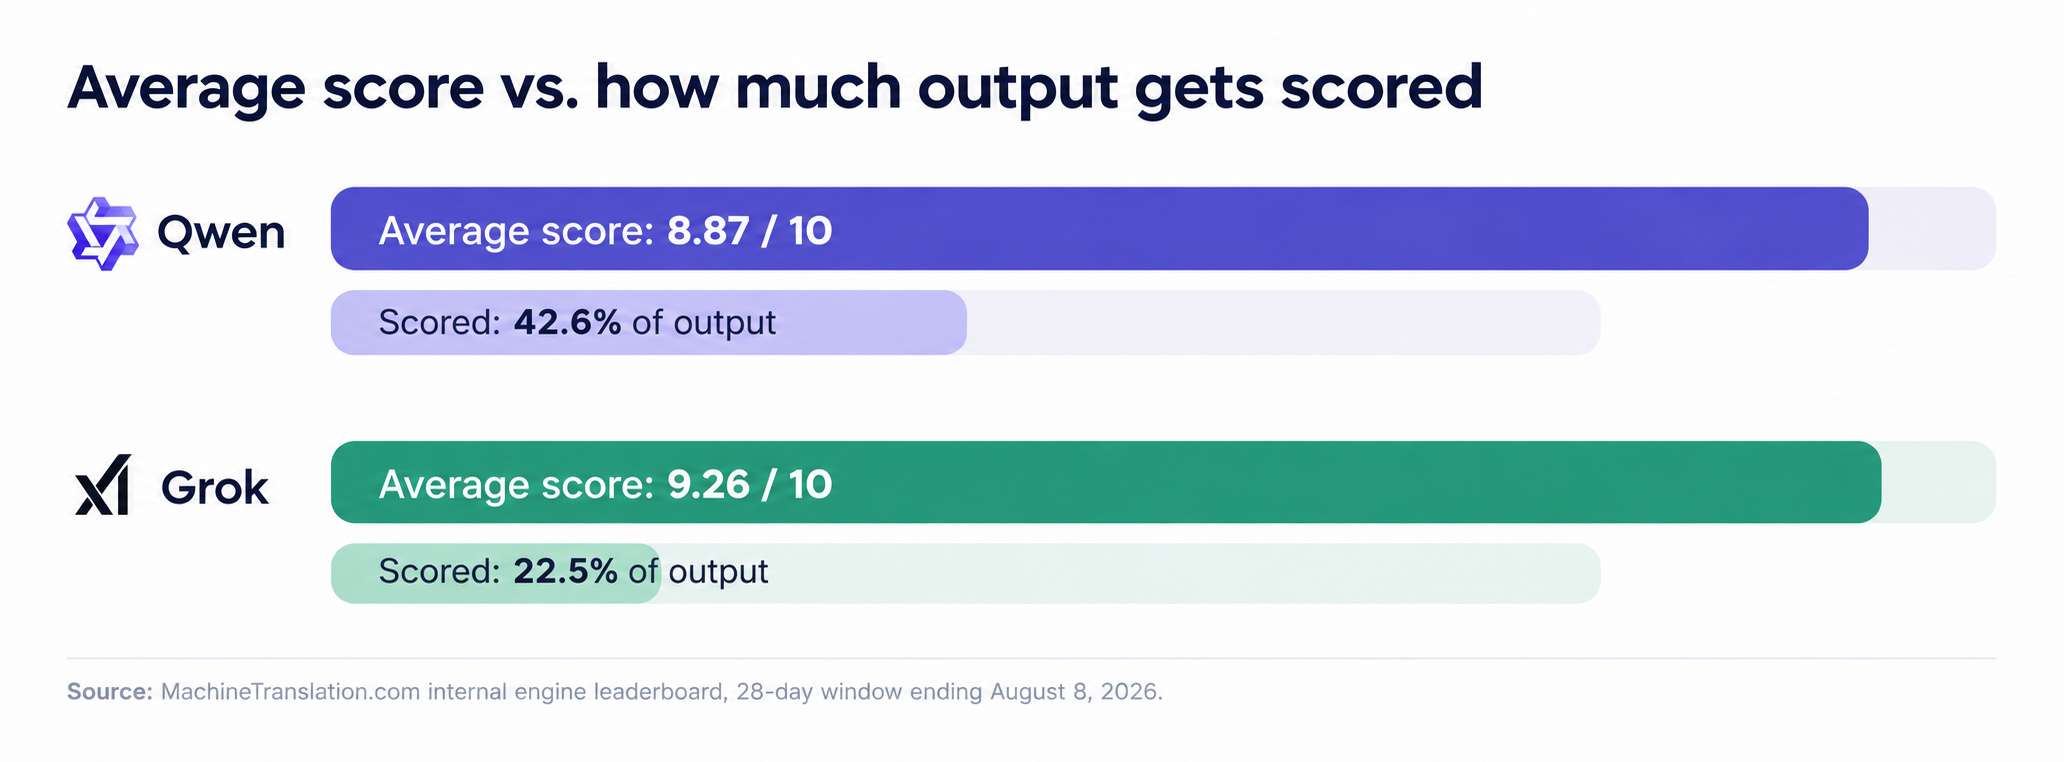
Groks genomsnittspoäng är högre, men den baseras på poängsättningen av mindre än en fjärdedel av dess utdata, jämfört med nästan hälften för Qwen. De två staplarna berättar olika delar av samma historia.
| Qwen | Grok | |
|---|---|---|
| Procent av utdata som poängsatts | 42.6% | 22.5% |
| Genomsnittspoäng | 8.87 / 10 | 9.26 / 10 |
| Lägsta 10 % av poängen | 7.6 | 9.2 |
Källa: MachineTranslation.coms interna rankinglista för motorer, 28-dagarsfönster som slutar August 8, 2026.
Innebär Groks högre poäng att det är det bättre valet?
Inte i sig självt. Grok används mycket mer sällan på plattformen än Qwen, och mindre än en fjärdedel av dess översättningar poängsätts överhuvudtaget, jämfört med nästan hälften av Qwens. Ett mindre, mindre representativt urval kan få ett genomsnitt att se bättre eller sämre ut än vad det skulle göra över samma volym som Qwen hanterar. MachineTranslation.coms egen rapportering av dessa data behandlar poängsättningens täckning som en verklig begränsning, inte en fotnot: en motor som poängsätts på en snäv del av sin trafik har inte testats lika noggrant som en som poängsätts över nästan hälften av sitt utdata.
Den ärliga tolkningen är att Groks siffror är lovande men vilar på ett tunnare underlag. Qwens är lägre i genomsnitt men vilar på en mycket större, mer representativ bas. Inget av dessa fakta tar ut det andra.
Hur är det med språktäckningen?
Varken Qwen eller Grok publicerar en verifierad lista över språkkombinationer där prestandan sjunker, och det finns inga oberoende tester för att bekräfta en sådan. Vad som kan sägas med säkerhet är att ingen av modellerna byggdes kring översättningskvalitet över en specifik språkuppsättning på det sätt som en dedikerad översättningsplattform är. MachineTranslation.com testar och stöder över 270 språk direkt, vilket är ett annat slags anspråk än en generell modells breda men otestade flerspråkiga kapacitet.
Hur MachineTranslation.com faktiskt använder Qwen och Grok
MachineTranslation.com kör Qwen, Grok och mer än 20 andra AI-modeller på varje översättning, och lyfter sedan fram den version som dessa modeller är mest överens om. Ingen av modellerna utesluts för att de har lägre genomsnittspoäng. Att köra många modeller samtidigt innebär att man fångar upp de fall där en i genomsnitt lägre poängsatt modell ändå får en specifik mening rätt som en högre poängsatt modell missar. Qwens prestanda varierar också beroende på översättningsriktning och språkkombination på sätt som är värda att veta innan man väljer en enskild modell, vilket behandlas mer ingående i MachineTranslation.coms jämförelse av Qwen vs DeepSeek. För en närmare titt på hur modeller testas direkt mot varandra, se MachineTranslation.coms fullständiga test av modelljämförelser.
Vanliga frågor
1. Är Qwen eller Grok bäst för översättning?
Enligt MachineTranslation.coms egen 28-dagars motordata får Grok i genomsnitt högre poäng än Qwen, 9.26 jämfört med 8.87 av 10. Men Grok bedöms på en mycket mindre, mindre representativ andel av sin utdata, så detta är ingen renodlad direkt jämförelse på det sätt som ett test med matchade segment skulle vara.
2. Varför har Grok en högre genomsnittlig poäng men färre poängsatta översättningar?
Grok används mer sällan på plattformen och bara ungefär 22.5% av dess utdata poängsätts, jämfört med 42.6% för Qwen. Ett mindre, mindre representativt urval kan blåsa upp eller underskatta ett genomsnitt, vilket är anledningen till att denna jämförelse bör ses som vägledande, inte definitiv.
3. Stöder Qwen eller Grok fler språk?
Båda är AI-modeller för generella ändamål utan en publicerad, verifierad lista över språkspecifika begränsningar. Ingen av dem är byggd specifikt för översättning, vilket skiljer sig från en plattform som testar och poängsätter översättningskvalitet över 270+ språk direkt, istället för att förlita sig på bred flerspråkig träning som en ersättning för uppmätt översättningsprestanda.
4. Konkurrerar MachineTranslation.com med Qwen och Grok?
Nej. MachineTranslation.com kör Qwen, Grok och mer än 20 andra AI-modeller på varje översättning och lyfter fram den version som dessa modeller är mest överens om. Den testar och kombinerar modeller som dessa istället för att konkurrera med dem som en egen, separat modell.
5. Vilken AI-modell rekommenderar MachineTranslation.com för översättning?
Ingen som standard. Olika modeller presterar olika bra beroende på språkpar och innehållstyp, och klyftan mellan dem kan gå i båda riktningarna beroende på vad som översätts. Den variationen är precis varför plattformen kör flera modeller på varje översättning istället för att välja ut en som en stående rekommendation.