April 16, 2026
Grok проти ChatGPT для перекладу: який з них варто використовувати у 2026 році?
У вас, напевно, вже відкрита вкладка з одним із них. Питання в тому, чи є отриманий результат достатньо точним для використання (для документа клієнта, сторінки продукту, пункту контракту) без того, щоб витрачати наступні 20 хвилин на сумніви щодо кожного речення.
У цій статті порівнюються Grok 4.1 та ChatGPT (GPT-5.4) саме для використання в перекладі: що кожна модель робить добре, у чому кожна зазнає невдачі та що вам потрібно, коли жодної з них не зовсім достатньо.
Що таке Grok і як він розвивався?
Grok — це велика мовна модель, розроблена xAI, компанією штучного інтелекту, заснованою Ілоном Маском у 2023 році (тепер вона є частиною SpaceX після придбання в лютому 2026 року). З моменту свого запуску Grok пройшов чотири основні покоління: Grok 1 (2023), Grok 2 (2024), Grok 3 (лютий 2025) та Grok 4 (липень 2025), а Grok 4.1 буде доступний з кінця 2025 року.
Визначальною архітектурною особливістю Grok є доступ до даних у реальному часі. На відміну від більшості великих мовних моделей, навчених на статичних наборах даних, Grok інтегрує пошук в інтернеті в реальному часі та дані платформи X (раніше Twitter) у свої відповіді. Це робить його надзвичайно ефективним для роботи з контентом, що стосується поточних подій, нової термінології, нещодавно створених галузевих виразів або чутливих до фактору часу вихідних матеріалів — категорій, у яких моделі, навчені на старіших зрізах даних, можуть використовувати застарілі формулювання або упускати нещодавній контекст.
Зокрема для перекладу доступ Grok у режимі реального часу є справжньою перевагою у вузькому, але важливому колі сценаріїв використання: перекладі новинного контенту, пресрелізів, нормативних оновлень та матеріалів, що посилаються на поточні події чи нові терміни. Його багатомовна підтримка покращувалася з кожним наступним поколінням моделей. Grok 4.1 оснащений контекстним вікном на 131 тис. токенів, покращеним багатомовним виведенням та нативним використанням інструментів з інтеграцією пошуку в реальному часі.
У чому Grok все ще поступається спеціалізованій інфраструктурі перекладу: це модель загального призначення, а не спеціалізована модель для перекладу. Він генерує єдиний результат без внутрішнього механізму перевірки. Якість результату варіюється залежно від мовної пари та типу контенту, і немає міжмодельної перевірки, щоб виявити помилковий результат.
Що таке ChatGPT і що змінює GPT-5.4?
ChatGPT — це діалоговий штучний інтелект, розроблений компанією OpenAI та побудований на базі його архітектури GPT (Generative Pre-trained Transformer). Він був запущений у листопаді 2022 року і став найшвидше зростаючим споживчим застосунком в історії. Станом на квітень 2026 року поточною моделлю є GPT-5.4, випущена 5 березня 2026 року.
Для завдань перекладу ChatGPT є однією з найпотужніших доступних LLM загального призначення. У внутрішньому бенчмарку MachineTranslation.com на основі 5 000 слів змішаного технічного та маркетингового контенту ChatGPT показав точність 89,8% — продемонструвавши хороші результати щодо якості на поверхневому рівні, але згенерувавши галюцинований контент у двох ключових реченнях під час цього тесту. У незалежних наукових бенчмарках GPT-5.4 демонструє результат 92,0% у тесті GPQA Diamond (наукове мислення рівня PhD), що свідчить про високу ефективність роботи зі складним фактологічним контентом, де точність має важливе значення.
ChatGPT підтримує широкий спектр мов і добре справляється зі складними структурами речень, ідіоматичними виразами та професійним регістром для європейських та основних азійських мовних пар. Його слабкі сторони в перекладі є радше структурними, ніж пов'язаними з якістю: як і будь-яка одномодельна система штучного інтелекту, вона не може перевірити власний результат. Коли він галюцинує (створюючи переклад, який звучить природно, але є фактично або семантично неправильним), немає жодного сигналу, який би попереджав користувача.
Як Grok і ChatGPT порівнюються за точністю перекладу?
Обидва інструменти створюють високоякісні переклади для загального контенту. Суттєві відмінності виникають на межі — коли контент є спеціалізованим, технічним, чутливим до часу або пов'язаним із високими ставками.
Де Grok має перевагу: Контент про поточні події, термінологія, що формується, та матеріали, які потребують актуального контексту. Інтеграція пошуку в реальному часі в Grok означає, що він може спиратися на нещодавні шаблони використання при перекладі новинних статей, запусків продуктів або регуляторних оновлень — контенту, де модель, навчена на даних шестимісячної давнини, може видавати застарілі формулювання.
У чому ChatGPT має перевагу: Структурований, насичений фактами контент — наукові, юридичні та технічні тексти, де точність усталеної термінології важливіша за новизну. Результат GPT-5.4 у тесті GPQA на рівні 92,0% та на 33% нижча частота неправдивих тверджень порівняно з попередніми моделями роблять його кращим вибором для високоточного професійного перекладу складних вихідних матеріалів.
Чого не може зробити жоден з інструментів: Перевірити власний вивід. Окремі провідні LLM (включаючи як Grok, так і ChatGPT) галюцинують або вигадують контент у від 10% до 18% випадків під час виконання завдань із перекладу, згідно з даними, синтезованими на основі звітів Intento «State of Translation Automation 2025» та «WMT24 General Machine Translation Findings». Для професійного, клієнтського або регульованого контенту такий діапазон є неприйнятною похибкою.
| Grok 4.1 | ChatGPT (GPT-5.4) | |
|---|---|---|
| Найкраще підходить для | контенту, чутливого до часу, та матеріалів про поточні події | структурованого, технічного та насиченого фактами контенту |
| Доступ до даних у реальному часі | Так — інтеграція з X у реальному часі та вебом | Ні — статичні навчальні дані |
| Бенчмарк точності | AIME 2025: 91,7% (математичні міркування) | GPQA Diamond: 92.0% (наукові міркування) |
| Бенчмарк перекладу | ---- | 89.8% на 5 000 слів змішаного контенту (з 2 галюцинованими реченнями) |
| Верифікація результатів | Одна модель, без сигналу верифікації | Одна модель, без сигналу верифікації |
| Рівень галюцинацій (одна модель) | 10–18% (Intento/WMT24) | 10–18% (Intento/WMT24) |
Чим відрізняється підтримка мов у Grok та ChatGPT?
ChatGPT підтримує широкий набір мов з усіх основних мовних сімей. Він демонструє найкращі результати на європейських мовних парах та основних азійських мовах (китайській, японській, корейській), з дещо менш стабільною якістю для малоресурсних мов.
Grok поступово розширював свою багатомовну підтримку в різних поколіннях моделей. Grok 4.1 демонструє суттєве покращення порівняно з попередніми версіями для результатів неанглійською мовою, хоча він залишається орієнтованим на високоресурсні мовні пари, де навчальних даних є вдосталь.
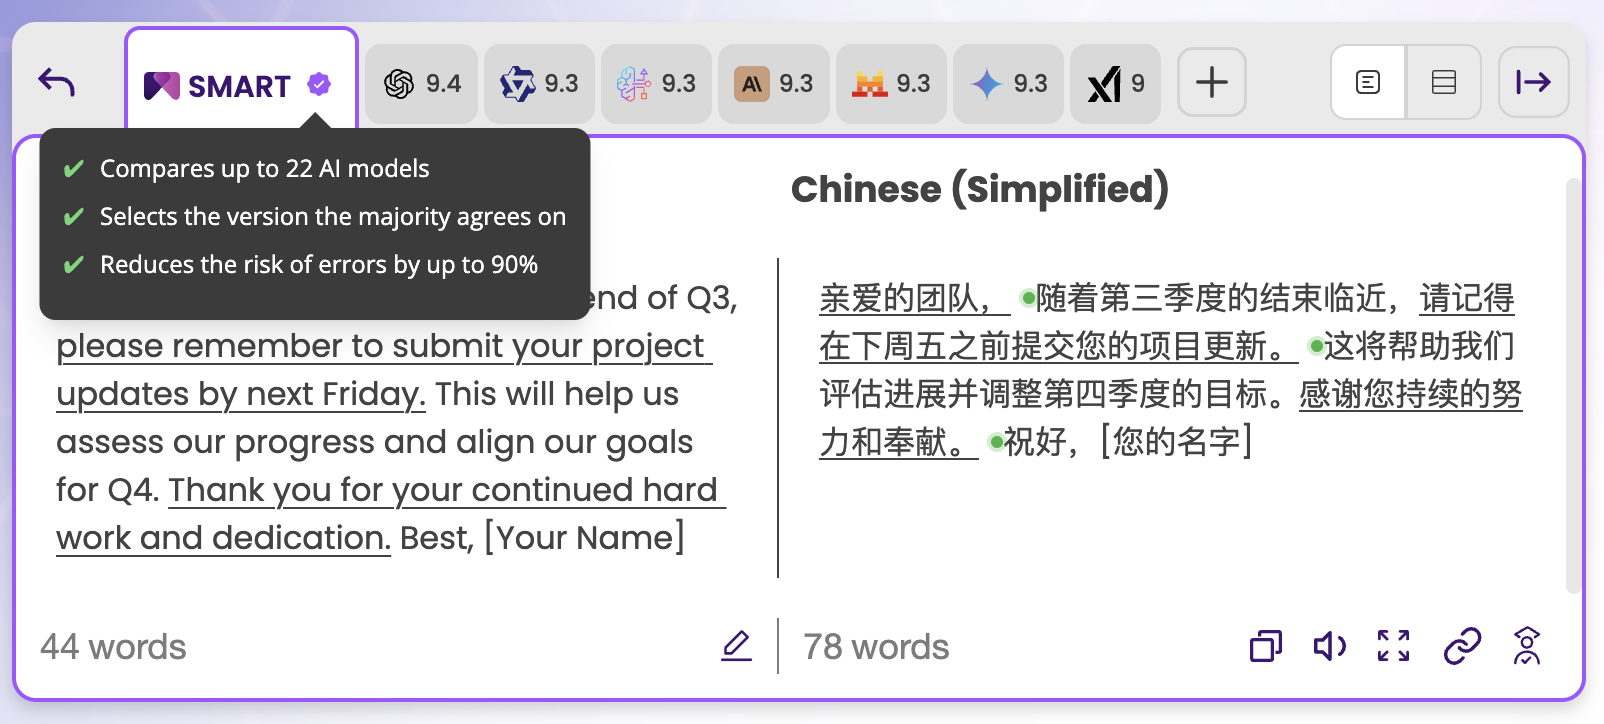
MachineTranslation.com підтримує понад 330 мов, одночасно об'єднуючи 22 моделі ШІ (включаючи як Grok, так і ChatGPT) та вибираючи результат, з яким погоджується більшість. Для команд, які працюють на кількох ринках або з менш поширеними мовними парами, цей підхід усуває потребу оцінювати кожен інструмент для кожної мови окремо.
Для отримання рекомендацій щодо конкретних мовних пар: З англійської на іспанську, з англійської на французьку, з англійської на німецьку.
Як співвідносяться ціни між Grok та ChatGPT?
Grok (xAI):
- Безкоштовний тариф: Доступно через X з обмеженим доступом до Grok
- X Premium+: $22/місяць — включає доступ до чат-бота Grok
- SuperGrok: $30/місяць — розширені можливості
- API (Grok 4.1): $0.20 per 1 million input tokens / $0,50 за 1 мільйон вихідних токенів — серед найнижчих тарифів API на ринку LLM
ChatGPT (OpenAI):
- Безкоштовний тариф: Доступно з обмеженими можливостями
- ChatGPT Plus: $20/місяць
- ChatGPT Pro: $200/місяць
- API (GPT-5.4): $1.75 per 1 million input tokens / $14.00 за 1 мільйон вихідних токенів
MachineTranslation.com:
- Безкоштовно: Денний ліміт без реєстрації; переклади оновлюються кожні 24 години
- Тарифний план Pro: $39/місяць — безлімітні переклади, обробка документів, збереження оригінального макету
- Повний доступ на 24 години: $9.50 (одноразово, без автопродовження)
Ціни на API Grok помітно нижчі, ніж у ChatGPT, що робить його економічно привабливим для великих обсягів використання API. Проте, конкретно для перекладу, вартість за токен — це лише один аспект — якість результату, витрати на перевірку та виправлення помилок мають таке ж значення у професійному контексті.
У кого кращий API для робочих процесів перекладу?
API Grok став повністю доступним із переходом xAI на оплату за фактичне використання у жовтні 2025 року. Ціни є одними з найнижчих на ринку і становлять $0,20 за 1 млн вхідних токенів (Grok 4.1). Документація значно розширилася з моменту бета-версії Grok 3. Для розробників, які створюють конвеєри, що потребують інтеграції даних у реальному часі, API від Grok є чудовим варіантом.
API ChatGPT (OpenAI) є найбільш зрілим і широко задокументованим API для LLM серед доступних. Він підтримує виклик функцій, структурований вивід, користувацькі GPT та широку екосистему інтеграції. За ціною $1,75 за 1 млн вхідних токенів для GPT-5.4, він значно дорожчий за Grok, але має глибші можливості налаштування та історію стабільності, які зазвичай потрібні для корпоративних робочих процесів.
API MachineTranslation.com спрямовує запити через усі 22 моделі одночасно (включаючи як Grok, так і ChatGPT) і повертає консенсусний результат SMART. Для розробників, яким потрібна перевірена якість перекладу у великих масштабах, один виклик API замінює потребу самостійно керувати, оцінювати та порівнювати інтеграції кількох рушіїв.
Для огляду варіантів та цін на API перекладу: Порівняння API перекладу.
Який інструмент краще підходить для якого типу перекладу?
Використовуйте Grok 4.1 для:
- Контенту про поточні події, новинних статей та пресрелізів, де важливий актуальний контекст
- Перекладу матеріалів із новою термінологією або нещодавно створеною галузевою мовою
- Великих обсягів менш відповідальних перекладів, де вартість за токен є основним фактором
- Контенту, що посилається на нещодавні культурні події або мовні шаблони соціальних мереж
Використовуйте ChatGPT (GPT-5.4) для:
- Технічного, наукового та професійного контенту, де важлива структурована точність
- Юридичних, фінансових або медичних текстів з усталеною термінологією
- Довгих документів, де важлива логічна узгодженість усього тексту
- Будь-якого контексту, де вже використовуються широкі інтеграції екосистеми GPT (Word, Notion, Zapier тощо)
В обох випадках: Жоден з інструментів не перевіряє власний результат і жоден не надає сигналу впевненості перед тим, як ви надішлете переклад.
Що робити, коли точність має бути гарантованою?
І Grok, і ChatGPT створюють корисні переклади. Вони зазнають невдачі в один і той самий структурний спосіб: одна модель не може виявити помилки, які вона створює. Коли Grok неправильно передає юридичний термін або ChatGPT галюцинує два речення посеред технічного документа (як це сталося у внутрішньому бенчмарку MachineTranslation.com на 5000 слів), у вихідних даних немає нічого, що вказало б вам, де саме це сталося.
Саме цю проблему за своєю концепцією вирішує механізм SMART від MachineTranslation.com. SMART проводить кожен переклад через 22 моделі ШІ одночасно (зокрема Grok та ChatGPT серед них), а потім застосовує консенсусний аудит: обирається переклад, з яким погоджується більшість моделей. Оскільки перекладацькі галюцинації є специфічними для конкретних моделей, узгодженість між моделями структурно відфільтровує їх.
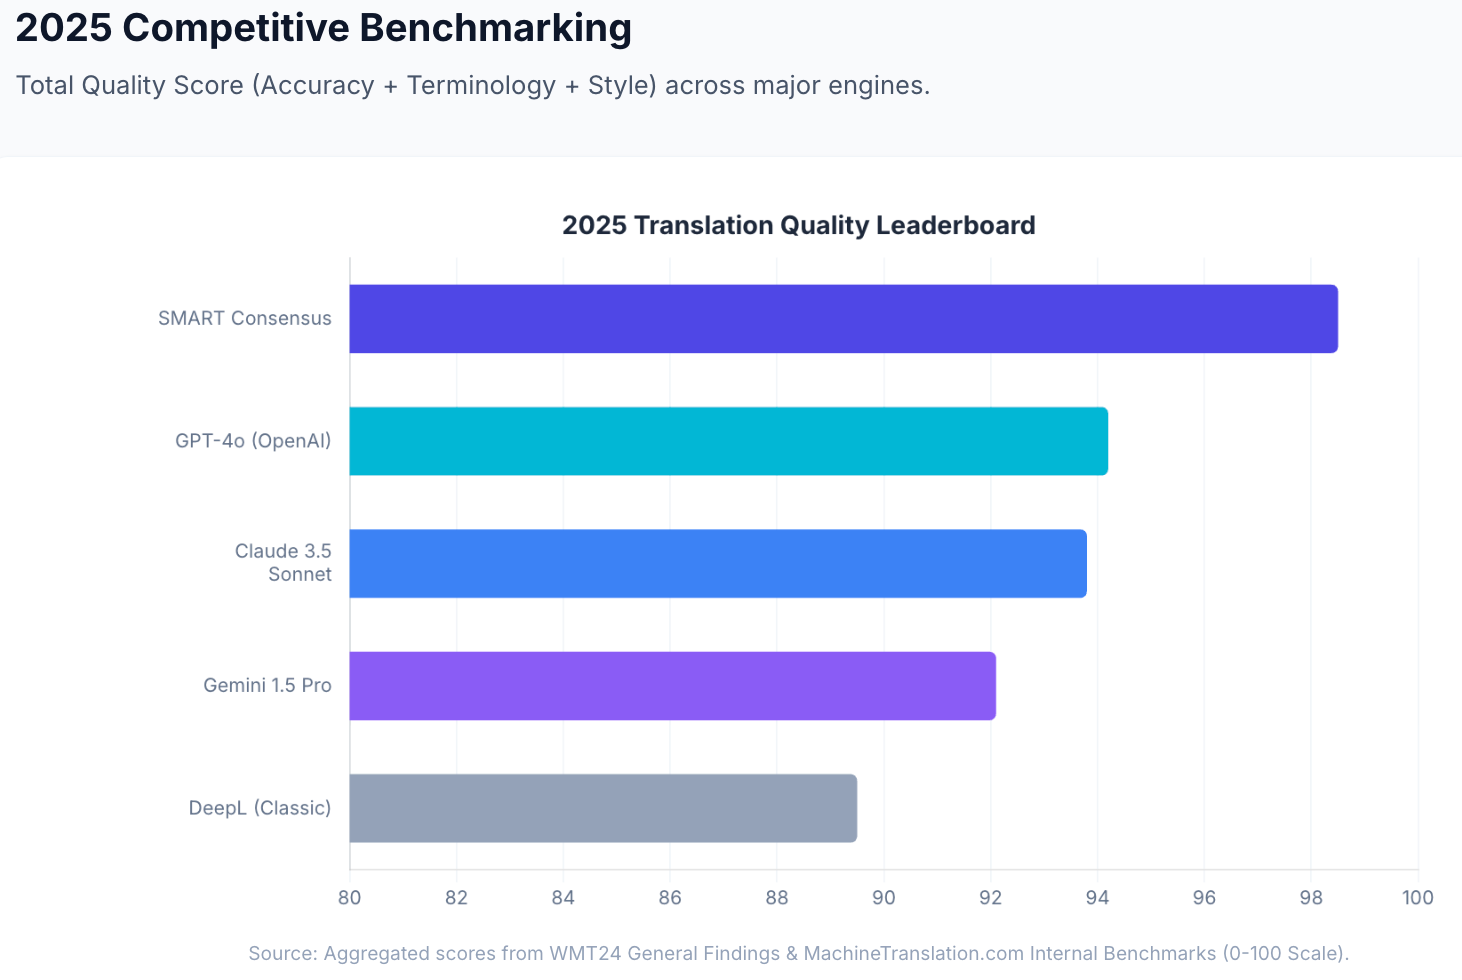
Внутрішні бенчмарки показують, що консенсусний підхід SMART досягає сукупного показника якості 98,5 зі 100 (порівняно з GPT-4o з результатом 94,2 в тому самому наборі бенчмарків) і знижує ризик критичних помилок перекладу на 90%. Переклади, виконані за допомогою SMART, зменшують кількість критичних помилок до менш ніж 2%, порівняно з 10–18% галюцинацій в одномодельних LLM, зокрема Grok та ChatGPT. (Джерело: Внутрішні звіти MachineTranslation.com; Звіт Intento «Стан автоматизації перекладу 2025»; Висновки WMT24 щодо загального машинного перекладу.)
Для перекладів, які потребують абсолютної точності (юридичні документи, клінічна документація, регуляторні подання), на цій же платформі доступна перевірка людиною. Без зовнішніх агентств. 100% точність гарантовано.
Почніть перекладати на MachineTranslation.com — безкоштовно, реєстрація не потрібна. Запускайте Grok, ChatGPT та 20 інших моделей ШІ одночасно й отримуйте узгоджений ними переклад.
Часті запитання
1. Чи Grok кращий за ChatGPT для перекладу?
Жоден не є однозначно кращим для всіх завдань з перекладу. Grok 4.1 має особливу перевагу при перекладі контенту про поточні події та матеріалів, що містять нову термінологію, завдяки інтеграції вебданих та даних мережі X у реальному часі. ChatGPT (GPT-5.4) лідирує в бенчмарках структурованої точності та є сильнішим у роботі з технічними, науковими та юридичними текстами. Обидві мають одне й те саме основне обмеження: як одномодельні системи, жодна не може перевірити свій власний результат.
2. Чи може Grok перекладати документи?
Grok може перекладати вставлений текст і, залежно від тарифного плану, завантажені документи. Однак це не спеціалізований інструмент для перекладу й він не пропонує таких функцій, як збереження оригінального макету, оцінювання якості перекладу чи крос-модельна верифікація. Для перекладу документів із збереженням макету MachineTranslation.com підтримує файли розміром до 30 МБ у форматах PDF, DOCX, TXT, CSV, XLSX та зображень.
3. Наскільки точним є ChatGPT для перекладу в 2026 році?
У внутрішньому бенчмарку MachineTranslation.com на основі 5 000 слів змішаного технічного та маркетингового контенту ChatGPT показав точність 89,8% — високий показник, але в тому самому тесті він згалюцинував контент у двох реченнях. У бенчмарках наукового мислення (GPQA Diamond) GPT-5.4 набирає 92,0%. Як і в усіх одномодельних LLM, галюцинації ChatGPT виникають із частотою 10–18% у завданнях із перекладу, згідно з даними Intento State of Translation Automation 2025 та висновками WMT24.
4. Яка вартість Grok у 2026 році?
Grok доступний через X Premium+ ($22/month) or SuperGrok ($30/місяць) для споживачів. Вартість API xAI (Grok 4.1) становить $0.20 per 1 million input tokens and $0,50 за 1 мільйон вихідних токенів, що є одним із найнижчих тарифів на API серед основних LLM.
5. Чи використовує MachineTranslation.com Grok та ChatGPT?
Так. І Grok, і ChatGPT входять до числа 22 моделей штучного інтелекту, які MachineTranslation.com запускає одночасно через свою систему SMART. Замість того, щоб покладатися лише на один інструмент, SMART обирає переклад, з яким погоджується більшість із 22 моделей, — зберігаючи сильні сторони кожної та водночас відсіюючи помилки, притаманні окремим моделям. Повний список моделей включає ChatGPT, Claude, Gemini, DeepL, Google, Grok та 16 інших.
6. Який інструмент ШІ кращий для юридичного чи медичного перекладу?
Для регульованого контенту ні Grok, ні ChatGPT окремо недостатньо — обидва інструменти генерують галюцинації на рівні 10–18% у завданнях з перекладу, що є прямим ризиком для юридичних і медичних документів. SMART-консенсус MachineTranslation.com знижує цей рівень помилок до менш ніж 2%, а перевірка людиною доступна на тій самій платформі із 100% гарантією точності для контенту, який цього потребує.
Перекладайте за допомогою Grok, ChatGPT та ще 20 інших моделей штучного інтелекту одночасно на MachineTranslation.com — безкоштовно, реєстрація не потрібна.