October 9, 2026
Qwen vs ChatGPT : quel modèle d'IA traduit le mieux ?
La génération actuelle de ChatGPT et Qwen font tous deux partie du pool de modèles que MachineTranslation.com utilise pour chaque traduction, et non de deux concurrents externes évalués par rapport à la plateforme elle-même. Soumettez le même texte aux deux modèles sur des segments identiques, et ChatGPT l'emporte globalement sur la majorité des paires de langues. En ventilant les résultats par sens de traduction, la tendance se resserre nettement sur un point précis : la traduction vers l'anglais, où les deux modèles sont presque au coude-à-coude.
Existe-t-il une IA meilleure que ChatGPT pour la traduction ?
L'intérêt général pour les alternatives à ChatGPT a augmenté à mesure que les modèles concurrents se sont améliorés, bien que les raisons varient considérablement selon les cas d'usage et qu'il n'y ait pas d'explication unique. Pour la traduction en particulier, la question la plus pertinente est de savoir quel modèle est réellement le plus performant sur une paire de langues donnée — une question vérifiable plutôt qu'une affaire de ressenti.
Au cours des 28 derniers jours de trafic sur MachineTranslation.com, les deux modèles ont traduit des textes sources identiques sur 98 paires de langues. ChatGPT a obtenu un score plus élevé sur 77 de ces paires ; Qwen a obtenu un score plus élevé sur 21 d'entre elles. La moyenne pondérée sur les résultats comparés situe ChatGPT à 9.10 sur 10 et Qwen à 8.98, un écart moyen réel mais modeste qui masque une disparité bien plus marquée dès lors que le sens de traduction est pris en compte.
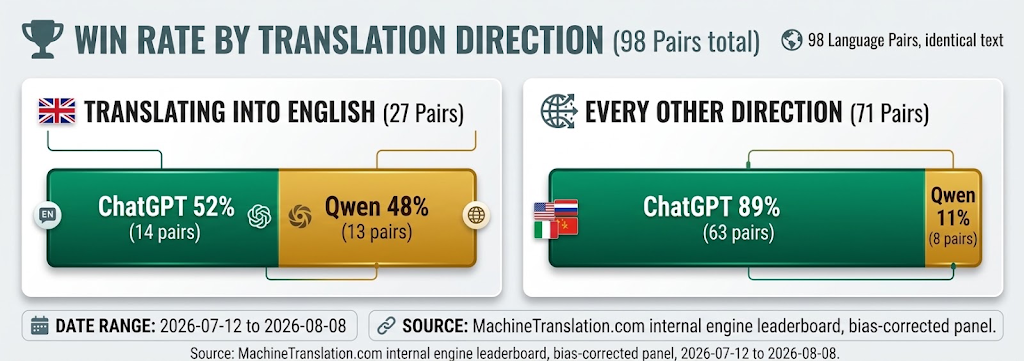
Vers l'anglais, les deux modèles sont presque à égalité. Dans toutes les autres directions, ChatGPT remporte la grande majorité des paires testées.
| ChatGPT | Qwen | |
|---|---|---|
| Percent of output scored | 54.76% | 42.6% |
| Average score | 8.89 / 10 | 8.87 / 10 |
| 10 % des scores les plus bas | 7.8 | 7.6 |
| Taux de victoire, vers l'anglais | 52% | 48% |
| Taux de victoire, toutes les autres directions | 89% | 11% |
Pourquoi l'écart disparaît-il presque lors de la traduction vers l'anglais ?
Les données montrent où se produit le clivage, pas pourquoi. Ce qui est clair, c'est que la compétitivité de Qwen n'est pas répartie de manière uniforme. Sur 27 paires où la langue cible est l'anglais, Qwen en remporte 13, ce qui équivaut essentiellement à un pile ou face. Sur les 71 paires restantes, qu'il s'agisse de traductions depuis l'anglais ou entre deux langues autres que l'anglais, ChatGPT en remporte 63, soit 89 % d'entre elles. Une équipe qui supposerait que les performances de Qwen vers l'anglais s'étendent aux traductions sortantes ou entre paires non anglaises tirerait la mauvaise leçon de la mauvaise direction.
Qwen est-elle une entreprise chinoise, et cela a-t-il une importance pour la traduction ?
Qwen est développé par Alibaba Cloud, entreprise basée en Chine. En soi, cela ne change en rien la qualité de traduction d'une phrase donnée par le modèle ; les données ci-dessus reflètent la qualité réelle des résultats, quel que soit l'endroit où le modèle a été conçu. Là où cela peut avoir de l'importance, c'est sur le traitement des données : les entreprises qui traduisent des contenus réglementés ou sensibles (contrats, dossiers médicaux, informations personnelles) doivent considérer la question du lieu de traitement et de stockage de ces données par un fournisseur d'IA comme un véritable élément de diligence raisonnable, distinct de la qualité de la traduction elle-même. Cela s'applique à n'importe quel fournisseur d'IA, et pas uniquement à Qwen, et c'est en partie pourquoi MachineTranslation.com publie directement ses propres pratiques de sécurité et de traitement des données plutôt que de laisser la question sans réponse.
L'un de ces modèles est-il plus fiable pour la traduction juridique et commerciale ?
Pas de manière constante, et la divergence ne se résume pas toujours au modèle qui obtient le meilleur score. Les tests menés par MachineTranslation.com sur des textes contractuels réels ont mis en évidence deux cas distincts qu'il convient de connaître avant de faire confiance à l'un ou l'autre modèle pour des textes juridiques. Le langage idiomatique prend parfois la direction opposée : un test comparatif direct distinct a montré que ChatGPT traduisait une expression idiomatique allemande de manière littérale et incorrecte, tandis que Qwen en trouvait le sens idiomatique correct, rappelant ainsi que l'avantage global d'un modèle dans les données agrégées ne se vérifie pas phrase par phrase.
| Cas de test | ChatGPT | Qwen |
|---|---|---|
| « At-will employment » vers l'allemand | Formulation utilisable et fonctionnelle | A fait appel à un concept juridique sans rapport |
| Clause de limitation de responsabilité vers l'espagnol | « que surjan de » | « derivados de » (différence modifiant la portée) |
| « Ich verstehe nur Bahnhof » (expression idiomatique allemande) | Traduit littéralement, incorrect | Sens idiomatique correct |
Aucun des deux modèles ne l'emporte systématiquement sur ces trois cas : le score global d'un modèle ne permet pas de prédire son comportement sur un terme ou une expression en particulier. C'est également la raison pour laquelle les textes juridiques et contractuels bénéficient d'une étape de vérification humaine, quel que soit le modèle ayant produit le premier jet.
Qu'en est-il de la couverture linguistique ?
Ni ChatGPT ni Qwen ne publient de liste vérifiée et confirmée de manière indépendante des paires de langues pour lesquelles la qualité de la traduction se dégrade. Tous deux sont des modèles polyvalents dotés d'un vaste entraînement multilingue, ce qui est une affirmation bien différente de performances de traduction mesurées sur un ensemble précis de langues. MachineTranslation.com teste et évalue directement la qualité de traduction sur plus de 330 langues, plutôt que de se fier aux capacités linguistiques générales d'un modèle pour préjuger de la qualité réelle de ses traductions.
Que ne devriez-vous pas coller dans ChatGPT ou Qwen pour de la traduction professionnelle ?
Ni ChatGPT ni Qwen n'ont été conçus comme des plateformes de traduction dédiées, et coller du contenu professionnel sensible directement dans une interface de chat polyvalente soulève les mêmes questions relatives au traitement des données que n'importe quel autre outil d'IA grand public : où les données saisies sont traitées, si elles sont conservées et qui peut y avoir accès. Les contrats, les dossiers médicaux, les documents d'immigration et les états financiers constituent précisément le type de contenu pour lequel il convient de répondre à cette question avant de traduire, et non après. C'est une réelle raison pour laquelle une plateforme de traduction dédiée, dotée de pratiques publiées et vérifiables en matière de traitement des données, représente une proposition bien différente d'une interface de chat généraliste, quel que soit le modèle sous-jacent.
Comment MachineTranslation.com utilise concrètement les deux modèles
MachineTranslation.com exécute ChatGPT, Qwen et plus de 20 autres modèles d'IA sur chaque traduction, puis met en avant la version sur laquelle ces modèles s'accordent le plus. Compte tenu de la nette divergence des performances de Qwen et de ChatGPT selon la direction de traduction, choisir un modèle unique par défaut systématique reviendrait à faire le mauvais choix sur une part prévisible de paires de langues. Cette même tendance dépendante de la direction apparaît dans la comparaison Qwen vs DeepSeek de MachineTranslation.com. Pour obtenir une vue d'ensemble de la manière dont les modèles actuels sont évalués les uns par rapport aux autres, consultez les tests comparatifs complets de modèles de MachineTranslation.com.
Foire aux questions
1. Qwen ou ChatGPT est-il meilleur pour la traduction ?
Sur 98 paires de langues testées à partir d'un texte source identique, ChatGPT a obtenu de meilleurs résultats sur 77 d'entre elles. La performance la plus remarquable de Qwen concerne la traduction vers l'anglais, où les deux modèles sont presque à égalité. Dans toutes les autres directions, ChatGPT l'emporte sur la grande majorité des paires ; la réponse la plus honnête dépend donc fortement du sens de traduction du contenu.
2. ChatGPT ou Qwen prend-il en charge davantage de langues ?
Tous deux sont des modèles d'IA polyvalents ne disposant pas d'une liste vérifiée et publiée de limitations spécifiques à chaque langue. Aucun des deux ne publie de données confirmées de manière indépendante sur la couverture des paires de langues, à la différence d'une plateforme qui teste et évalue directement la qualité de traduction sur plus de 330 langues, plutôt que de se reposer sur des affirmations d'ordre général concernant l'entraînement multilingue.
3. Qwen ou ChatGPT est-il meilleur pour la traduction juridique et commerciale ?
Aucun des deux n'est systématiquement meilleur dans tous les cas. Lors du test d'un terme de droit du travail allemand, DeepSeek et ChatGPT ont produit une formulation fonctionnelle et exploitable, tandis que Claude et Qwen ont tous deux fait appel à un concept juridique sans rapport, ce qui prouve que la divergence dépend du terme et du contexte, et non du modèle considéré comme généralement le plus performant.
4. MachineTranslation.com est-il en concurrence avec ChatGPT et Qwen ?
Non. MachineTranslation.com exécute ChatGPT, Qwen et plus de 20 autres modèles d'IA sur chaque traduction et propose la version sur laquelle ces modèles s'accordent le plus. Il teste et combine des modèles de ce type plutôt que d'agir comme un modèle distinct et concurrent.
5. Quel modèle choisir pour un grand projet de localisation ?
Aucun des deux ne constitue à lui seul un choix par défaut sûr dès lors que le contenu circule entre de nombreuses langues dans les deux sens. L'écart lié au sens de traduction documenté ici signifie qu'un modèle performant pour traduire vers l'anglais peut afficher des performances très différentes lorsqu'il traduit depuis l'anglais, et ce sur des dizaines de paires de langues à la fois.
6. Quel modèle Qwen est le meilleur pour la traduction ?
Cette information n'est pas encore disponible. Le suivi de MachineTranslation.com enregistre actuellement Qwen comme un moteur unique sans étiquette de version de modèle, contrairement à d'autres fournisseurs, de sorte qu'il n'existe pas de données de qualité par sous-version à communiquer. Une fois ce point résolu, une véritable analyse comparative entre Qwen3.8-Max et Qwen3.8-27B sera possible ; pour l'instant, il s'agit d'une réelle lacune, et pas seulement d'un détail non mesuré.