October 2, 2026
Qwen vs Grok : Quel modèle d'IA traduit le mieux ?
Qwen et Grok sont tous deux des modèles d'IA à usage général, et non des outils spécifiques à la traduction, et font tous deux partie du pool de modèles que MachineTranslation.com exécute à chaque traduction. C'est important pour comprendre ce qui suit. Il s'agit d'un aperçu des performances de deux des propres modèles de la plateforme l'un par rapport à l'autre, avec les véritables réserves qui accompagnent ce type de données, et non d'une compétition entre deux concurrents externes et la plateforme elle-même.
Que sont Qwen et Grok ?
Qwen est la famille de grands modèles de langage d'Alibaba, actuellement à sa génération Qwen3.8, et a été ajoutée au pool de modèles de MachineTranslation.com dans le cadre de l'expansion continue de la plateforme. Grok est la gamme de modèles de xAI, actuellement à la version Grok 4.7 au moment où nous écrivons ces lignes, ayant connu plusieurs versions depuis celle comparée initialement dans cet article, et a rejoint la plateforme séparément. Aucun des deux modèles n'a été conçu spécifiquement pour la traduction. Tous deux sont des systèmes à usage général qui se trouvent traiter de nombreuses langues dans le cadre d'une capacité linguistique plus large, ce qui constitue un point de départ différent d'une plateforme construite et testée spécifiquement autour de la qualité de traduction.
Comment Qwen et Grok se comparent-ils sur les propres données de MachineTranslation.com ?
Au cours des 28 derniers jours de trafic sur la plateforme, Grok a obtenu un score moyen plus élevé que Qwen : 9.26 sur 10 contre 8.87. Les 10 % de traductions de Grok ayant obtenu les scores les plus bas ont tout de même atteint une moyenne de 9.2, tandis que les 10 % de Qwen ont chuté à 7.6, un écart plus important dans le bas du classement que ce que la moyenne seule laisse supposer.
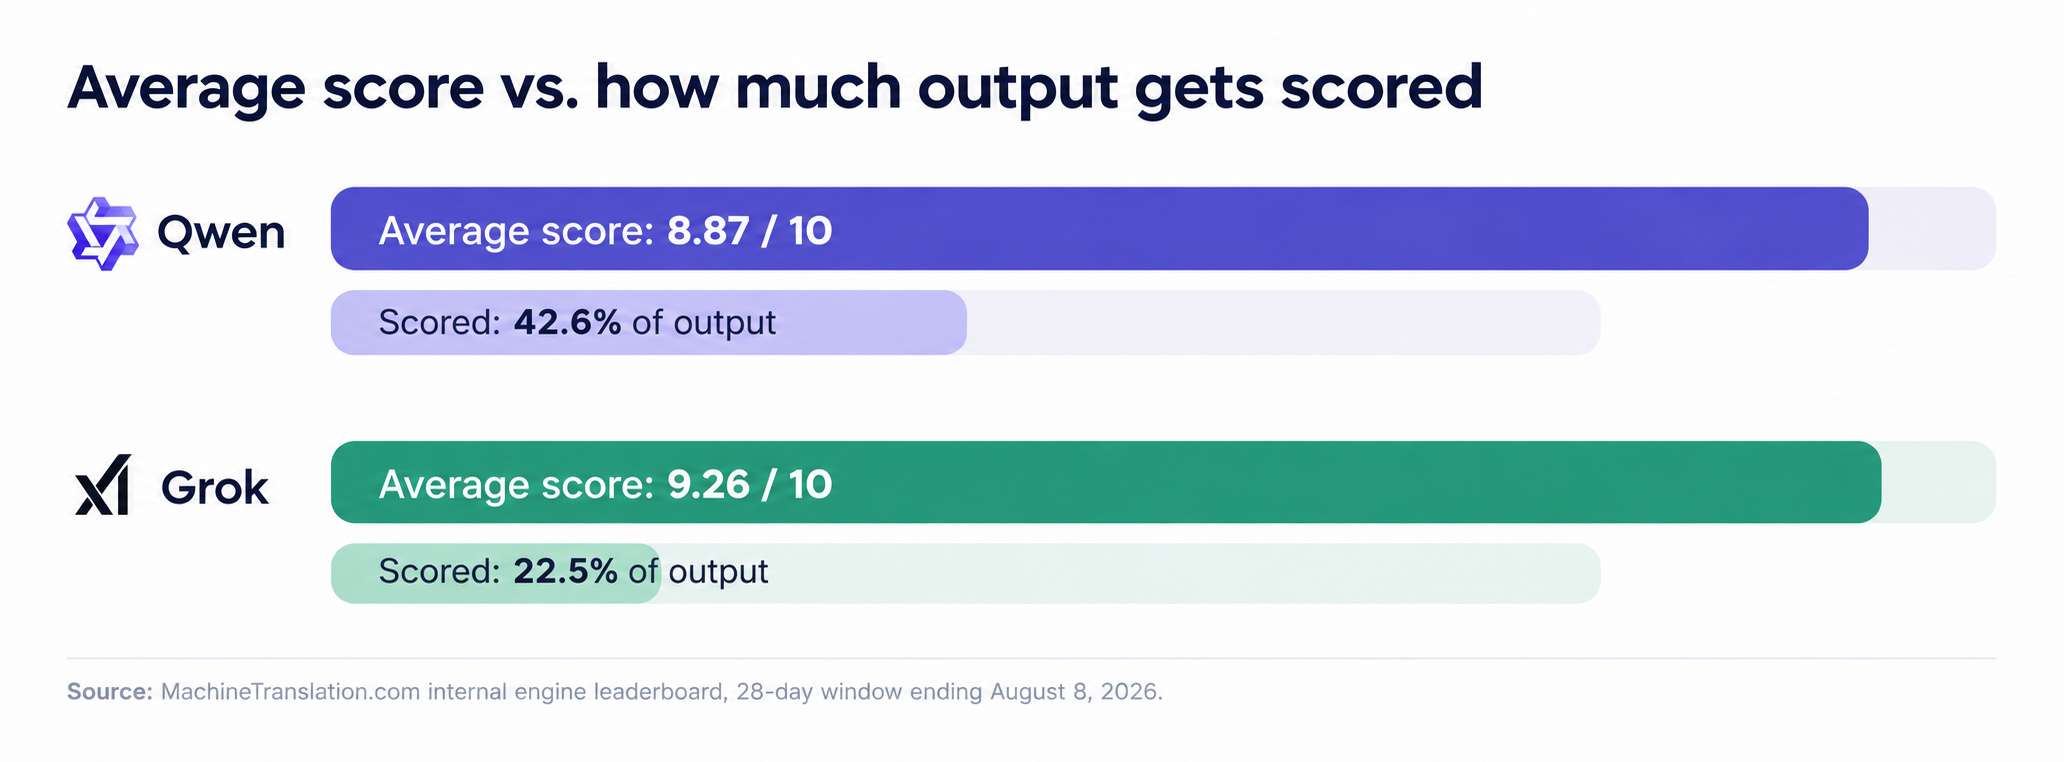
Le score moyen de Grok est plus élevé, mais il repose sur l'évaluation de moins d'un quart de sa production, contre près de la moitié pour Qwen. Les deux barres racontent différentes parties de la même histoire.
| Qwen | Grok | |
|---|---|---|
| Pourcentage de la production évaluée | 42.6% | 22.5% |
| Score moyen | 8.87 / 10 | 9.26 / 10 |
| Les 10 % des scores les plus bas | 7.6 | 9.2 |
Source : Classement interne des moteurs de MachineTranslation.com, période de 28 jours se terminant le August 8, 2026.
Le score plus élevé de Grok signifie-t-il que c'est le meilleur choix ?
Pas en soi. Grok est utilisé beaucoup moins souvent que Qwen sur la plateforme, et moins d'un quart de ses traductions sont évaluées, contre près de la moitié de celles de Qwen. Un échantillon plus petit et moins représentatif peut faire paraître une moyenne meilleure ou pire qu'elle ne le serait sur le même volume traité par Qwen. Le propre rapport de MachineTranslation.com sur ces données considère la couverture d'évaluation comme une véritable limite, et non comme une note de bas de page : un moteur évalué sur une étroite fraction de son trafic n'a pas été testé aussi rigoureusement qu'un moteur évalué sur près de la moitié de sa production.
En toute honnêteté, les chiffres de Grok sont prometteurs mais moins étoffés. Ceux de Qwen sont plus bas en moyenne, mais reposent sur une base beaucoup plus large et plus représentative. Aucun de ces faits n'annule l'autre.
Qu'en est-il de la couverture linguistique ?
Ni Qwen ni Grok ne publient de liste vérifiée des paires de langues pour lesquelles les performances chutent, et il n'existe aucun test indépendant pour le confirmer. Ce que l'on peut affirmer avec certitude, c'est qu'aucun de ces deux modèles n'a été conçu spécifiquement pour la qualité de traduction sur un ensemble de langues donné, comme le fait une plateforme de traduction dédiée. MachineTranslation.com teste et prend en charge directement plus de 270 langues, ce qui constitue un argument bien différent de la vaste capacité multilingue, mais non testée, d'un modèle généraliste.
Comment MachineTranslation.com utilise réellement Qwen et Grok
MachineTranslation.com exécute Qwen, Grok et plus de 20 autres modèles d'IA sur chaque traduction, puis met en avant la version sur laquelle ces modèles s'accordent le plus. Aucun de ces modèles n'est exclu s'il obtient un score moyen inférieur. L'exécution simultanée de plusieurs modèles permet de repérer les cas où un modèle avec un score moyen inférieur parvient tout de même à traduire correctement une phrase spécifique qui échappe à un modèle mieux noté. Les performances de Qwen varient également selon le sens et la paire de langues, des nuances qu'il est utile de connaître avant de choisir un seul modèle, et qui sont abordées plus en détail dans la comparaison Qwen contre DeepSeek de MachineTranslation.com. Pour en savoir plus sur la façon dont les modèles sont directement comparés et testés les uns par rapport aux autres, consultez les tests complets de comparaison de modèles de MachineTranslation.com.
Foire aux questions
1. Qwen ou Grok est-il meilleur pour la traduction ?
Selon les propres données des moteurs de MachineTranslation.com sur 28 jours, Grok obtient en moyenne un score plus élevé que Qwen, 9.26 contre 8.87 sur 10. Mais le score de Grok est calculé sur une fraction beaucoup plus petite et moins représentative de sa production, ce n'est donc pas une véritable comparaison directe parfaite comme le serait un test sur des segments appariés.
2. Pourquoi Grok a-t-il un score moyen plus élevé mais moins de traductions évaluées ?
Grok est moins souvent utilisé sur la plateforme et seulement environ 22.5% de sa production est évaluée, contre 42.6% pour Qwen. Un échantillon plus petit et moins représentatif peut gonfler ou minimiser une moyenne, c'est pourquoi cette comparaison doit être interprétée comme étant indicative, et non définitive.
3. Qwen ou Grok prend-il en charge plus de langues ?
Les deux sont des modèles d'IA à usage général sans liste publiée et vérifiée de limitations spécifiques aux langues. Aucun des deux n'est conçu spécifiquement pour la traduction, ce qui diffère d'une plateforme qui teste et évalue directement la qualité de la traduction dans 270+ langues, plutôt que de s'appuyer sur un vaste entraînement multilingue comme substitut à des performances de traduction mesurées.
4. MachineTranslation.com est-il en concurrence avec Qwen et Grok ?
Non. MachineTranslation.com exécute Qwen, Grok et plus de 20 autres modèles d'IA sur chaque traduction et fait ressortir la version sur laquelle ces modèles sont le plus d'accord. La plateforme teste et combine de tels modèles plutôt que de les concurrencer en tant que modèle distinct à part entière.
5. Quel modèle d'IA MachineTranslation.com recommande-t-il pour la traduction ?
Aucun par défaut. Les différents modèles affichent des performances différentes selon la paire de langues et le type de contenu, et l'écart entre eux peut pencher dans un sens ou dans l'autre en fonction de ce qui est traduit. Cette variation est précisément la raison pour laquelle la plateforme exécute plusieurs modèles sur chaque traduction au lieu d'en choisir un seul comme recommandation permanente.