May 8, 2026
Grok vs. Claude untuk penerjemahan: apa yang ditunjukkan oleh benchmark (2026)
Grok (xAI) dan Claude (Anthropic) sama-sama merupakan alat penerjemahan AI yang mumpuni, tetapi keduanya memiliki keunggulan yang berbeda secara struktural. Untuk sebagian besar tugas penerjemahan umum, Anda tidak akan menyadari perbedaan yang signifikan di antaranya. Untuk dua skenario spesifik (menerjemahkan konten tentang peristiwa terkini, dan menerjemahkan dokumen formal yang membutuhkan presisi), perbedaannya nyata dan didasarkan pada bagaimana masing-masing model dibuat.
Artikel ini membahas apa yang sebenarnya ditawarkan oleh masing-masing model untuk penerjemahan, di mana benchmark independen menempatkannya, dan apa yang harus digunakan ketika hasil dari salah satu model saja tidak cukup.
Bagaimana perbandingan Grok dan Claude dalam hal kualitas terjemahan?
Jawaban singkatnya: Claude memimpin dalam tolok ukur penerjemahan profesional independen. Keunggulan spesifik Grok adalah akses pengetahuan real-time, bukan kualitas penerjemahan secara keseluruhan.
Dalam benchmark internal MachineTranslation.com, Claude (tier 3.5 Sonnet) meraih skor 93.8 dari 100 untuk kualitas penerjemahan — gabungan antara akurasi, terminologi, dan gaya bahasa. Grok tidak muncul dalam 14 solusi teratas dalam State of Translation Automation 2025 dari Intento, yang mengevaluasi 46 mesin MT dan LLM di 11 pasangan bahasa. Claude Opus 4 dan Claude Sonnet 3.7 keduanya muncul di 14 besar. Sumber: Benchmark internal MachineTranslation.com; Intento State of Translation Automation 2025.
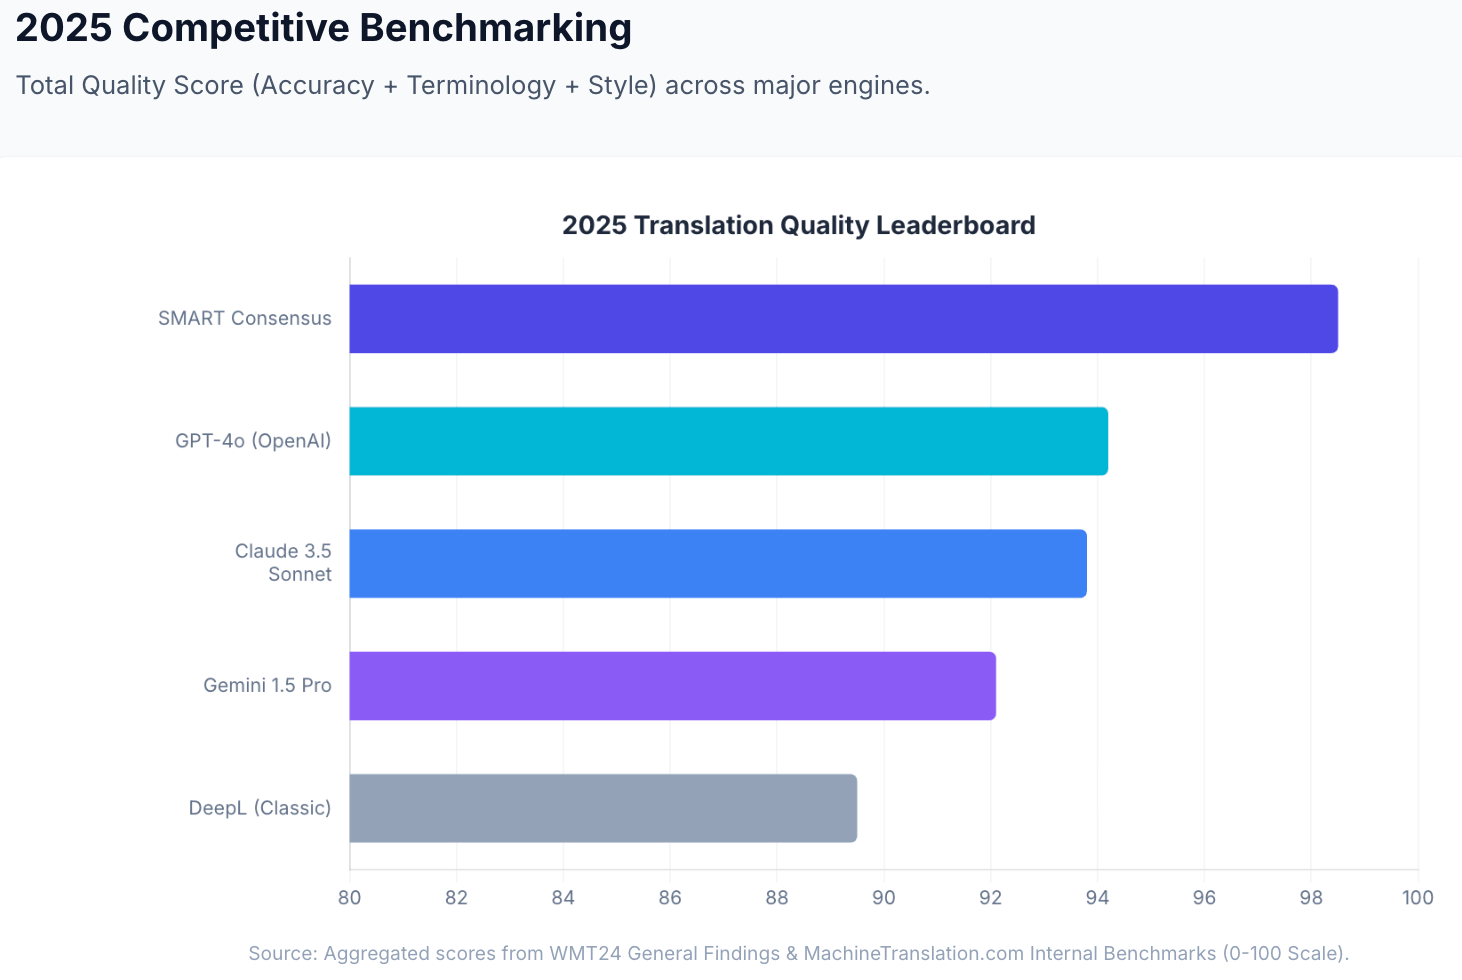
Di WMT24 (kompetisi benchmark independen utama industri penerjemahan), Claude 3.5 menempati peringkat pertama dalam 9 dari 11 pasangan bahasa, mengungguli GPT-4 dan mesin neural MT khusus. Dalam studi buta Lokalise tahun 2025 oleh penerjemah profesional, 78% terjemahan Claude 3.5 dinilai baik — yang tertinggi dari semua LLM yang diuji.
Grok belum dievaluasi dalam WMT24 atau evaluasi LQA independen Intento pada tingkat yang sebanding. The Slator Pro Guide (2025) mencantumkan Grok sebagai salah satu LLM serbaguna yang digunakan untuk penerjemahan di lingkungan profesional, bersama GPT dan Claude, tetapi tidak memeringkatnya di atas keduanya.
| Benchmark | Grok | Claude |
|---|---|---|
| Skor kualitas internal MachineTranslation.com | Tidak diukur pada tingkat benchmark | 93.8/100 (tingkat 3.5 Sonnet) |
| 14 solusi teratas Intento 2025 | Tidak terdaftar | Claude Opus 4, Sonnet 3.7 keduanya terdaftar |
| Pasangan bahasa WMT24 | Tidak dievaluasi | Peringkat 1 dalam 9/11 pasangan bahasa |
| Studi buta Lokalise 2025 | Tidak dievaluasi | 78% baik (tertinggi dari LLM mana pun) |
Sumber: Benchmark internal MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Di mana Grok memiliki keunggulan nyata?
Terjemahan real-time dan peristiwa terkini. Karakteristik arsitektur penentu Grok adalah integrasinya dengan data platform X (sebelumnya Twitter) dan pencarian internet langsung. Tidak seperti Claude dan sebagian besar LLMs lainnya, yang dilatih pada dataset statis dengan batas pengetahuan yang tetap, Grok memasukkan informasi real-time ke dalam output-nya. Untuk tugas penerjemahan yang melibatkan peristiwa terkini, produk yang baru dirilis, terminologi politik yang baru muncul, berita saat ini, atau konten yang merujuk pada hal-hal yang terjadi dalam beberapa minggu terakhir, Grok memiliki akses ke konteks yang tidak dimiliki oleh Claude.
Ini sangat penting khususnya untuk: menerjemahkan artikel berita tentang peristiwa terkini, melokalkan pengumuman produk untuk pasar yang bergerak cepat, menangani terminologi atau slang yang baru dibuat yang muncul setelah data pelatihan model lainnya, dan konten apa pun yang maknanya bergantung pada pengetahuan tentang apa yang terjadi baru-baru ini.
Terminologi yang baru muncul dan berkembang. Bidang teknis, industri, dan konteks budaya terus-menerus menghasilkan terminologi baru. Untuk tugas penerjemahan yang melibatkan istilah-istilah yang baru dibuat, bahasa regulasi baru, atau nomenklatur produk baru, pelatihan Grok yang diperbarui dan pencarian real-time memberinya akses ke pola penggunaan yang tidak ditangkap oleh snapshot data pelatihan yang lebih lama.
Jendela konteks dan penalaran Grok 4.1. Grok 4.1 (per akhir 2025) memiliki context window 131K-token dan kemampuan penalaran yang ditingkatkan, menjadikannya mampu menangani dokumen yang kompleks dan berlapis-lapis di mana hubungan klausa dan koherensi logis sangat penting.
Di mana Claude memiliki keunggulan nyata?
Kualitas terjemahan pada benchmark independen. Keunggulan Claude didokumentasikan oleh evaluasi profesional independen, alih-alih klaim yang dilaporkan sendiri. WMT24 menempatkan Claude 3.5 di peringkat pertama dalam 9 dari 11 pasangan bahasa di antara seluruh pesaing. Studi buta Lokalise tahun 2025 menemukan bahwa penerjemah profesional lebih menyukai output Claude 3.5 dengan tingkat baik sebesar 78% — lebih tinggi daripada GPT-4, DeepL, dan Google Translate dalam evaluasi yang sama. Ini adalah evaluasi blind: penerjemah profesional menilai output tanpa mengetahui model mana yang menghasilkannya.
Pasangan bahasa spesifik per Intento 2025. Claude Opus 4 dan Sonnet 3.7 masuk dalam kategori terbaik untuk Inggris ke Jerman, Inggris ke Jepang, Inggris ke Italia, Inggris ke Korea, Inggris ke Belanda, Inggris ke Arab, dan Inggris ke Prancis dalam evaluasi LQA manusia Intento. Untuk pasangan-pasangan ini, Claude adalah pilihan terdokumentasi yang lebih kuat di antara keduanya.
Presisi nada dan konten yang bernuansa. Penerjemah profesional dalam studi Lokalise lebih menyukai output Claude pada tingkat tertinggi dibandingkan LLM mana pun — mencerminkan kekuatan Claude yang terdokumentasi dalam mempertahankan register, suara penulis, dan makna kontekstual. Untuk penerjemahan sastra, dokumen hukum, komunikasi formal, dan teks pemasaran di mana cara sesuatu disampaikan sama pentingnya dengan apa yang disampaikan, Claude secara konsisten berkinerja baik di berbagai evaluasi independen.
Koherensi dokumen panjang. Claude 4.6 Sonnet mendukung context window 200K token, dengan Claude Opus 4.6 mendukung 1M token dalam beta. Untuk dokumen formal yang panjang (kontrak, manual teknis, laporan uji klinis), Claude dapat memproses seluruh dokumen dalam satu proses, menjaga konsistensi terminologi di seluruh dokumen. Dokumen yang diproses dalam bentuk fragmen menunjukkan tingkat ketidakkonsistenan terminologi yang 28% lebih tinggi dibandingkan dengan pemesinan dokumen secara utuh. Sumber: Data internal MachineTranslation.com.
Bagaimana perbandingan keduanya dalam hal dukungan bahasa dan harga?
Dukungan bahasa: Baik Grok 4.1 maupun Claude 4.6 mendukung penerjemahan di sebagian besar bahasa utama dunia. Claude telah dievaluasi secara independen di berbagai pasangan bahasa Eropa dan Asia Timur dengan hasil yang kuat. Dukungan multibahasa Grok telah meningkat dari versi ke versi. Untuk bahasa bersumber daya rendah, kualitas kedua model menurun — peninjauan oleh manusia tepat untuk konten dalam pasangan bahasa bersumber daya rendah terlepas dari model mana yang digunakan.
Harga:
| Paket | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Konsumen (bulanan) | SuperGrok: $30/bulan | Claude Pro: $20/bulan |
| Input API (per M token) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Output API (per M token) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Tingkat gratis | Ya (dibatasi laju penggunaan melalui X/Grok.com) | Ya (dibatasi laju penggunaan melalui claude.ai) |
Pada tingkat konsumen, Claude Pro ($20/month) is cheaper than SuperGrok ($30/bulan). Pada tingkat API, Grok 4.1 memiliki sedikit keunggulan biaya dibandingkan Claude Sonnet 4.6 untuk alur kerja penerjemahan yang padat input.
Mana yang lebih baik untuk jenis konten tertentu?
| Jenis konten | Model yang direkomendasikan | Alasan |
|---|---|---|
| Berita terbaru / peristiwa terkini | Grok | Akses data real-time; model yang dilatih secara statis kekurangan konteks terkini |
| Terminologi baru / peluncuran produk baru | Grok | Integrasi pencarian langsung menangkap pola penggunaan terbaru |
| Dokumen hukum formal | Claude | Evaluasi independen WMT24 dan Lokalise 2025; presisi nada |
| Konten medis / klinis | Claude | Kedudukan tolok ukur independen; pemeliharaan register |
| Teks pemasaran / konten kreatif | Claude | Preferensi studi buta Lokalise 2025; nuansa nada |
| Dokumentasi teknis (panjang) | Claude | Jendela konteks 200K-1M; konsistensi terminologi di seluruh panjang teks |
| Media sosial / konten percakapan | Mana saja | Keduanya menangani pasangan percakapan bersumber daya tinggi dengan baik |
| Integrasi pengembang / API | Mana saja | Keduanya menawarkan akses API; Grok sedikit lebih murah untuk token input |
Apa yang digunakan ketika satu model tidak cukup
Baik Grok maupun Claude adalah alat model tunggal. Setiap model AI individu (terlepas dari seberapa mampunya) menghasilkan kesalahan yang tidak dapat dideteksinya dalam output-nya sendiri. Terjemahan yang lancar dan meyakinkan dari Grok maupun Claude masih bisa salah secara semantik, dan tanpa pemeriksaan silang tidak ada cara untuk mengetahuinya.
Baik Grok maupun Claude termasuk di antara 22 model dalam sistem SMART MachineTranslation.com. SMART menjalankan semua 22 model secara bersamaan (termasuk Grok dan Claude) dan mengembalikan output yang disetujui oleh mayoritas.
Apa artinya ini bagi pertanyaan Grok vs. Claude: Kekuatan real-time Grok dan kedalaman kontekstual Claude keduanya berkontribusi pada konsensus yang sama. Ketika mereka sepakat, kesepakatan tersebut merupakan sinyal kualitas yang kuat.
Dalam tolok ukur internal MachineTranslation.com, masing-masing model tingkat atas meraih skor 93-94 dari 100 untuk kualitas terjemahan. Output konsensus SMART mencapai 98.5/100. Sumber: Benchmark internal MachineTranslation.com dan Temuan Penerjemahan Mesin Umum WMT24.
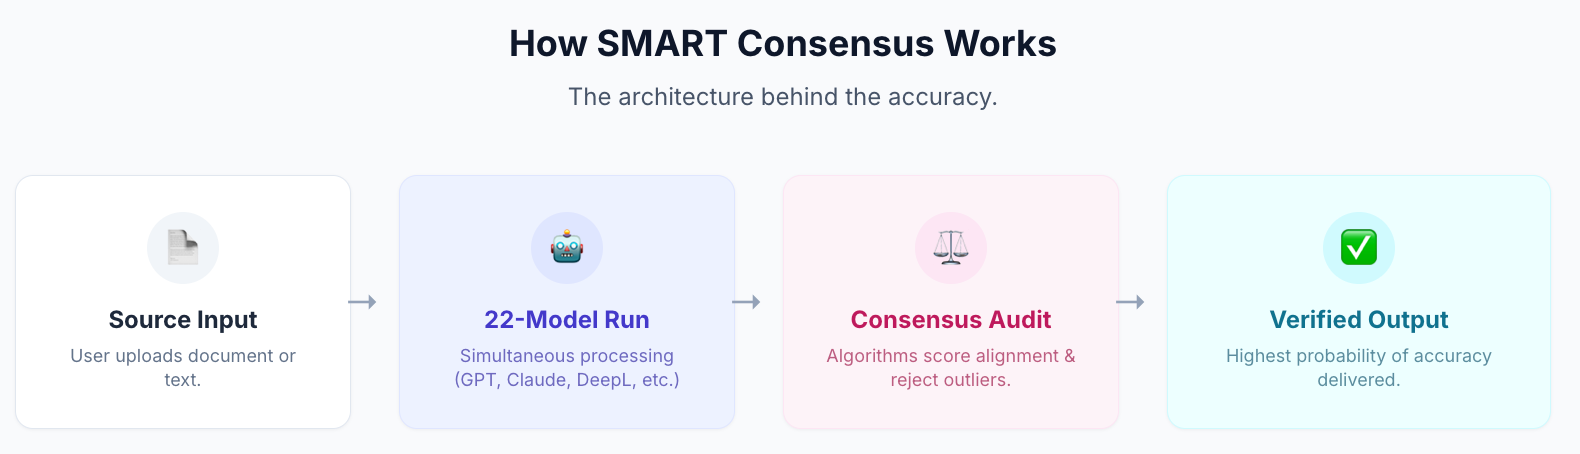
Pengguna yang beralih dari penerjemahan mesin tunggal ke SMART menghabiskan waktu 27% lebih sedikit untuk memverifikasi dan mengoreksi output. Sumber: Data internal MachineTranslation.com.
Untuk konten berisiko tinggi (dokumen hukum, pengajuan regulasi, instruksi medis), Human Verification mengeskalasi konsensus SMART ke peninjau profesional bersertifikasi di dalam platform yang sama. Tidak ada agensi eksternal. Akurasi 100% dijamin.
Terjemahkan dengan Grok, Claude, dan 20 model lainnya di MachineTranslation.com — gratis, tidak perlu mendaftar.
Pertanyaan yang sering diajukan
1. Apakah Grok lebih baik daripada Claude untuk penerjemahan?
Untuk sebagian besar tugas penerjemahan standar, Claude memimpin dalam benchmark independen: pertama dalam 9 dari 11 pasangan bahasa di WMT24, rating baik sebesar 78% dalam blind study Lokalise 2025, dan 93.8/100 dalam benchmark kualitas internal MachineTranslation.com. Keunggulan spesifik Grok adalah untuk konten yang membutuhkan pengetahuan tentang peristiwa terkini, akses data real-time miliknya memberikan konteks yang tidak dimiliki oleh model yang dilatih secara statis termasuk Claude. Untuk berita terbaru, terminologi yang baru muncul, dan konten yang sensitif terhadap waktu, Grok adalah pilihan yang lebih kuat.
2. Apa keunggulan Grok dibandingkan Claude untuk penerjemahan?
Grok mengintegrasikan data real-time dari X (sebelumnya Twitter) dan pencarian internet langsung. Tidak seperti Claude dan sebagian besar LLMs lainnya yang dilatih pada dataset statis, Grok dapat mengakses informasi tentang peristiwa terkini, terminologi yang baru diciptakan, dan konteks saat ini saat menghasilkan terjemahan. Hal ini membuatnya secara khusus lebih kuat untuk menerjemahkan konten berita, produk yang baru saja dirilis, dan materi apa pun yang maknanya bergantung pada peristiwa atau pola bahasa dari beberapa minggu terakhir.
3. Apa keunggulan Claude dibandingkan Grok untuk penerjemahan?
Keunggulan Claude didokumentasikan melalui evaluasi profesional independen. Claude 3.5 menempati peringkat pertama dalam 9 dari 11 pasangan bahasa di WMT24, dan penerjemah profesional dalam studi buta Lokalise tahun 2025 lebih menyukai output-nya dengan tingkat baik sebesar 78% — yang tertinggi dari semua LLM yang diuji. Claude juga muncul dalam 14 solusi teratas Intento di berbagai pasangan bahasa dalam evaluasi LQA manusia, sementara Grok tidak. Untuk tugas penerjemahan yang formal, profesional, dan berisiko tinggi, posisi tolok ukur independen Claude adalah pembeda yang terdokumentasi.
4. Mana yang lebih baik untuk penerjemahan hukum, Grok atau Claude?
Claude adalah pilihan yang lebih kuat untuk penerjemahan hukum berdasarkan evaluasi independen. Claude 3.5 menempati peringkat pertama di sebagian besar pasangan bahasa Eropa bersumber daya tinggi pada WMT24 dan menerima peringkat preferensi studi buta tertinggi dari penerjemah profesional. Untuk konten hukum yang memerlukan akurasi tersertifikasi, kedua model saja tidak cukup — Human Verification dari MachineTranslation.com memberikan akurasi 100% dari peninjau profesional tersertifikasi di dalam platform yang sama, tidak memerlukan vendor eksternal.
5. Apakah Grok dan Claude tersedia di MachineTranslation.com?
Ya. Keduanya termasuk di antara 22 model dalam sistem SMART MachineTranslation.com. Setiap terjemahan SMART menjalankan Grok, Claude, dan 20 model lainnya secara bersamaan, mengembalikan output yang disetujui oleh mayoritas. Alih-alih memilih di antara mereka, Anda menerima konsensus dari semua model AI.
6. Bagaimana perbandingan harga antara Grok dan Claude?
Pada tingkat konsumen, Claude Pro seharga $20/month versus SuperGrok at $30/bulan. Pada tingkat API, Grok 4.1 sedikit lebih murah untuk token input ($2/M vs. $3/M untuk Claude Sonnet 4.6) dan output ($10/M vs. $15/M). Paket gratis MachineTranslation.com mencakup kedua model sebagai bagian dari konsensus 22 model SMART, tanpa perlu mendaftar.
7. Model AI mana yang terbaik untuk menerjemahkan artikel berita?
Untuk menerjemahkan artikel berita, Grok memiliki keunggulan struktural: integrasi data real-time miliknya berarti ia memiliki konteks terkini tentang peristiwa yang sedang dijelaskan, yang mungkin tidak dimiliki oleh model yang dilatih secara statis. Untuk penerjemahan berita umum di mana kemutakhiran tidak krusial, performa benchmark Claude lebih kuat. Untuk penerjemahan berita bervolume tinggi di mana kebaruan dan akurasi sangat penting, SMART dari MachineTranslation.com menjalankan kedua model dan memberikan output konsensus keduanya.