October 9, 2026
Qwen vs ChatGPT: Model AI mana yang menerjemahkan lebih baik?
Generasi ChatGPT saat ini dan Qwen keduanya merupakan bagian dari kumpulan model yang dijalankan MachineTranslation.com pada setiap penerjemahan, bukan dua penantang dari luar yang dinilai terhadap platform itu sendiri. Jalankan teks yang sama melalui keduanya pada segmen yang identik, dan ChatGPT memenangkan sebagian besar pasangan bahasa secara keseluruhan. Jika hasilnya dibagi berdasarkan arah terjemahan, perbedaannya menyempit tajam di satu area spesifik: penerjemahan ke dalam bahasa Inggris, di mana keduanya hampir seimbang.
Apakah ada AI yang lebih baik daripada ChatGPT untuk penerjemahan?
Minat umum terhadap alternatif ChatGPT telah meningkat seiring dengan peningkatan model-model pesaing, meskipun alasannya sangat bervariasi menurut kasus penggunaan dan tidak ada satu penjelasan tunggal. Khusus untuk penerjemahan, pertanyaan yang lebih berguna adalah model mana yang sebenarnya berkinerja lebih baik pada pasangan bahasa tertentu, sebuah pertanyaan yang dapat diuji secara objektif alih-alih sekadar masalah sentimen.
Selama 28 hari terakhir lalu lintas MachineTranslation.com, kedua model menerjemahkan teks sumber yang identik di 98 pasangan bahasa. ChatGPT memperoleh skor lebih tinggi di 77 pasangan tersebut; Qwen memperoleh skor lebih tinggi di 21 pasangan. Rata-rata tertimbang di seluruh output yang cocok menempatkan ChatGPT pada 9.10 dari 10 dan Qwen pada 8.98, sebuah selisih rata-rata yang nyata namun tipis, yang menyembunyikan perbedaan yang jauh lebih tajam setelah faktor arah terjemahan diperhitungkan.
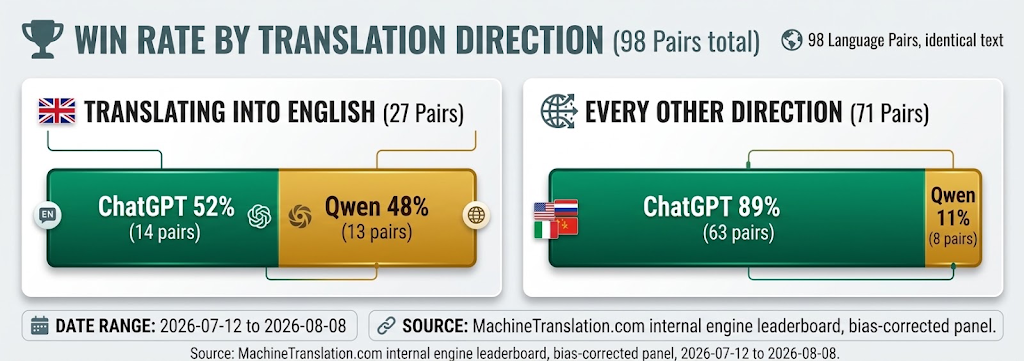
Ke dalam bahasa Inggris, kedua model hampir seimbang. Di setiap arah lainnya, ChatGPT memenangkan sebagian besar pasangan bahasa yang diuji.
| ChatGPT | Qwen | |
|---|---|---|
| Persentase output yang dinilai | 54.76% | 42.6% |
| Skor rata-rata | 8.89 / 10 | 8.87 / 10 |
| 10% skor terendah | 7.8 | 7.6 |
| Tingkat kemenangan, ke bahasa Inggris | 52% | 48% |
| Tingkat kemenangan, semua arah lainnya | 89% | 11% |
Mengapa kesenjangan tersebut hampir menghilang saat menerjemahkan ke bahasa Inggris?
Data tersebut menunjukkan di mana perbedaan ini terjadi, bukan penyebabnya. Hal yang jelas adalah daya saing Qwen tidak tersebar secara merata. Dari 27 pasangan bahasa dengan bahasa target bahasa Inggris, Qwen memenangkan 13 di antaranya, yang pada dasarnya berimbang seperti lemparan koin. Dari 71 pasangan yang tersisa, baik yang menerjemahkan dari bahasa Inggris maupun antar dua bahasa non-Inggris, ChatGPT memenangkan 63 pasangan, atau 89% di antaranya. Tim yang berasumsi bahwa performa Qwen dalam menerjemahkan ke bahasa Inggris akan terbawa ke penerjemahan dari bahasa Inggris atau pasangan non-Inggris akan menarik kesimpulan yang salah dari arah yang keliru.
Apakah Qwen merupakan perusahaan Tiongkok, dan apakah hal tersebut berpengaruh terhadap penerjemahan?
Qwen dikembangkan oleh Alibaba Cloud, yang berbasis di Tiongkok. Secara tersendiri, hal tersebut tidak mengubah seberapa baik model ini menerjemahkan kalimat tertentu; data di atas mencerminkan kualitas output aktual di mana pun model tersebut dibuat. Hal yang dapat berpengaruh adalah penanganan data: bisnis yang menerjemahkan konten yang diatur oleh regulasi atau sensitif (kontrak, rekam medis, informasi pribadi) harus memperlakukan pertanyaan mengenai di mana penyedia AI memproses dan menyimpan konten tersebut sebagai aspek uji tuntas (due diligence) yang nyata, terpisah dari kualitas terjemahan itu sendiri. Hal ini berlaku untuk penyedia AI mana pun, bukan khusus untuk Qwen, dan ini menjadi salah satu alasan mengapa MachineTranslation.com memublikasikan praktik penanganan data dan keamanannya sendiri secara langsung alih-alih membiarkan pertanyaan tersebut tidak terjawab.
Apakah salah satu model lebih andal untuk penerjemahan hukum dan bisnis?
Tidak secara konsisten, dan perbedaannya tidak selalu mengenai model mana yang memperoleh skor lebih tinggi. Pengujian MachineTranslation.com terhadap bahasa kontrak nyata menemukan dua kasus terpisah yang perlu diketahui sebelum memercayai salah satu model untuk teks hukum. Bahasa idiomatik terkadang menunjukkan hal sebaliknya: pengujian head-to-head terpisah menemukan bahwa ChatGPT menerjemahkan idiom bahasa Jerman secara harfiah dan salah, sementara Qwen menemukan makna idiomatik yang tepat—sebuah pengingat bahwa keunggulan keseluruhan suatu model dalam data agregat tidak selalu berlaku kalimat demi kalimat.
| Kasus uji | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" ke dalam bahasa Jerman | Frasa yang fungsional dan dapat digunakan | Menggunakan konsep hukum yang tidak berkaitan |
| Klausul pembatasan tanggung jawab ke dalam bahasa Spanyol | "que surjan de" | "derivados de" (perbedaan yang mengubah cakupan) |
| "Ich verstehe nur Bahnhof" (idiom bahasa Jerman) | Diterjemahkan secara harfiah, tidak tepat | Makna idiomatik yang tepat |
Tidak ada model yang menang secara konsisten di ketiga kasus ini: skor agregat dari satu model tidak memprediksi performanya pada suatu istilah atau frasa spesifik tertentu. Hal ini juga menjadi alasan mengapa teks hukum dan kontrak memerlukan langkah verifikasi manusia, terlepas dari model mana yang membuat draf pertamanya.
Bagaimana dengan cakupan bahasa?
Baik ChatGPT maupun Qwen tidak memublikasikan daftar pasangan bahasa yang terverifikasi dan terkonfirmasi secara independen tempat kualitas terjemahannya menurun. Keduanya merupakan model serbaguna dengan pelatihan multibahasa yang luas, yang merupakan klaim berbeda dibandingkan kinerja penerjemahan terukur di seluruh rangkaian bahasa tertentu. MachineTranslation.com menguji dan menilai kualitas terjemahan di 330+ bahasa secara langsung, alih-alih mengandalkan kemampuan bahasa umum suatu model sebagai tolok ukur seberapa baik model tersebut benar-benar menerjemahkan.
Apa yang sebaiknya tidak Anda tempelkan ke ChatGPT atau Qwen untuk penerjemahan bisnis?
Baik ChatGPT maupun Qwen tidak dibangun sebagai platform penerjemahan khusus, dan menempelkan konten bisnis yang sensitif secara langsung ke dalam antarmuka obrolan serbaguna menimbulkan pertanyaan penanganan data yang sama seperti menempelkannya ke alat AI konsumen lainnya: di mana input diproses, apakah input tersebut disimpan, dan siapa yang dapat mengaksesnya. Kontrak, rekam medis, dokumen imigrasi, dan laporan keuangan adalah jenis konten yang pertanyaannya patut dijawab sebelum menerjemahkan, bukan sesudahnya. Ini adalah alasan nyata mengapa platform penerjemahan khusus dengan praktik penanganan data yang terpublikasi dan dapat diverifikasi merupakan tawaran yang berbeda dari antarmuka obrolan serbaguna, terlepas dari model apa pun yang mendasarinya.
Bagaimana MachineTranslation.com sebenarnya menggunakan kedua model tersebut
MachineTranslation.com menjalankan ChatGPT, Qwen, dan lebih dari 20 model AI lainnya pada setiap terjemahan, lalu memunculkan versi yang paling disepakati oleh model-model tersebut. Mengingat betapa tajamnya perbedaan kinerja Qwen dan ChatGPT berdasarkan arah terjemahan, memilih satu model sebagai default tetap berarti salah menebak pada sebagian pasangan bahasa yang dapat diprediksi. Pola yang bergantung pada arah yang sama juga muncul dalam perbandingan Qwen vs DeepSeek dari MachineTranslation.com. Untuk gambaran lengkap tentang bagaimana model-model terkini diuji satu sama lain, lihat pengujian perbandingan model lengkap dari MachineTranslation.com.
Pertanyaan yang sering diajukan
1. Apakah Qwen atau ChatGPT lebih baik untuk penerjemahan?
Di 98 pasangan bahasa yang diuji pada teks sumber yang identik, ChatGPT memperoleh skor lebih tinggi pada 77 di antaranya. Penampilan terkuat Qwen adalah saat menerjemahkan ke dalam bahasa Inggris, di mana keduanya hampir seimbang. Di setiap arah lainnya, ChatGPT memenangkan sebagian besar pasangan bahasa, sehingga jawaban jujurnya sangat bergantung pada ke arah mana konten tersebut diterjemahkan.
2. Apakah ChatGPT atau Qwen mendukung lebih banyak bahasa?
Keduanya merupakan model AI serbaguna tanpa daftar batasan khusus bahasa yang terverifikasi dan dipublikasikan. Tidak ada satu pun yang memublikasikan data cakupan pasangan bahasa yang terkonfirmasi secara independen, yang berbeda dari platform yang menguji dan menilai kualitas terjemahan di 330+ bahasa secara langsung, alih-alih mengandalkan klaim umum tentang pelatihan multibahasa.
3. Apakah Qwen atau ChatGPT lebih baik untuk penerjemahan hukum dan bisnis?
Keduanya tidak dapat diandalkan lebih baik secara menyeluruh. Saat menguji istilah hukum ketenagakerjaan bahasa Jerman, DeepSeek dan ChatGPT menghasilkan ungkapan fungsional yang dapat digunakan sementara Claude dan Qwen sama-sama memunculkan konsep hukum yang tidak terkait, menunjukkan bahwa perbedaan kinerja bergantung pada istilah dan konteks, bukan pada model mana yang secara umum lebih kuat.
4. Apakah MachineTranslation.com bersaing dengan ChatGPT dan Qwen?
Tidak. MachineTranslation.com menjalankan ChatGPT, Qwen, dan lebih dari 20 model AI lainnya pada setiap terjemahan dan memunculkan versi yang paling disepakati oleh model-model tersebut. Platform ini menguji dan menggabungkan model-model seperti ini alih-alih bertindak sebagai model terpisah yang bersaing sendiri.
5. Model mana yang harus saya pilih untuk proyek lokalisasi skala besar?
Tidak ada satu pun dari keduanya yang menjadi pilihan default yang aman begitu konten bergerak melintasi banyak bahasa di kedua arah. Perbedaan berdasarkan arah yang didokumentasikan di sini berarti model yang berkinerja baik saat menerjemahkan ke dalam bahasa Inggris dapat berkinerja sangat berbeda saat menerjemahkan dari bahasa tersebut, di puluhan pasangan bahasa sekaligus.
6. Model Qwen mana yang terbaik untuk penerjemahan?
Data ini belum tersedia. Pelacakan MachineTranslation.com saat ini mencatat Qwen sebagai satu mesin tunggal tanpa tag versi model, tidak seperti penyedia lainnya, sehingga data kualitas per sub-versi belum tersedia untuk dilaporkan. Setelah hal tersebut diperbaiki, perincian nyata antara Qwen3.8-Max dan Qwen3.8-27B akan dimungkinkan; untuk saat ini, ini merupakan celah nyata, bukan sekadar detail yang belum diukur.