November 13, 2026
Qwen vs Gemini untuk penerjemahan dan alasan arah terjemahan penting
Anda memiliki dua model dan daftar pasangan bahasa, dan Anda perlu memutuskan model mana yang dapat dipercaya untuk proyek tersebut. Sebagian besar perbandingan Qwen vs Gemini menjawab dengan satu skor keseluruhan. Menurut saya, satu skor menyembunyikan hal yang menentukan hasilnya, yaitu arah penerjemahan.
Saya menangani cara kami menguji model yang berjalan di MachineTranslation.com, sehingga saya dapat membandingkan Qwen dan Gemini pada 98 pasangan bahasa yang dinilai berdasarkan teks yang identik. Gemini meraih skor lebih tinggi pada 68 pasangan tersebut dan Qwen pada 29 pasangan, serta selisih rata-ratanya adalah 0,08 poin dari skala 10. Angka total saja tidak memberi tahu Anda model mana yang harus dipilih untuk bahasa Urdu ke bahasa Inggris atau untuk bahasa Inggris ke Kreol Haiti.
Artikel ini menunjukkan di mana kedua model bersaing ketat dan di mana masing-masing model unggul. Artikel ini juga menyampaikan apa yang belum dapat saya beri tahu kepada Anda. Data saya berakhir pada 8 Agustus 2026, sebelum Google mengumumkan Gemini 4 pada bulan Oktober, sehingga data ini menggambarkan versi yang lebih lama dari kedua model.
Poin penting
- Di seluruh 98 pasangan bahasa yang dinilai berdasarkan teks yang identik (12 Juli hingga 8 Agustus 2026), Gemini meraih skor lebih tinggi di 68 pasangan, Qwen di 29 pasangan, dan satu pasangan seri.
- Selisih rata-ratanya kecil, 9,06 untuk Gemini berbanding 8,98 untuk Qwen, dan 60 dari 98 pasangan berada dalam rentang 0,1 poin.
- Untuk penerjemahan ke bahasa Inggris, Qwen unggul lebih dari 0,1 poin di 7 dari 27 pasangan dan Gemini di 3 pasangan; 17 pasangan lainnya berada dalam rentang 0,1 poin.
- Untuk penerjemahan dari bahasa Inggris, Gemini unggul lebih dari 0,1 poin di 13 dari 29 pasangan dan Qwen tidak unggul di satu pun pasangan.
- Data ini berakhir sebelum Google mengumumkan Gemini 4 pada Oktober 2026, sehingga data ini menggambarkan versi Gemini sebelumnya dan memerlukan pengujian baru sebelum dianggap mutakhir oleh siapa pun.
Apakah Qwen atau Gemini yang lebih baik untuk penerjemahan?
Hal itu bergantung pada arahnya, karena kedua model bersaing ketat saat bahasa targetnya adalah bahasa Inggris dan Gemini meraih skor lebih tinggi di sebagian besar pasangan lainnya. Di seluruh 98 pasangan, Gemini meraih skor lebih tinggi di 68 pasangan. Dalam skor MachineTranslation.com dari 12 Juli hingga 8 Agustus 2026, Gemini rata-rata meraih 9,06 dari 10 dan Qwen 8,98, selisih rata-rata sebesar 0,08 poin.
Panel ini hanya menghitung segmen di mana ChatGPT, Claude, DeepSeek, Gemini, dan Qwen semuanya menerima skor riil, sehingga setiap model dinilai berdasarkan teks sumber yang identik. Setiap pasangan bahasa memiliki setidaknya 30 segmen. Saya menggunakan panel ini karena cara ini menghilangkan kesalahan umum, yaitu membandingkan model pada teks yang berbeda.
Berdasarkan jumlah, Gemini unggul di 68 pasangan (69%), Qwen di 29 pasangan (30%), dan satu pasangan seri. Jumlah saja melebih-lebihkan selisih tersebut, karena 60 dari 98 pasangan berada dalam rentang 0,1 poin. Bagian berikutnya membagi hasil berdasarkan arah dan margin.
Arah penerjemahan mana yang menguntungkan masing-masing model?
Gemini unggul ketika bahasa Inggris adalah bahasa sumber atau ketika kedua bahasa bukan bahasa Inggris, dan Qwen sejajar dengannya atau unggul ketika bahasa Inggris adalah bahasa target. Dari bahasa Inggris, Gemini unggul lebih dari 0,1 poin di 13 dari 29 pasangan dan Qwen tidak unggul di satu pun pasangan. Ke bahasa Inggris, Qwen memimpin dengan margin tersebut di 7 dari 27 pasangan dan Gemini di 3 pasangan.
| Arah | Pasangan | Gemini unggul lebih dari 0,1 | Dalam rentang 0,1 poin | Qwen unggul lebih dari 0,1 | Selisih rata-rata |
|---|---|---|---|---|---|
| Ke bahasa Inggris | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Dari bahasa Inggris | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Kedua sisi bukan bahasa Inggris | 42 | 14 | 27 | 1 | Gemini +0,13 |
Ke bahasa Inggris, 17 dari 27 pasangan berada dalam rentang 0,1 poin, Qwen unggul dalam 7, dan Gemini unggul dalam 3. Dari bahasa Inggris, 16 dari 29 pasangan berada dalam rentang 0,1 poin, Gemini unggul dalam 13, dan Qwen tidak unggul sama sekali. Jika kedua bahasanya bukan bahasa Inggris, 27 dari 42 berada dalam rentang 0,1 poin, Gemini unggul dalam 14, dan Qwen unggul dalam 1.
Qwen berada dalam rentang 0,1 poin dari Gemini atau unggul dalam 24 dari 27 pasangan ke bahasa Inggris. Jika dirata-ratakan berdasarkan arah, Qwen unggul sekitar 0,04 poin ke bahasa Inggris, sementara Gemini unggul sekitar 0,16 poin dari bahasa Inggris dan 0,13 poin di antara dua bahasa non-Inggris.
Saya tidak tahu mengapa perbedaan ini muncul, dan data ini tidak dapat menjelaskannya kepada saya. Satu penjelasan yang ingin saya uji terlebih dahulu adalah campuran teks pelatihan di balik setiap model, tetapi saya belum menjalankan pengujian tersebut. Qwen menunjukkan pola serupa saat berhadapan dengan ChatGPT. Pada panel yang sama, perbandingan Qwen vs ChatGPT kami menemukan keduanya hampir seimbang ke bahasa Inggris, dengan ChatGPT unggul dalam 89% pasangan lainnya.
Pasangan bahasa mana yang menunjukkan selisih terbesar?
Selisih terbesar menguntungkan Gemini. Model ini unggul sebesar 0,51 hingga 0,95 poin pada bahasa Rusia ke Kazakh, bahasa Inggris ke Kreol Haiti, bahasa Inggris ke Tagalog, bahasa Spanyol ke Yunani, dan bahasa Arab ke Persia. Keunggulan terbesar Qwen lebih kecil, antara 0,15 dan 0,26 poin, dan empat dari lima pasangan teratasnya adalah pasangan ke bahasa Inggris.
| Pasangan bahasa | Skor Gemini | Skor Qwen | Selisih |
|---|---|---|---|
| Rusia ke Kazakh | 9,27 | 8,32 | Gemini +0,95 |
| Inggris ke Kreol Haiti | 9,19 | 8,27 | Gemini +0,92 |
| Inggris ke Tagalog | 9,14 | 8,43 | Gemini +0,70 |
| Spanyol ke Yunani | 8,90 | 8,33 | Gemini +0,57 |
| Arab ke Persia | 8,84 | 8,34 | Gemini +0,51 |
| Urdu ke Inggris | 8,56 | 8,81 | Qwen +0,26 |
| Mandarin ke Inggris | 9,00 | 9,19 | Qwen +0,19 |
| Swedia ke Inggris | 8,29 | 8,46 | Qwen +0,16 |
| Tionghoa ke Indonesia | 9,03 | 9,19 | Qwen +0,16 |
| Burma ke Inggris | 8,94 | 9,09 | Qwen +0,15 |
Saya tidak akan menganggap ini sebagai peringkat akhir. Dua selisih terbesar, Rusia ke Kazakh dan Inggris ke Kreol Haiti, didasarkan pada sampel yang lebih kecil daripada pasangan median. Inggris ke Tagalog, Spanyol ke Yunani, dan Arab ke Persia didasarkan pada sampel yang lebih besar, jadi saya akan lebih memercayai ketiga pasangan tersebut. Saya akan menguji ulang dua selisih dengan sampel yang sedikit tersebut sebelum mengandalkannya.
Apa arti dari selisih 0,1 poin?
Menurut pandangan saya, selisih di bawah 0,1 poin terlalu kecil untuk menentukan pemenang. Dari 98 pasangan tersebut, 60 berada di dalam batas selisih itu, dan setiap pasangan dinilai berdasarkan sejumlah segmen yang terbatas. Batas 0,1 tersebut adalah ambang batas kerja saya sendiri, dan saya belum melakukan uji signifikansi pada pasangan-pasangan ini.
Skor juga melewatkan beberapa perbedaan. Dalam pengujian frasa umum kami, kami menguji kata "sorry" dalam bahasa Arab melalui 22 model AI. Gemini dan Qwen sama-sama memilih bentuk santai آسف. ChatGPT dan hasil gabungan memilih bentuk formal عذرًا. Setiap model memperoleh skor 9,5, jadi kedua kata tersebut berbeda dalam register dan skornya tidak bergeser.
Itulah mengapa saya membaca margin dan contoh register secara bersamaan. Selisih kecil dengan perbedaan register yang terlihat memerlukan keputusan manusia. Selisih besar pada sampel yang tipis membutuhkan pengujian ulang.
Apakah Qwen dan Gemini membuat jenis kesalahan yang berbeda?
Ya, karena dalam pengujian kutipan Piala Dunia 2026 kami, kedua model membuat setidaknya satu pilihan yang tidak diambil oleh model lain, dan skornya hampir tidak berubah. Gemini menerjemahkan frasa Mbappé sebagai "with each game" dan menerjemahkan kutipan Wirtz kata demi kata, sementara Qwen memberikan pemaknaan berbeda terhadap kutipan Scaloni. Skor untuk kasus-kasus ini berkisar antara 9,2 hingga 9,5.
Rinciannya berasal dari pengujian kutipan Piala Dunia kami. Pada kutipan Mbappé tentang memandang ke depan, model-model lain tetap menggunakan "match" sementara Gemini menulis "with each game", sebuah kekeliruan kecil dalam register yang mendapatkan skor 9,4. Pada kutipan Wirtz, Gemini menerjemahkan sebuah frasa kata demi kata dan mengubah maknanya, juga dengan skor 9,4. Pada kutipan Scaloni, sebagian besar model sepakat pada satu pemaknaan sementara Qwen menulis "that is what matters" dan memperoleh skor 9,4. Pada kutipan taktis Mbappé, Claude dan DeepSeek memilih bahasa Inggris sepak bola Britania sementara Gemini, Qwen, dan lainnya memilih bahasa Inggris Amerika, dan Qwen memperoleh skor 9,2, lebih rendah daripada yang lainnya.
Saya memandang hal ini sebagai kebiasaan-kebiasaan kecil. Contoh dari Gemini berkaitan dengan register dan pemilihan frasa secara harfiah. Contoh dari Qwen berkaitan dengan pilihan pemaknaan kalimat yang diambil. Empat contoh terlalu sedikit untuk disebut sebagai pola, tetapi contoh-contoh tersebut menunjukkan jenis perbedaan yang disembunyikan oleh satu skor tunggal.
Model Qwen manakah yang terbaik untuk penerjemahan?
Saya tidak dapat memastikannya dari data kami, karena skor MachineTranslation.com memperlakukan Qwen sebagai satu model tanpa label versi. Dari Alibaba, keluarga Qwen3.8 hadir di Hugging Face pada Agustus 2026, sehingga beberapa versi kini telah ada, dan skor dalam artikel ini tidak memisahkannya.
Saya ingin membaginya berdasarkan versi, dan saat ini saya belum bisa melakukannya. Angka di tingkat platform mungkin merupakan rata-rata dari lebih dari satu versi Qwen yang berjalan selama periode tersebut. Jika Anda memilih di antara versi-versi Qwen untuk suatu proyek, saya sarankan untuk membandingkannya pada sampel teks Anda sendiri.
Apa saja alternatif selain Gemini untuk penerjemahan?
ChatGPT, Claude, DeepSeek, Qwen, Grok, dan Mistral AI semuanya berjalan di MachineTranslation.com, dan alternatif yang tepat bergantung pada pasangan bahasanya. Dalam skor kami dari 12 Juli hingga 8 Agustus 2026, Qwen berada dalam kisaran 0,1 poin dari Gemini atau lebih unggul dalam 24 dari 27 pasangan bahasa ke bahasa Inggris. Skor Mistral AI untuk bahasa Prancis kami menunjukkan rata-rata bahasa Prancis ke bahasa Inggrisnya berada 0,40 poin di atas Gemini.
Jika alternatif Anda adalah ChatGPT, jawabannya juga terbagi berdasarkan pasangan bahasa. Dalam rincian bahasa Spanyol ke bahasa Inggris yang kami terbitkan, Gemini memenangkan 31% segmen dan ChatGPT memenangkan 21%. Pada bahasa Prancis, tidak ada model yang menang di kedua arah. Karena pilihannya berubah-ubah sesuai pasangan bahasa, MachineTranslation.com tidak memilih satu alternatif saja. Platform ini menjalankannya secara bersamaan.
Saran saya adalah memulai dari pasangan bahasa dan arahnya, lalu melihat alternatif mana yang cocok.
Bagaimana MachineTranslation.com menunjukkan letak ketidaksepakatan antara Qwen dan Gemini?
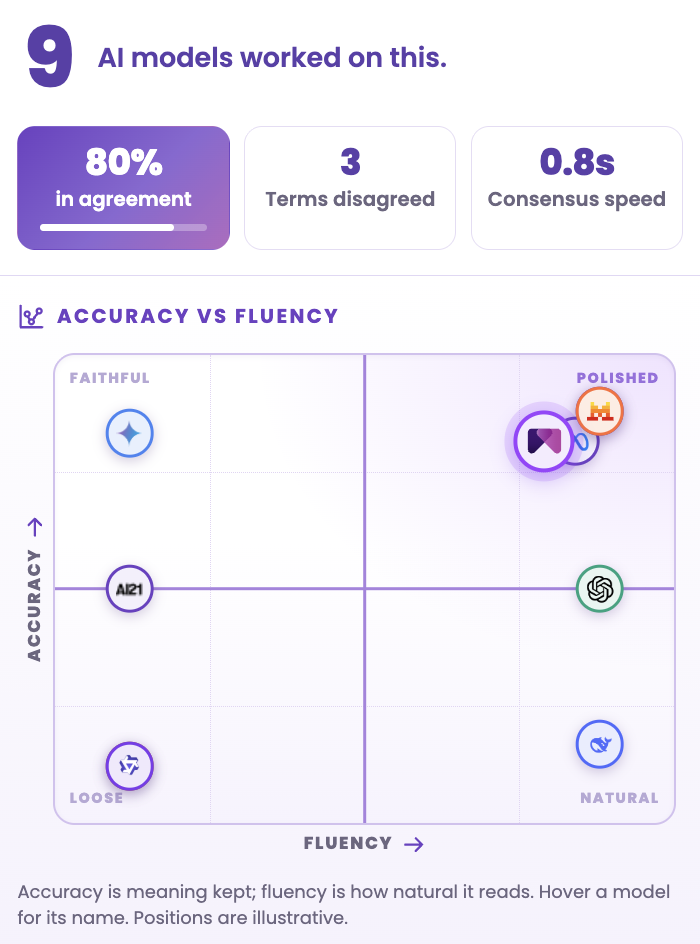
MachineTranslation.com menjalankan kedua model pada setiap penerjemahan dan menunjukkan letak model-model tersebut sepakat dan di mana mereka berbeda. Panel kesepakatan melaporkan berapa banyak model AI yang memproses teks tersebut, persentase yang sepakat, berapa banyak istilah yang diperdebatkan, dan seberapa cepat konsensus terbentuk.
Seberapa mutakhir hasil-hasil ini?
Hasil-hasil ini mencakup 12 Juli hingga 8 Agustus 2026, jadi angka tersebut menggambarkan versi Gemini dan Qwen yang berjalan pada saat itu. Google mengumumkan Gemini 4 pada Oktober 2026. Lini Qwen3.8 milik Alibaba hadir pada Agustus 2026. Rekomendasi saya adalah menjalankan kembali panel tersebut sebelum mengandalkan angka-angka ini untuk proyek baru.
Saya memperkirakan metode perbandingan teks identik dengan batas toleransi noise akan tetap berlaku. Saya memperkirakan besaran selisihnya akan berubah. Saya akan menganggap setiap pasangan yang pemimpinnya berbalik pada pengujian baru sebagai tanda bahwa selisih sebelumnya masih berada dalam batas noise.
Bagaimana saya memilih antara Qwen dan Gemini untuk sebuah proyek?
Pandangan saya adalah memilih berdasarkan pasangan dan arah bahasa serta menghindari memilih satu kali untuk keseluruhan proyek. Dalam praktiknya, itu berarti memperlakukan selisih di bawah 0,1 poin sebagai hasil imbang dan memperkirakan model yang memimpin akan berubah antarpasangan. Inilah urutan yang akan saya ikuti.
- Buat daftar setiap pasangan bahasa dalam proyek dan tandai arahnya.
- Periksa selisih untuk setiap pasangan di artikel ini. Anggap selisih di bawah 0,1 poin sebagai hasil imbang.
- Jika selisihnya lebih besar, mulailah dengan model yang unggul dan uji sampel teks Anda sendiri.
- Jika konten Anda bergerak di kedua arah, perkirakan model yang unggul akan berganti antarpasangan.
- Periksa kembali ketika salah satu model merilis versi baru.
Kedua model berjalan bersama 20 model lainnya di setiap penerjemahan di MachineTranslation.com. Versi yang disepakati oleh sebagian besar model akan ditampilkan, sehingga pilihannya tidak harus dibuat sekali untuk seluruh proyek. Kumpulan lengkap hasil model tersedia dalam pengujian perbandingan model kami.
Pertanyaan yang sering diajukan
1. Apakah Qwen atau Gemini lebih baik untuk penerjemahan?
Hal ini bergantung pada arahnya, karena Qwen berada dalam rentang 0,1 poin dari Gemini atau lebih unggul dalam 24 dari 27 pasangan ke bahasa Inggris. Gemini masih memperoleh skor lebih tinggi dalam 68 dari 98 pasangan dalam skor July 12 to August 8, 2026 dari MachineTranslation.com. Rata-rata selisihnya adalah 0,08 poin dari 10, jadi saya akan memilih berdasarkan pasangan.
2. Model Qwen mana yang terbaik untuk penerjemahan?
Saya tidak dapat memastikannya dari data kami, karena skor MachineTranslation.com memperlakukan Qwen sebagai satu model tanpa label versi. Rangkaian Qwen3.8 dari Alibaba hadir di Hugging Face pada August 2026, sehingga kini ada beberapa versi. Sampai skor memisahkannya, saya akan membandingkan versi-versi tersebut pada sampel teks Anda sendiri sebelum memilih salah satu untuk sebuah proyek.
3. Apa saja alternatif untuk Gemini dalam penerjemahan?
ChatGPT, Claude, DeepSeek, Qwen, Grok, dan Mistral AI semuanya berjalan di MachineTranslation.com. Dalam skor July 12 to August 8, 2026 kami, Qwen berada dalam rentang 0,1 poin dari Gemini atau lebih unggul dalam 24 dari 27 pasangan ke bahasa Inggris. Rata-rata bahasa Prancis ke bahasa Inggris milik Mistral AI berada 0,40 poin di atas milik Gemini. Alternatif yang tepat bergantung pada pasangannya.
4. Apakah Gemini lebih baik daripada ChatGPT untuk penerjemahan?
Hal ini bergantung pada pasangan bahasa, karena tidak ada satu pun model AI yang menang di semua aspek. Dalam rincian bahasa Spanyol ke bahasa Inggris yang kami publikasikan, Gemini memenangkan 31% segmen dan ChatGPT memenangkan 21%. Pada bahasa Prancis, tidak ada model yang menang di kedua arah. Saya akan memeriksa pasangan dan arah yang Anda butuhkan sebelum memilih di antara keduanya.
5. Apakah Gemini akurat untuk penerjemahan?
Ya, karena Gemini memperoleh rata-rata 9,06 dari 10 di seluruh 98 pasangan bahasa dalam skor MachineTranslation.com periode 12 Juli hingga 8 Agustus 2026. Akurasi tetap bervariasi berdasarkan pasangan bahasa. Keunggulannya paling besar dari bahasa Inggris, dan Qwen mengunggulinya lebih dari 0,1 poin pada 7 dari 27 pasangan ke bahasa Inggris.