October 2, 2026
Qwen vs Grok: Model AI mana yang menerjemahkan lebih baik?
Qwen dan Grok keduanya merupakan model AI serbaguna, bukan alat khusus terjemahan, dan keduanya adalah bagian dari kumpulan model yang dijalankan MachineTranslation.com pada setiap terjemahan. Hal ini penting untuk dipahami saat membaca ulasan berikut. Ini adalah tinjauan tentang bagaimana performa dua model milik platform ini bersaing satu sama lain, dengan peringatan nyata yang menyertai data semacam itu, bukan sebuah kontes antara dua penantang dari luar dan platform itu sendiri.
Apa itu Qwen dan Grok?
Qwen adalah keluarga model bahasa besar dari Alibaba, yang saat ini berada pada generasi Qwen3.8, dan ditambahkan ke dalam kumpulan model MachineTranslation.com sebagai bagian dari ekspansi platform yang berkelanjutan. Grok adalah lini model milik xAI, yang saat ini berada pada versi Grok 4.7 saat artikel ini ditulis, setelah melalui beberapa rilis sejak versi yang pertama kali dibandingkan dalam artikel ini, dan bergabung dengan platform secara terpisah. Tak satu pun dari kedua model ini dibangun khusus untuk terjemahan. Keduanya adalah sistem serbaguna yang kebetulan dapat menangani banyak bahasa sebagai bagian dari kemampuan bahasa yang lebih luas, yang mana ini merupakan titik awal yang berbeda dibandingkan dengan platform yang dibangun dan diuji secara khusus untuk kualitas terjemahan.
Bagaimana perbandingan Qwen dan Grok pada data milik MachineTranslation.com sendiri?
Selama 28 hari terakhir dari lalu lintas platform, Grok mencetak skor rata-rata yang lebih tinggi daripada Qwen: 9.26 dari 10 berbanding 8.87. Sebanyak 10% terjemahan Grok dengan skor terburuk masih memiliki rata-rata 9.2, sementara 10% skor terburuk Qwen turun menjadi 7.6, sebuah kesenjangan yang lebih lebar di batas bawah daripada yang ditunjukkan oleh skor rata-ratanya saja.
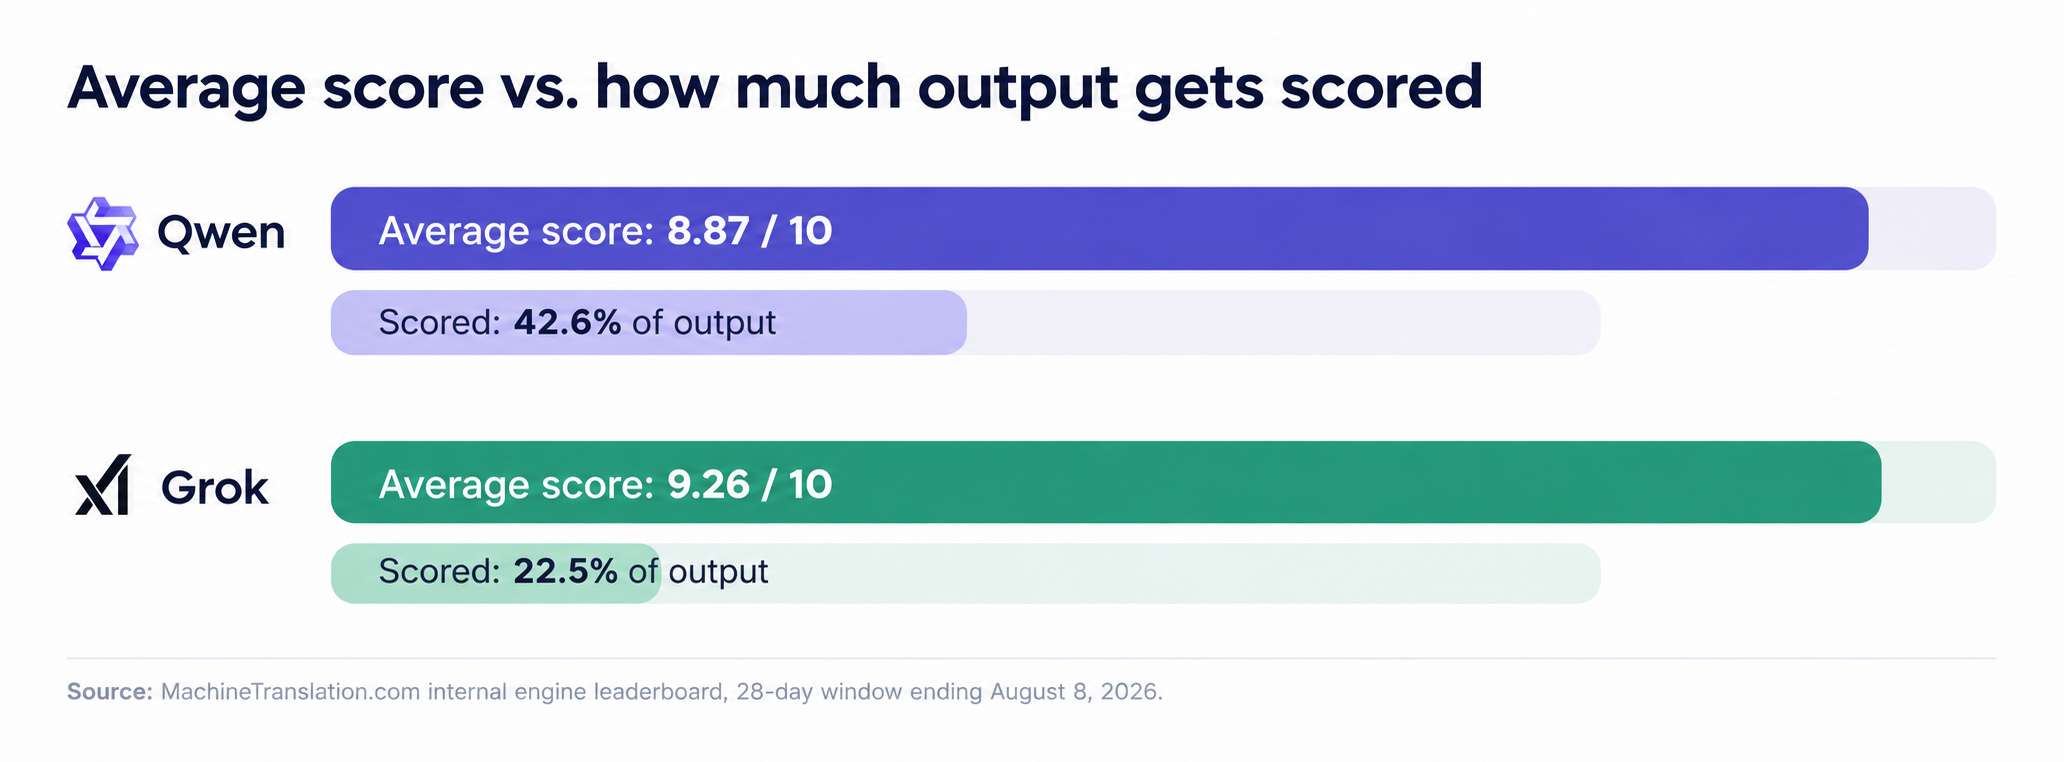
Skor rata-rata Grok lebih tinggi, tetapi ini didasarkan pada penilaian kurang dari seperempat hasil keluarannya, berbanding dengan hampir setengahnya untuk Qwen. Kedua diagram batang tersebut menceritakan bagian yang berbeda dari cerita yang sama.
| Qwen | Grok | |
|---|---|---|
| Persentase keluaran yang dinilai | 42.6% | 22.5% |
| Skor rata-rata | 8.87 / 10 | 9.26 / 10 |
| 10% skor terbawah | 7.6 | 9.2 |
Sumber: Papan peringkat mesin internal MachineTranslation.com, periode 28 hari yang berakhir pada 8 Agustus 2026.
Apakah skor Grok yang lebih tinggi berarti ia adalah pilihan yang lebih baik?
Tidak semata-mata demikian. Grok jauh lebih jarang digunakan di platform ini dibandingkan Qwen, dan kurang dari seperempat terjemahannya yang mendapatkan skor, berbanding dengan hampir separuh dari milik Qwen. Sampel yang lebih kecil dan kurang representatif dapat membuat rata-rata terlihat lebih baik atau lebih buruk daripada jika dinilai pada volume yang sama seperti yang ditangani Qwen. Pelaporan MachineTranslation.com sendiri pada data ini memperlakukan cakupan penilaian sebagai batasan yang nyata, bukan sekadar catatan kaki: sebuah mesin yang dinilai pada sebagian kecil lalu lintasnya belum diuji secara menyeluruh seperti mesin yang dinilai pada hampir separuh hasil keluarannya.
Pembacaan yang jujur adalah bahwa angka-angka Grok memang menjanjikan tetapi lebih tipis. Angka Qwen rata-rata lebih rendah namun didasarkan pada basis yang jauh lebih besar dan lebih representatif. Kedua fakta ini tidak saling meniadakan.
Bagaimana dengan cakupan bahasanya?
Baik Qwen maupun Grok tidak menerbitkan daftar pasangan bahasa terverifikasi di mana kinerjanya menurun, dan tidak ada pengujian independen untuk mengonfirmasinya. Hal yang dapat disampaikan dengan penuh keyakinan adalah bahwa kedua model ini tidak dibangun khusus untuk kualitas terjemahan pada sekumpulan bahasa tertentu seperti halnya sebuah platform terjemahan khusus. MachineTranslation.com menguji dan mendukung lebih dari 270 bahasa secara langsung, yang mana merupakan klaim yang berbeda dibandingkan dengan kemampuan multibahasa dari model serbaguna yang luas namun belum teruji.
Bagaimana MachineTranslation.com sebenarnya menggunakan Qwen dan Grok
MachineTranslation.com menjalankan Qwen, Grok, dan lebih dari 20 model AI lainnya pada setiap terjemahan, kemudian menampilkan versi yang paling disepakati oleh model-model tersebut. Tidak satu pun model yang dikecualikan hanya karena memiliki skor rata-rata yang lebih rendah. Menjalankan banyak model secara bersamaan berarti menangkap kasus-kasus di mana model dengan skor rata-rata lebih rendah tetap dapat menerjemahkan kalimat tertentu dengan benar sementara model dengan skor lebih tinggi justru keliru. Kinerja Qwen juga terbagi berdasarkan arah dan pasangan bahasa dengan cara yang patut diketahui sebelum memilih satu model, yang dibahas lebih mendalam dalam perbandingan Qwen vs DeepSeek dari MachineTranslation.com. Untuk melihat lebih dekat bagaimana model-model ini diuji secara langsung satu sama lain, lihat pengujian perbandingan model lengkap dari MachineTranslation.com.
Pertanyaan yang sering diajukan
1. Apakah Qwen atau Grok lebih baik untuk terjemahan?
Pada data mesin 28 hari milik MachineTranslation.com sendiri, rata-rata skor Grok lebih tinggi daripada Qwen, 9.26 berbanding 8.87 dari 10. Namun Grok dinilai pada porsi output yang jauh lebih kecil dan kurang representatif, sehingga ini bukanlah perbandingan langsung yang sepadan sebagaimana layaknya pengujian segmen yang setara.
2. Mengapa Grok memiliki skor rata-rata yang lebih tinggi tetapi terjemahan yang dinilai lebih sedikit?
Grok lebih jarang digunakan di platform ini dan hanya sekitar 22.5% dari outputnya yang dinilai, berbanding 42.6% untuk Qwen. Sampel yang lebih kecil dan kurang representatif dapat melambungkan atau merendahkan nilai rata-rata, itulah sebabnya perbandingan ini harus dibaca sebagai indikasi, bukan kesimpulan pasti.
3. Apakah Qwen atau Grok mendukung lebih banyak bahasa?
Keduanya merupakan model AI serbaguna tanpa daftar batasan bahasa tertentu yang diverifikasi dan dipublikasikan. Tidak satu pun yang dibangun secara khusus untuk terjemahan, hal ini berbeda dengan platform yang secara langsung menguji dan menilai kualitas terjemahan di 270+ bahasa, alih-alih mengandalkan pelatihan multibahasa yang luas sebagai pengganti kinerja terjemahan yang terukur.
4. Apakah MachineTranslation.com bersaing dengan Qwen dan Grok?
Tidak. MachineTranslation.com menjalankan Qwen, Grok, dan lebih dari 20 model AI lainnya pada setiap terjemahan lalu menampilkan versi yang paling disepakati oleh model-model tersebut. Platform ini menguji dan menggabungkan model-model seperti ini, alih-alih bersaing melawannya sebagai model tersendiri.
5. Model AI manakah yang direkomendasikan oleh MachineTranslation.com untuk terjemahan?
Secara bawaan tidak ada. Performa berbagai model berbeda-beda berdasarkan pasangan bahasa dan jenis konten, dan kesenjangan di antaranya bisa mengarah ke mana saja tergantung pada apa yang diterjemahkan. Variasi itulah tepatnya yang menjadi alasan platform ini menjalankan beberapa model pada setiap terjemahan alih-alih memilih salah satu sebagai rekomendasi tetap.