November 13, 2026
Qwen против Gemini для перевода и почему направление имеет значение
У вас есть две модели и список языковых пар, и вам нужно решить, какой модели доверить проект. Большинство сравнений Qwen и Gemini дают один общий балл. Я считаю, что один балл скрывает то, что определяет результат, а именно направление перевода.
Я занимаюсь тестированием моделей, работающих на MachineTranslation.com, поэтому могу сравнить Qwen и Gemini на 98 языковых парах, оцененных на идентичном тексте. Gemini получил более высокий балл в 68 из этих пар, а Qwen в 29, при этом средний разрыв составляет 0,08 балла из 10. Сами по себе общие показатели не говорят о том, какую модель выбрать для перевода с урду на английский или с английского на гаитянский креольский.
В этой статье показано, где две модели близки, а где лидирует каждая из них. В ней также говорится о том, чего я пока не могу вам сказать. Мои данные заканчиваются 8 августа 2026 года, до того, как Google анонсировала Gemini 4 в октябре, поэтому они описывают более ранние версии обеих моделей.
Ключевые выводы
- По 98 языковым парам, оцененным на идентичном тексте (с 12 июля по 8 августа 2026 года), Gemini получил более высокий балл в 68 парах, Qwen в 29, а в одной паре зафиксирована ничья.
- Средний разрыв невелик, 9,06 у Gemini против 8,98 у Qwen, и 60 из 98 пар находятся в пределах 0,1 балла.
- При переводе на английский Qwen лидирует более чем на 0,1 балла в 7 из 27 пар, а Gemini в 3; остальные 17 находятся в пределах 0,1 балла.
- При переводе с английского Gemini лидирует более чем на 0,1 балла в 13 из 29 пар, а Qwen ни в одной.
- Данные заканчиваются до того, как Google анонсировала Gemini 4 в октябре 2026 года, поэтому они описывают более ранние версии Gemini и требуют повторного тестирования, прежде чем считать их актуальными.
Что лучше для перевода, Qwen или Gemini?
Это зависит от направления, поскольку две модели близки, когда целевым языком является английский, а Gemini получает более высокие баллы в большинстве других пар. По всем 98 парам Gemini получил более высокий балл в 68. По оценкам MachineTranslation.com с 12 июля по 8 августа 2026 года, Gemini в среднем набрал 9,06 из 10, а Qwen 8,98, при этом средний разрыв составил 0,08 балла.
В выборку включены только сегменты, где ChatGPT, Claude, DeepSeek, Gemini и Qwen получили реальную оценку, поэтому каждая модель оценивается по идентичному исходному тексту. В каждой языковой паре не менее 30 сегментов. Я использую эту выборку, потому что она устраняет распространенную ошибку, заключающуюся в сравнении моделей на разном тексте.
По количеству Gemini впереди в 68 парах (69%), Qwen в 29 (30%), а в одной паре ничья. Один лишь количественный показатель преувеличивает разрыв, поскольку 60 из 98 пар находятся в пределах 0,1 балла. В следующих разделах результаты разделены по направлениям и по величине разрыва.
Какие направления перевода благоприятствуют каждой модели?
Gemini лидирует, когда английский является исходным языком или когда ни один из языков не является английским, а Qwen идет наравне с ним или впереди, когда английский выступает целевым языком. При переводе с английского Gemini лидирует более чем на 0,1 балла в 13 из 29 пар, а Qwen ни в одной. При переводе на английский Qwen лидирует с таким отрывом в 7 из 27 пар, а Gemini в 3.
| Направление | Пары | Gemini опережает более чем на 0,1 | В пределах 0,1 балла | Qwen опережает более чем на 0,1 | Средний разрыв |
|---|---|---|---|---|---|
| На английский | 27 | 3 | 17 | 7 | Qwen +0,04 |
| С английского | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Ни один из языков не английский | 42 | 14 | 27 | 1 | Gemini +0,13 |
При переводе на английский 17 из 27 пар находятся в пределах 0,1 балла, Qwen лидирует в 7, а Gemini лидирует в 3. При переводе с английского 16 из 29 пар находятся в пределах 0,1 балла, Gemini лидирует в 13, а Qwen не лидирует ни в одной. Там, где ни один из языков не является английским, 27 из 42 находятся в пределах 0,1 балла, Gemini лидирует в 14, а Qwen лидирует в 1.
Qwen отстает от Gemini не более чем на 0,1 балла или опережает ее в 24 из 27 пар при переводе на английский. В среднем по направлениям Qwen опережает примерно на 0,04 балла при переводе на английский, тогда как Gemini опережает примерно на 0,16 балла при переводе с английского и на 0,13 балла при переводе между двумя неанглийскими языками.
Я не знаю, почему возникает такое разделение, и эти данные не могут дать ответ. Одно из объяснений, которое я бы проверил в первую очередь, заключается в составе обучающих текстов для каждой модели, но я не проводил этот тест. Qwen демонстрирует похожую картину в сравнении с ChatGPT. На той же выборке наше сравнение Qwen и ChatGPT показало, что обе модели практически на равных переводят на английский, при этом ChatGPT впереди в 89% остальных пар.
В каких языковых парах наблюдается наибольший разрыв?
Наибольший разрыв наблюдается в пользу Gemini. Модель лидирует с отрывом от 0,51 до 0,95 балла в парах с русского на казахский, с английского на гаитянский креольский, с английского на тагальский, с испанского на греческий и с арабского на персидский. Наибольшие отрывы Qwen скромнее, от 0,15 до 0,26 балла, и четыре из пяти ее лучших результатов приходятся на пары с переводом на английский.
| Языковая пара | Оценка Gemini | Оценка Qwen | Разрыв |
|---|---|---|---|
| С русского на казахский | 9,27 | 8,32 | Gemini +0,95 |
| С английского на гаитянский креольский | 9,19 | 8,27 | Gemini +0,92 |
| С английского на тагальский | 9,14 | 8,43 | Gemini +0,70 |
| С испанского на греческий | 8,90 | 8,33 | Gemini +0,57 |
| С арабского на персидский | 8,84 | 8,34 | Gemini +0,51 |
| С урду на английский | 8,56 | 8,81 | Qwen +0,26 |
| С китайского на английский | 9,00 | 9,19 | Qwen +0,19 |
| Со шведского на английский | 8,29 | 8,46 | Qwen +0,16 |
| С китайского на индонезийский | 9,03 | 9,19 | Qwen +0,16 |
| С бирманского на английский | 8,94 | 9,09 | Qwen +0,15 |
Я бы не стал считать это окончательным рейтингом. Два наибольших разрыва, с русского на казахский и с английского на гаитянский креольский, получены на меньших выборках, чем у медианной пары. Пары с английского на тагальский, с испанского на греческий и с арабского на персидский опираются на более крупные выборки, поэтому этим трем я бы доверял больше. Я бы провел повторное тестирование для двух разрывов с небольшой выборкой, прежде чем полагаться на них.
Что означает разрыв в 0,1 балла?
На мой взгляд, разрыв менее 0,1 балла слишком мал, чтобы определить победителя. Из 98 пар 60 попадают в этот диапазон, и каждая пара оценивается по ограниченному количеству сегментов. Отметка 0,1 является моим собственным рабочим порогом, и я не проводил проверку значимости для этих пар.
Оценка также упускает некоторые различия. В наших тестах распространенных фраз мы пропустили «sorry» на арабском через 22 модели ИИ. И Gemini, и Qwen выбрали разговорное آسف. ChatGPT и объединенный результат выбрали формальное عذرًا. Каждая модель получила оценку 9,5, так что эти два слова различаются по регистру, а оценка не изменилась.
Вот почему я рассматриваю разницу в баллах и примеры регистра вместе. Небольшой разрыв с заметной разницей в регистре требует решения человека. Большой разрыв на небольшой выборке требует повторного тестирования.
Совершают ли Qwen и Gemini разные типы ошибок?
Да, потому что в нашем тесте цитат с Чемпионата мира 2026 года обе модели сделали как минимум один выбор, которого не делали другие модели, и оценки почти не изменились. Gemini перевел фразу Мбаппе как «with each game» и передал цитату Вирца слово в слово, в то время как Qwen дал другое прочтение цитаты Скалони. Оценки для этих случаев варьировались от 9,2 до 9,5.
Подробности взяты из нашего теста цитат с Чемпионата мира. В цитате Мбаппе о взгляде в будущее другие модели сохранили «match», тогда как Gemini написал «with each game», что стало небольшой погрешностью в регистре с оценкой 9,4. В цитате Вирца Gemini перевел фразу слово в слово и изменил смысл, также получив 9,4. В цитате Скалони большинство моделей сошлись на одном варианте прочтения, тогда как Qwen написал «that is what matters» и получил 9,4. В тактической цитате Мбаппе Claude и DeepSeek выбрали британский футбольный английский, а Gemini, Qwen и остальные предпочли американский английский, и Qwen получил 9,2, что ниже остальных.
Я расцениваю это как небольшие привычки. Примеры Gemini касаются регистра и буквальных формулировок. Примеры Qwen связаны с тем, какой вариант прочтения фразы выбрать. Четырех примеров слишком мало, чтобы назвать это закономерностью, но они показывают, какие различия скрывает единая оценка.
Какая модель Qwen лучше всего подходит для перевода?
Я не могу сказать это по нашим данным, потому что в оценках MachineTranslation.com модель Qwen рассматривается как одна модель без указания версии. Разработанное Alibaba семейство Qwen3.8 появилось на Hugging Face в августе 2026 года, поэтому сейчас существует несколько версий, и оценки в этой статье их не разделяют.
Я хотел бы разделить эти данные по версиям, но пока не могу. Показатель на уровне платформы может усреднять результаты нескольких версий Qwen, работавших в этот период. Если вы выбираете между версиями Qwen для проекта, я бы сравнил их на выборке вашего собственного текста.
Какие есть альтернативы Gemini для перевода?
ChatGPT, Claude, DeepSeek, Qwen, Grok и Mistral AI работают на MachineTranslation.com, и подходящая альтернатива зависит от пары. В наших оценках с 12 июля по 8 августа 2026 года Qwen находится в пределах 0,1 балла от Gemini или опережает ее в 24 из 27 пар с переводом на английский язык. Наши оценки Mistral AI для французского языка показывают, что ее средний балл при переводе с французского на английский на 0,40 балла выше, чем у Gemini.
Если вашей альтернативой является ChatGPT, ответ также зависит от конкретной пары. В нашей опубликованной разбивке для перевода с испанского на английский Gemini выиграла в 31% сегментов, а ChatGPT выиграл в 21%. В случае с французским языком ни одна из моделей не побеждает в обоих направлениях. Поскольку выбор меняется в зависимости от пары, MachineTranslation.com не выбирает какую-то одну альтернативу. Сервис запускает их вместе.
Мой совет: отталкиваться от языковой пары и направления, а затем смотреть, какая альтернатива подходит.
Как MachineTranslation.com показывает расхождения между Qwen и Gemini?
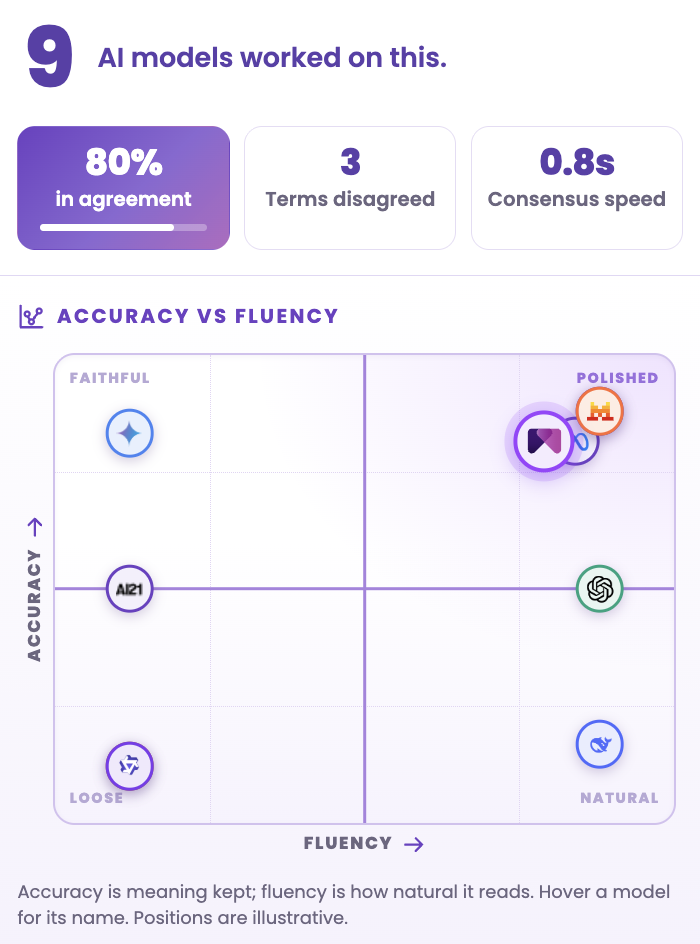
MachineTranslation.com запускает обе модели для каждого перевода и показывает, в чем модели сходятся, а в чем расходятся. Панель согласованности сообщает, сколько моделей ИИ работало над текстом, долю согласия, сколько терминов вызвало разногласия и насколько быстро сформировался консенсус.
Насколько актуальны эти результаты?
Эти результаты охватывают период с 12 июля по 8 августа 2026 года, поэтому они описывают версии Gemini и Qwen, работавшие в то время. Google объявила Gemini 4 в октябре 2026 года. Семейство Qwen3.8 от Alibaba появилось в августе 2026 года. Моя рекомендация: перезапустить панель перед тем, как полагаться на эти цифры для нового проекта.
Я рассчитываю, что метод сравнения одинакового текста с поправкой на погрешность останется актуальным. Я предполагаю, что величина разрывов изменится. Любую пару, где при новом запуске меняется лидер, я бы рассматривал как признак того, что прежний разрыв находился в пределах погрешности.
Как бы я выбирал между Qwen и Gemini для проекта?
Моя позиция заключается в том, чтобы выбирать по паре и направлению и избегать единого выбора для всего проекта. На практике это означает рассматривать разрыв менее 0,1 балла как ничью и ожидать, что лидирующая модель будет меняться от пары к паре. Вот порядок, которому я бы следовал.
- Составьте список всех языковых пар в проекте и отметьте их направление.
- Проверьте разрыв для каждой пары в этой статье. Считайте разрыв менее 0,1 балла ничьей.
- Там, где разрыв больше, начните с лидирующей модели и протестируйте образец собственного текста.
- Если ваш контент переводится в обоих направлениях, ожидайте смены лидера между парами.
- Проверьте снова, когда любая из моделей выпустит новую версию.
Обе модели работают наряду с 20 другими при каждом переводе на MachineTranslation.com. Возвращается версия, с которой согласно большинство из них, поэтому выбор не обязательно делать один раз для всего проекта. Полный набор результатов моделей представлен в нашем тестировании сравнения моделей.
Часто задаваемые вопросы
1. Что лучше для перевода, Qwen или Gemini?
Все зависит от направления, поскольку Qwen находится в пределах 0,1 балла от Gemini или опережает ее в 24 из 27 пар при переводе на английский. Gemini все же получила более высокий балл в 68 из 98 пар по оценкам MachineTranslation.com с 12 июля по 8 августа 2026 года. Средний разрыв составляет 0,08 балла из 10, поэтому я бы выбирал по паре.
2. Какая модель Qwen лучше всего подходит для перевода?
Я не могу сказать по нашим данным, поскольку в оценках MachineTranslation.com Qwen рассматривается как одна модель без указания версии. Семейство Qwen3.8 от Alibaba появилось на Hugging Face в августе 2026 года, поэтому сейчас существует несколько версий. Пока оценки не разделяют их, я бы сравнил версии на образце вашего собственного текста, прежде чем выбирать одну для проекта.
3. Какие есть альтернативы Gemini для перевода?
ChatGPT, Claude, DeepSeek, Qwen, Grok и Mistral AI работают на MachineTranslation.com. В наших оценках с 12 июля по 8 августа 2026 года Qwen находится в пределах 0,1 балла от Gemini или опережает ее в 24 из 27 пар при переводе на английский. Средний показатель Mistral AI для перевода с французского на английский оказался на 0,40 балла выше, чем у Gemini. Подходящая альтернатива зависит от пары.
4. Gemini лучше ChatGPT для перевода?
Все зависит от языковой пары, поскольку ни одна модель ИИ не побеждает везде. В нашей опубликованной разбивке для перевода с испанского на английский Gemini выиграла в 31% сегментов, а ChatGPT выиграл в 21%. При работе с французским языком ни одна модель не побеждает в обоих направлениях. Я бы проверил нужную вам пару и направление перед выбором между ними.
5. Точна ли Gemini для перевода?
Да, поскольку средний балл Gemini составил 9,06 из 10 по 98 языковым парам в оценках MachineTranslation.com за период с 12 июля по 8 августа 2026 года. Точность все же варьируется в зависимости от пары. Ее отрыв наиболее велик при переводе с английского, а Qwen опережает ее более чем на 0,1 балла в 7 из 27 пар при переводе на английский.