October 2, 2026
Qwen против Grok: какая ИИ-модель переводит лучше?
Qwen и Grok являются ИИ-моделями общего назначения, а не специализированными инструментами для перевода, и обе они входят в пул моделей, которые MachineTranslation.com запускает при каждом переводе. Это важно для понимания того, что написано ниже. В этой статье рассматривается, как две представленные на платформе модели показывают себя в сравнении друг с другом, с учетом реальных оговорок, которые сопровождают такие данные, а не соревнование между двумя внешними претендентами и самой платформой.
Что такое Qwen и Grok?
Qwen — это семейство больших языковых моделей от Alibaba, в настоящее время представленное поколением Qwen3.8, которое было добавлено в пул моделей MachineTranslation.com в рамках постоянного расширения платформы. Grok — это линейка моделей от xAI, на момент написания статьи представленная версией Grok 4.7, которая прошла через несколько релизов с момента выхода версии, первоначально сравнивавшейся в этой статье, и была добавлена на платформу отдельно. Ни одна из этих моделей не создавалась специально для перевода. Обе являются системами общего назначения, которые просто поддерживают множество языков в рамках более широких языковых возможностей, что является совершенно иной отправной точкой по сравнению с платформой, созданной и протестированной специально для обеспечения качества перевода.
Как Qwen и Grok показывают себя в сравнении на основе собственных данных MachineTranslation.com?
За последние 28 дней трафика платформы Grok в среднем получил более высокую оценку, чем Qwen: 9.26 из 10 против 8.87. 10% переводов Grok с наихудшими оценками все равно в среднем составили 9.2, в то время как 10% наихудших переводов Qwen упали до 7.6, что говорит о большем разрыве на нижнем уровне, чем показывает только среднее значение.
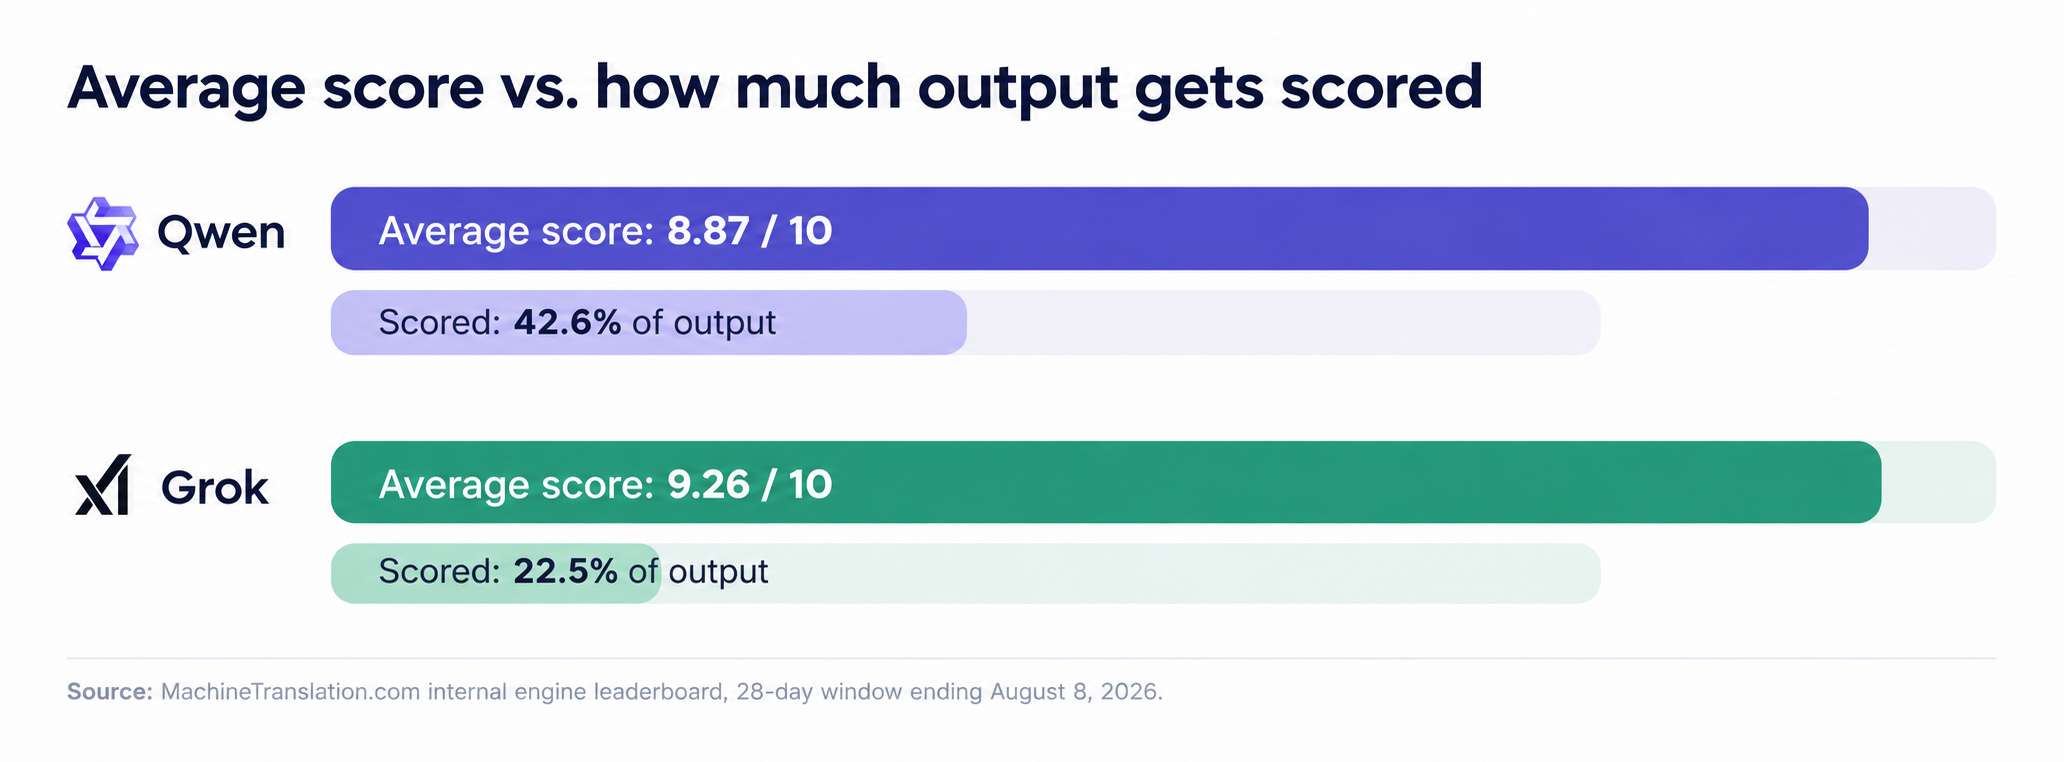
Средняя оценка Grok выше, но она основывается на оценке менее четверти его результатов, по сравнению с почти половиной у Qwen. Эти два столбца рассказывают разные части одной и той же истории.
| Qwen | Grok | |
|---|---|---|
| Процент оцененных результатов | 42.6% | 22.5% |
| Средняя оценка | 8.87 / 10 | 9.26 / 10 |
| Худшие 10% оценок | 7.6 | 9.2 |
Источник: внутренний рейтинг движков MachineTranslation.com, 28-дневный период, завершившийся 8 августа 2026 года.
Означает ли более высокий балл Grok, что это лучший выбор?
Сама по себе — нет. Grok используется на платформе гораздо реже, чем Qwen, и менее четверти его переводов вообще получают оценку, тогда как у Qwen этот показатель составляет почти половину. Меньшая, менее репрезентативная выборка может сделать средний показатель лучше или хуже, чем он был бы при таком же объеме, который обрабатывает Qwen. Собственные отчеты MachineTranslation.com по этим данным рассматривают охват оценками как реальное ограничение, а не как незначительную деталь: движок, оцененный на узком сегменте своего трафика, не прошел такой же тщательной проверки, как тот, что был оценен почти на половине своих результатов.
Если говорить начистоту, показатели Grok многообещающие, но основаны на меньшем объеме данных. Показатели Qwen в среднем ниже, но опираются на гораздо более крупную и репрезентативную базу. Ни один из этих фактов не отменяет другой.
Как насчет языкового охвата?
Ни Qwen, ни Grok не публикуют подтвержденный список языковых пар, на которых их производительность снижается, и не существует независимого тестирования, которое могло бы это подтвердить. С уверенностью можно сказать лишь то, что ни одна из моделей не создавалась с упором на качество перевода для конкретного набора языков так, как это делает специализированная платформа для перевода. MachineTranslation.com напрямую тестирует и поддерживает более 270 языков, что является заявлением совершенно иного уровня по сравнению с широкими, но непроверенными многоязычными возможностями моделей общего назначения.
Как MachineTranslation.com на самом деле использует Qwen и Grok
MachineTranslation.com запускает Qwen, Grok и более 20 других ИИ-моделей при каждом переводе, а затем предлагает тот вариант, в котором эти модели больше всего совпадают. Ни одна из моделей не исключается из-за более низкого среднего балла. Запуск множества моделей одновременно позволяет отловить случаи, когда модель с более низким средним баллом все же правильно переводит конкретное предложение, с которым не справляется модель с более высоким баллом. Производительность Qwen также варьируется в зависимости от направления и языковой пары — эти особенности стоит знать перед выбором одной модели (они более подробно рассматриваются в сравнении Qwen и DeepSeek от MachineTranslation.com). Для более детального ознакомления с тем, как модели напрямую тестируются друг против друга, посмотрите полное тестирование сравнения моделей на MachineTranslation.com.
Часто задаваемые вопросы
1. Что лучше для перевода: Qwen или Grok?
Согласно собственным данным MachineTranslation.com по движкам за 28 дней, Grok в среднем набирает больше баллов, чем Qwen: 9.26 против 8.87 из 10. Однако оценки Grok базируются на гораздо меньшей, менее репрезентативной части его результатов, поэтому это не прямое сравнение, каким был бы тест на идентичных сегментах.
2. Почему у Grok более высокий средний балл, но меньше оцененных переводов?
Grok используется на платформе реже, и лишь около 22.5% его результатов получают оценку, по сравнению с 42.6% у Qwen. Меньшая, менее репрезентативная выборка может завысить или занизить среднее значение, поэтому данное сравнение следует рассматривать как ориентировочное, а не окончательное.
3. Qwen или Grok поддерживает больше языков?
Обе модели являются AI-моделями общего назначения без опубликованного, проверенного списка ограничений для конкретных языков. Ни одна из них не создавалась специально для перевода, в отличие от платформы, которая напрямую тестирует и оценивает качество перевода на 270+ языках, а не полагается на широкое многоязычное обучение в качестве замены измеренной эффективности перевода.
4. Конкурирует ли MachineTranslation.com с Qwen и Grok?
Нет. MachineTranslation.com запускает Qwen, Grok и более 20 других AI-моделей для каждого перевода и выводит версию, с которой эти модели больше всего согласны. Платформа тестирует и комбинирует такие модели, а не конкурирует с ними в качестве отдельной собственной модели.
5. Какую AI-модель MachineTranslation.com рекомендует для перевода?
По умолчанию — никакую. Разные модели работают по-разному в зависимости от языковой пары и типа контента, и разрыв между ними может быть в любую сторону в зависимости от того, что именно переводится. Именно из-за этой вариативности платформа запускает несколько моделей для каждого перевода, а не выбирает одну в качестве постоянной рекомендации.