August 5, 2026
Grok vs. Claude para a tradución: o que mostran os benchmarks (2026)
Grok (xAI) e Claude (Anthropic) son ambos ferramentas de tradución de IA capaces, pero teñen puntos fortes estruturalmente diferentes. Para a maioría das tarefas xerais de tradución, non notarás unha diferenza significativa entre eles. Para dous escenarios específicos (traducir contido sobre eventos recentes e traducir documentos formais que requiren precisión), a diferenza é real e está fundamentada en como se construíu cada modelo.
Este artigo abrangue o que ofrece realmente cada modelo para a tradución, onde os sitúan os benchmarks independentes e que usar cando o resultado de calquera dos dous modelos por si só non é suficiente.
Como se comparan Grok e Claude en canto á calidade da tradución?
A resposta curta: Claude lidera os benchmarks de tradución profesional independentes. A vantaxe específica de Grok é o acceso ao coñecemento en tempo real, non a calidade xeral da tradución.
Nos benchmarks internos de MachineTranslation.com, Claude (nivel 3.5 Sonnet) obtén unha puntuación de 93.8 sobre 100 en calidade de tradución — precisión, terminoloxía e estilo combinados. Grok non aparece entre as 14 mellores solucións do State of Translation Automation 2025 de Intento, que avaliou 46 motores de tradución automática e LLMs en 11 pares de linguas. Claude Opus 4 e Claude Sonnet 3.7 aparecen ambos no top 14. Fonte: Benchmarks internos de MachineTranslation.com; Intento State of Translation Automation 2025.
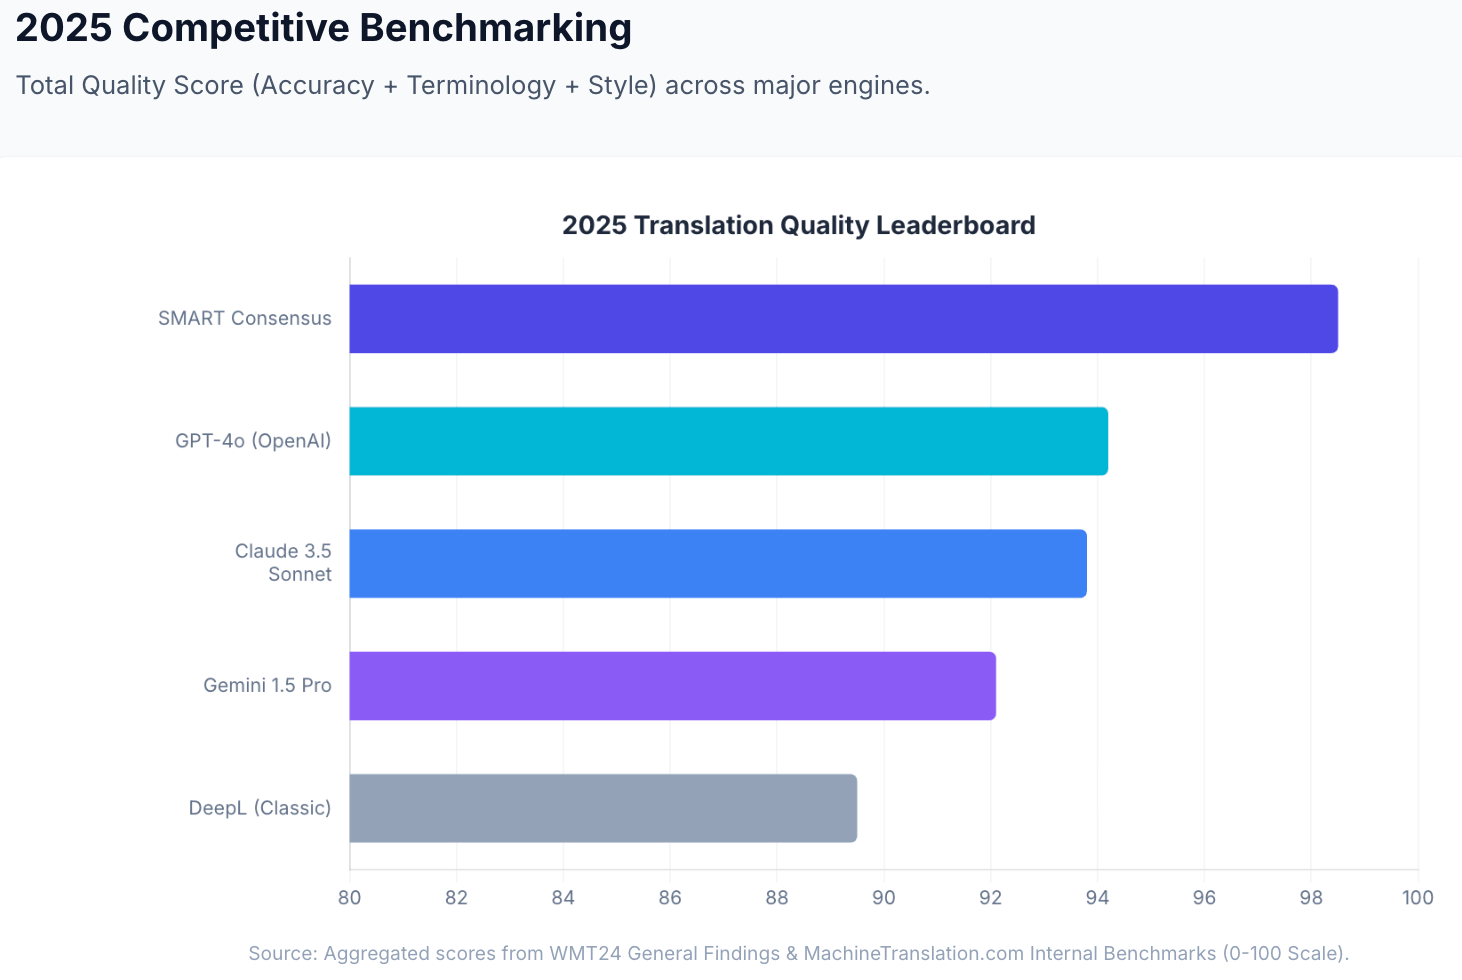
En WMT24 (a principal competición independente de benchmarks do sector da tradución), Claude 3.5 clasificouse en primeiro lugar en 9 de 11 pares de linguas, por diante de GPT-4 e de motores de tradución automática neuronal dedicados. No estudo a cegas de 2025 de Lokalise realizado por tradutores profesionais, o 78% das traducións de Claude 3.5 foron valoradas como boas — a maior de calquera LLM probado.
Grok non foi avaliado en WMT24 nin na avaliación independente de LQA de Intento a un nivel comparable. A Slator Pro Guide (2025) inclúe a Grok como un dos LLMs de propósito xeral utilizados para a tradución en contornas profesionais, xunto con GPT e Claude, pero non o sitúa por riba de ningún deles.
| Benchmark | Grok | Claude |
|---|---|---|
| Puntuación de calidade interna de MachineTranslation.com | Non medido a nivel de benchmark | 93.8/100 (nivel 3.5 Sonnet) |
| As 14 mellores solucións de Intento 2025 | Non listado | Claude Opus 4 e Sonnet 3.7, ambos listados |
| Pares de linguas de WMT24 | Non avaliado | 1º en 9/11 pares de linguas |
| Estudo a cegas de Lokalise 2025 | Non avaliado | 78% bo (o máis alto de calquera LLM) |
Fonte: Benchmarks internos de MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Onde ten Grok unha verdadeira vantaxe?
Tradución en tempo real e de acontecementos actuais. A característica arquitectónica definitoria de Grok é a súa integración cos datos da plataforma X (anteriormente Twitter) e a busca en internet en tempo real. A diferenza de Claude e da maioría dos outros LLMs, que están adestrados en conxuntos de datos estáticos con límites de coñecemento fixos, Grok incorpora información en tempo real nos seus resultados. Para tarefas de tradución que impliquen acontecementos recentes, produtos de lanzamento recente, terminoloxía política emerxente, noticias actuais ou contido que faga referencia a feitos que sucederon nas últimas semanas, Grok ten acceso a un contexto ao que Claude non ten.
Isto é especialmente importante para: traducir artigos de noticias sobre acontecementos recentes, localizar anuncios de produtos para mercados de rápida evolución, xestionar terminoloxía de nova creación ou xiria posterior aos datos de adestramento doutros modelos, e calquera contido onde o significado dependa de saber o que pasou recentemente.
Terminoloxía emerxente e en evolución. Os campos técnicos, as industrias e os contextos culturais producen continuamente nova terminoloxía. Para tarefas de tradución que impliquen termos de recente creación, nova linguaxe regulatoria ou nova nomenclatura de produtos, o adestramento actualizado de Grok e a busca en tempo real danlle acceso a patróns de uso que as instantáneas de datos de adestramento máis antigas non capturan.
Xanela de contexto e razoamento de Grok 4.1. Grok 4.1 (a finais de 2025) conta cunha xanela de contexto de 131K tokens e capacidades de razoamento melloradas, o que o fai capaz en documentos complexos e de múltiples capas onde as relacións entre cláusulas e a coherencia lóxica importan.
Onde ten Claude unha verdadeira vantaxe?
Calidade de tradución en benchmarks independentes. A vantaxe de Claude está documentada por unha avaliación profesional independente en lugar de por afirmacións autodeclaradas. WMT24 situou a Claude 3.5 en primeiro lugar en 9 de 11 pares de linguas fronte a todo o campo competitivo. O estudo a cegas de 2025 de Lokalise revelou que os tradutores profesionais preferiron os resultados de Claude 3.5 cunha taxa de bo do 78% — superior á de GPT-4, DeepL e Google Translate na mesma avaliación. Estas son avaliacións a cegas: tradutores profesionais avaliaron os resultados sen saber que modelo os produciu.
Pares de linguas específicos por Intento 2025. Claude Opus 4 e Sonnet 3.7 aparecen na categoría best para inglés a alemán, inglés a xaponés, inglés a italiano, inglés a coreano, inglés a neerlandés, inglés a árabe e inglés a francés na avaliación humana de LQA de Intento. Para estes pares, Claude é a opción documentada máis forte entre as dúas.
Precisión de ton e contido matizado. Os tradutores profesionais do estudo de Lokalise preferiron o resultado de Claude coa taxa máis alta de calquera LLM — o que reflicte a documentada fortaleza de Claude para preservar o rexistro, a voz do autor e o significado contextual. Para a tradución literaria, documentos xurídicos, comunicacións formais e textos de marketing onde o como se di algo importa tanto como o que se di, Claude ofrece de xeito constante un bo rendemento en avaliacións independentes.
Coherencia en documentos longos. Claude 4.6 Sonnet admite unha xanela de contexto de 200K tokens, con Claude Opus 4.6 admitindo 1M de tokens en beta. Para documentos formais longos (contratos, manuais técnicos, informes de ensaios clínicos), Claude pode procesar o documento completo nunha única pasada, mantendo a coherencia terminolóxica en todo momento. Os documentos procesados en fragmentos presentan unha taxa de inconsistencia terminolóxica un 28% superior en comparación co procesamento de documentos completos. Fonte: Datos internos de MachineTranslation.com.
Como se comparan en canto ao soporte de idiomas e prezos?
Soporte de idiomas: Tanto Grok 4.1 como Claude 4.6 admiten a tradución na maioría dos principais idiomas do mundo. Claude foi avaliado de forma independente en pares de linguas europeas e de Asia oriental con resultados sólidos. O soporte multilingüe de Grok mellorou ao longo das sucesivas versións. Para linguas con poucos recursos, ambos os modelos perden calidade — a revisión humana é adecuada para o contido en pares de linguas con poucos recursos, independentemente do modelo que se utilice.
Prezos:
| Plan | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Consumidor (mensual) | SuperGrok: $30/mes | Claude Pro: $20/mes |
| Entrada de API (por M tokens) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Saída de API (por M tokens) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Nivel gratuíto | Si (con límite de frecuencia a través de X/Grok.com) | Si (con límite de frecuencia a través de claude.ai) |
No nivel de consumo, Claude Pro ($20/month) is cheaper than SuperGrok ($30/mes). A nivel de API, Grok 4.1 ten unha lixeira vantaxe de custo sobre Claude Sonnet 4.6 para fluxos de traballo de tradución con gran volume de entrada.
Cal é mellor para tipos de contido específicos?
| Tipo de contido | Modelo recomendado | Razón |
|---|---|---|
| Noticias recentes / actualidade | Grok | Acceso a datos en tempo real; os modelos con adestramento estático carecen de contexto actual |
| Terminoloxía emerxente / lanzamentos de novos produtos | Grok | A integración de busca en directo capta os patróns de uso recentes |
| Documentos xurídicos formais | Claude | Avaliación independente de WMT24 e Lokalise 2025; precisión do ton |
| Contido médico / clínico | Claude | Posición en probas de rendemento independentes; preservación do rexistro |
| Textos publicitarios / contido creativo | Claude | Preferencia no estudo a cegas de Lokalise 2025; matices de ton |
| Documentación técnica (longa) | Claude | Xanela de contexto de 200K-1M; consistencia terminolóxica ao longo do texto |
| Redes sociais / contido conversacional | Calquera dos dous | Ambos xestionan ben os pares conversacionais de altos recursos |
| Desenvolvedor / integración de API | Calquera dos dous | Ambos ofrecen acceso á API; Grok é lixeiramente máis barato nos tokens de entrada |
Que usar cando un modelo non é suficiente
Tanto Grok coma Claude son ferramentas de modelo único. Cada modelo de IA individual (independentemente do capaz que sexa) produce erros que non pode detectar na súa propia saída. Unha tradución fluída e segura, tanto de Grok coma de Claude, aínda pode ser semanticamente errónea, e sen unha comprobación cruzada non hai forma de sabelo.
Tanto Grok coma Claude están entre os 22 modelos do sistema SMART de MachineTranslation.com. SMART executa os 22 modelos simultaneamente (incluíndo Grok e Claude) e devolve o resultado no que coincide a maioría.
O que isto significa para a cuestión Grok vs. Claude: A forza en tempo real de Grok e a profundidade contextual de Claude contribúen ambas ao mesmo consenso. Cando están de acordo, ese acordo é un forte sinal de calidade.
Nos benchmarks internos de MachineTranslation.com, os modelos individuais de primeiro nivel obteñen unha puntuación de 93-94 sobre 100 en calidade de tradución. O resultado de consenso de SMART alcanza o 98.5/100. Fonte: Benchmarks internos de MachineTranslation.com e resultados de tradución automática xeral de WMT24.
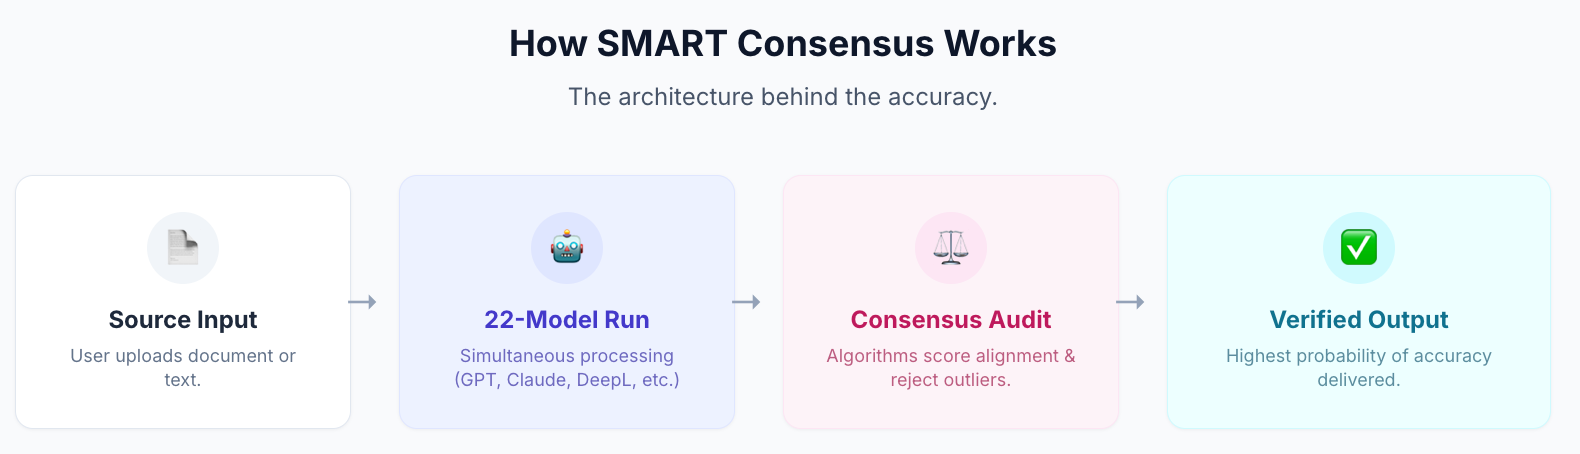
Os usuarios que pasaron da tradución de motor único a SMART dedicaron un 27% menos de tempo a verificar e corrixir os resultados. Fonte: Datos internos de MachineTranslation.com.
Para contidos críticos (documentos legais, presentacións regulamentarias, instrucións médicas), Human Verification eleva o SMART consensus a un revisor profesional certificado dentro da mesma plataforma. Ningunha axencia externa. 100% de precisión garantida.
Traduce con Grok, Claude e outros 20 modelos en MachineTranslation.com — gratis, sen necesidade de rexistro.
Preguntas frecuentes
1. É Grok mellor que Claude para a tradución?
Para a maioría das tarefas de tradución estándar, Claude lidera nos benchmarks independentes: primeiro en 9 de 11 pares de linguas en WMT24, unha valoración de bo do 78% no estudo a cegas de 2025 de Lokalise e 93.8/100 nos benchmarks de calidade internos de MachineTranslation.com. A vantaxe específica de Grok é para o contido que require coñecemento de temas de actualidade, o seu acceso a datos en tempo real dálle un contexto que os modelos adestrados de xeito estático, incluíndo Claude, non teñen. Para noticias recentes, terminoloxía emerxente e contido sensible ao tempo, Grok é a opción máis sólida.
2. Cal é a vantaxe de Grok sobre Claude para a tradución?
Grok integra datos en tempo real de X (anteriormente Twitter) e busca en internet en directo. A diferenza de Claude e da maioría dos outros LLMs adestrados con conxuntos de datos estáticos, Grok pode acceder a información sobre acontecementos recentes, terminoloxía recentemente acuñada e o contexto actual ao xerar traducións. Isto faino especificamente máis forte para traducir contido de noticias, produtos lanzados recentemente e calquera material onde o significado dependa de eventos ou patróns lingüísticos das últimas semanas.
3. Cal é a vantaxe de Claude sobre Grok para a tradución?
A vantaxe de Claude está documentada a través dunha avaliación profesional independente. Claude 3.5 quedou en primeiro lugar en 9 de 11 pares de linguas no WMT24, e os tradutores profesionais no estudo a cegas de 2025 de Lokalise preferiron os seus resultados cunha taxa de bo do 78% — a máis alta de calquera LLM probado. Claude tamén aparece nas 14 mellores solucións de Intento en múltiples pares de linguas na avaliación LQA humana, mentres que Grok non. Para tarefas de tradución formais, profesionais e de alto risco, o posicionamento independente de Claude nos benchmarks é o elemento diferenciador documentado.
4. Cal é mellor para a tradución xurídica, Grok ou Claude?
Claude é a opción máis sólida para a tradución xurídica baseándose nunha avaliación independente. Claude 3.5 clasificouse en primeiro lugar na maioría dos pares de linguas europeas de altos recursos no WMT24 e recibiu as valoracións de preferencia máis altas en estudos a cegas por parte de tradutores profesionais. Para contidos xurídicos que requiren unha precisión certificada, ningún dos dous modelos por si só é suficiente — a Verificación Humana de MachineTranslation.com ofrece un 100% de precisión por parte dun revisor profesional certificado dentro da mesma plataforma, sen necesidade de provedores externos.
5. Están dispoñibles tanto Grok coma Claude en MachineTranslation.com?
Si. Ambos están entre os 22 modelos do sistema SMART de MachineTranslation.com. Cada tradución SMART executa Grok, Claude e outros 20 modelos simultaneamente, devolvendo o resultado no que coincide a maioría. En lugar de elixir entre eles, recibes o consenso de todos os modelos de IA.
6. Como se comparan Grok e Claude en canto a prezos?
No nivel de consumo, Claude Pro custa $20/month versus SuperGrok at $30/mes. A nivel de API, Grok 4.1 é lixeiramente máis barato nos tokens de entrada ($2/M vs. $3/M para Claude Sonnet 4.6) e de saída ($10/M vs. $15/M). O plan gratuíto de MachineTranslation.com inclúe ambos os modelos como parte do consenso de 22 modelos de SMART, sen necesidade de rexistro.
7. Que modelo de IA é o mellor para traducir artigos de noticias?
Para traducir artigos de noticias, Grok ten unha vantaxe estrutural: a súa integración de datos en tempo real significa que ten contexto actual sobre os acontecementos que se describen, do que poden carecer os modelos adestrados de forma estática. Para a tradución de noticias xerais onde a actualidade non é crítica, o rendemento de referencia de Claude é superior. Para a tradución de noticias de gran volume onde tanto a actualidade como a precisión son importantes, o SMART de MachineTranslation.com executa ambos os modelos e devolve o seu resultado de consenso.