October 2, 2026
Qwen vs Grok: Que modelo de IA traduce mellor?
Qwen e Grok son modelos de IA de propósito xeral, non ferramentas específicas de tradución, e ambos forman parte do conxunto de modelos que MachineTranslation.com executa en cada tradución. Isto é importante para interpretar o que segue. Esta é unha ollada a como dous dos modelos da propia plataforma compiten entre si, coas salvedades reais que implican este tipo de datos, non unha competición entre dous aspirantes externos e a propia plataforma.
Que son Qwen e Grok?
Qwen é a familia de grandes modelos de linguaxe de Alibaba, actualmente na súa xeración Qwen3.8, e engadiuse ao conxunto de modelos de MachineTranslation.com como parte da continua expansión da plataforma. Grok é a liña de modelos de xAI, actualmente en Grok 4.7 no momento de escribir este artigo, tras pasar por varias versións desde a versión que este artigo comparou orixinalmente, e uniuse á plataforma por separado. Ningún dos dous modelos foi construído especificamente para a tradución. Ambos son sistemas de propósito xeral que, casualmente, xestionan moitos idiomas como parte dunha capacidade lingüística máis ampla, o que supón un punto de partida diferente ao dunha plataforma construída e probada especificamente en torno á calidade da tradución.
Como se comparan Qwen e Grok nos propios datos de MachineTranslation.com?
Durante os últimos 28 días de tráfico da plataforma, Grok obtivo unha puntuación media superior á de Qwen: 9.26 sobre 10 fronte a 8.87. O 10% das traducións con peor puntuación de Grok aínda mantivo unha media de 9.2, mentres que o 10% con peor puntuación de Qwen caeu ata o 7.6, unha diferenza máis ampla na franxa baixa do que a media por si soa suxire.
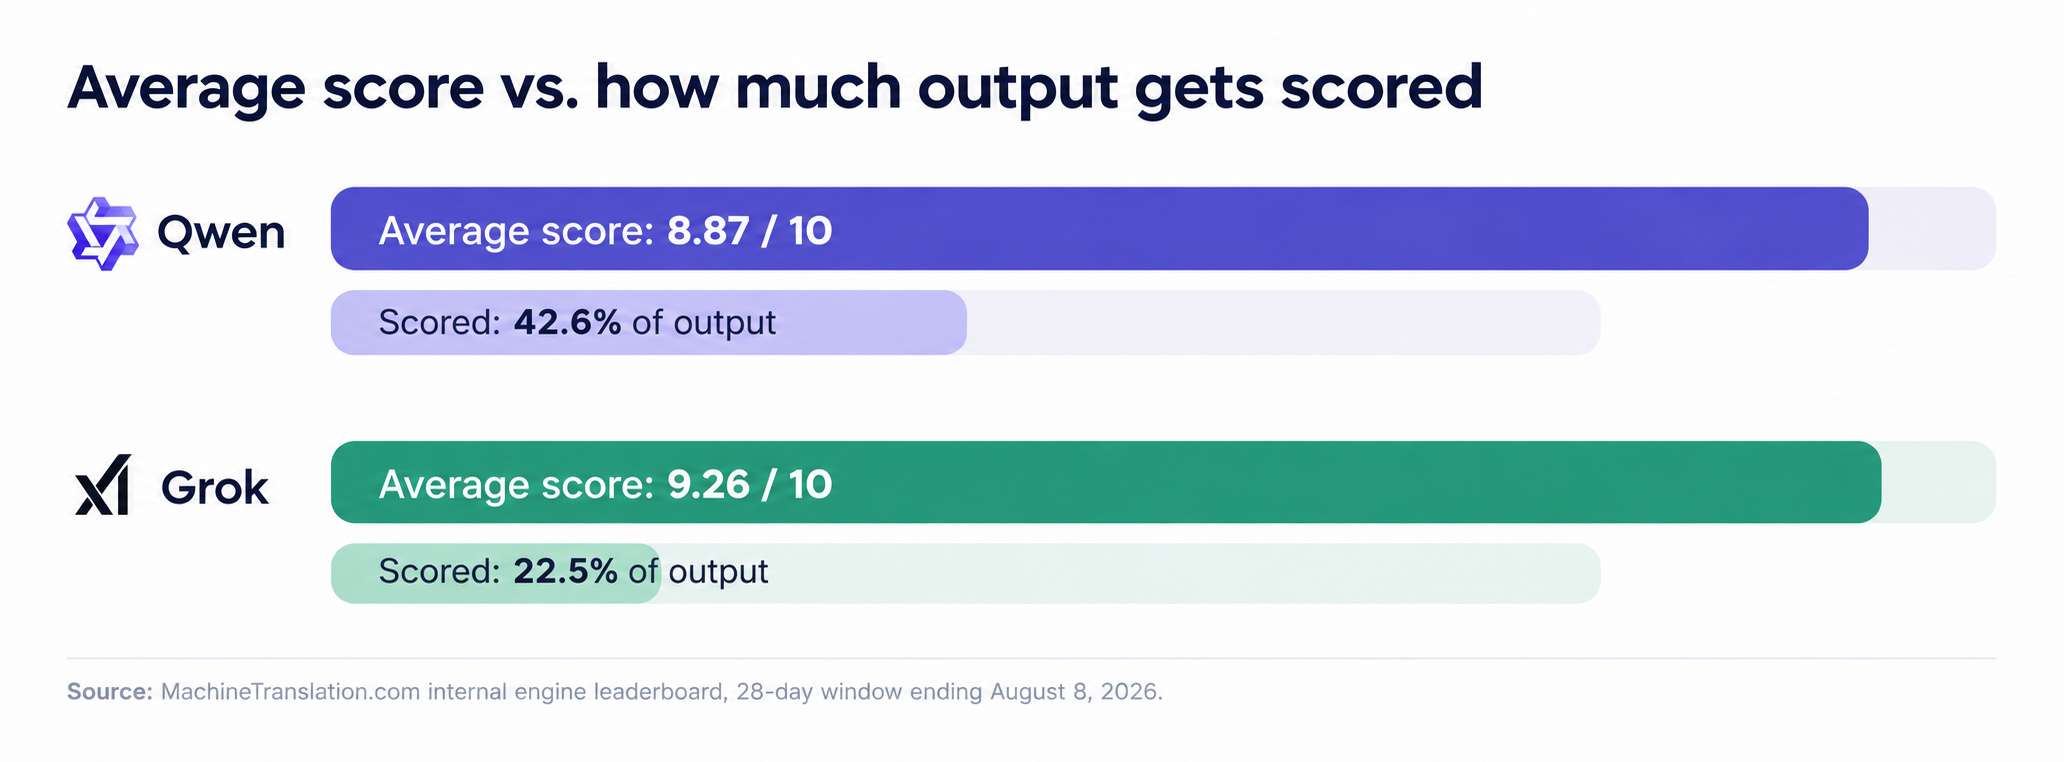
A puntuación media de Grok é superior, pero baséase en avaliar menos dunha cuarta parte dos seus resultados, fronte a case a metade no caso de Qwen. As dúas barras contan partes diferentes da mesma historia.
| Qwen | Grok | |
|---|---|---|
| Porcentaxe de resultados avaliados | 42.6% | 22.5% |
| Puntuación media | 8.87 / 10 | 9.26 / 10 |
| 10% inferior das puntuacións | 7.6 | 9.2 |
Fonte: clasificación interna de motores de MachineTranslation.com, período de 28 días que finaliza o 8 de agosto de 2026.
Significa a maior puntuación de Grok que é a mellor opción?
Non por si só. Grok úsase moito menos na plataforma ca Qwen, e menos dunha cuarta parte das súas traducións reciben puntuación, fronte a case a metade das de Qwen. Unha mostra máis pequena e menos representativa pode facer que unha media pareza mellor ou peor do que sería co mesmo volume que ve Qwen. Os propios informes de MachineTranslation.com sobre estes datos tratan a cobertura das puntuacións como unha limitación real, non como unha nota ao pé: un motor puntuado nunha pequena porción do seu tráfico non foi probado tan a fondo como un puntuado en case a metade da súa produción.
A lectura honesta é que os números de Grok son prometedores pero máis escasos. Os de Qwen son máis baixos de media pero apóianse nunha base moito maior e máis representativa. Ningún destes feitos anula o outro.
Que pasa coa cobertura de idiomas?
Nin Qwen nin Grok publican unha lista verificada de pares de idiomas nos que o rendemento diminúe, e non existen probas independentes para confirmala. O que se pode dicir con seguridade é que ningún dos dous modelos foi deseñado en torno á calidade de tradución nun conxunto específico de idiomas do mesmo xeito que unha plataforma de tradución dedicada. MachineTranslation.com proba e admite directamente máis de 270 idiomas, o cal é un tipo de afirmación diferente á capacidade multilingüe ampla pero sen probar dun modelo de propósito xeral.
Como usa realmente MachineTranslation.com a Qwen e Grok
MachineTranslation.com executa Qwen, Grok e máis de 20 modelos de IA adicionais en cada tradución, e logo mostra a versión na que máis coinciden eses modelos. Ningún modelo se exclúe por ter unha puntuación media máis baixa. Executar moitos modelos á vez significa detectar os casos nos que un modelo con puntuación máis baixa de media segue acertando unha frase específica na que falla un modelo con puntuación máis alta. O rendemento de Qwen tamén se divide por dirección e par de idiomas de formas que vale a pena coñecer antes de escoller un único modelo, tratadas con máis profundidade na comparación de Qwen fronte a DeepSeek de MachineTranslation.com. Para ver máis de preto como se proban os modelos entre si directamente, consulte as probas de comparación de modelos completas de MachineTranslation.com.
Preguntas frecuentes
1. É mellor Qwen ou Grok para a tradución?
Nos datos de motores de 28 días do propio MachineTranslation.com, Grok obtén unha puntuación media superior á de Qwen, 9.26 fronte a 8.87 sobre 10. Pero Grok avalíase nunha parte moito máis pequena e menos representativa da súa produción, polo que este non é un cara a cara limpo como o sería unha proba de segmentos coincidentes.
2. Por que Grok ten unha puntuación media máis alta pero menos traducións avaliadas?
Grok úsase con menos frecuencia na plataforma e só se avalía arredor do 22.5% da súa produción, fronte ao 42.6% de Qwen. Unha mostra máis pequena e menos representativa pode inflar ou subestimar unha media, razón pola cal esta comparación debe lerse como orientativa, non definitiva.
3. Admite máis idiomas Qwen ou Grok?
Ambos son modelos de IA de propósito xeral sen unha lista publicada e verificada de limitacións específicas de idioma. Ningún dos dous está construído especificamente para a tradución, o cal é diferente dunha plataforma que proba e avalía a calidade da tradución en máis de 270 idiomas directamente, en lugar de depender dun amplo adestramento multilingüe como substituto dun rendemento de tradución medido.
4. MachineTranslation.com compite con Qwen e Grok?
Non. MachineTranslation.com executa Qwen, Grok e máis de 20 modelos de IA adicionais en cada tradución e presenta a versión na que máis coinciden eses modelos. Proba e combina modelos coma estes en lugar de competir contra eles como un modelo propio independente.
5. Que modelo de IA recomenda MachineTranslation.com para a tradución?
Ningún por defecto. Os diferentes modelos teñen rendementos distintos segundo o par de idiomas e o tipo de contido, e a diferenza entre eles pode ir en calquera dirección dependendo do que se estea traducindo. Esa variación é exactamente a razón pola que a plataforma executa múltiples modelos en cada tradución en lugar de escoller un como recomendación permanente.