May 15, 2026
翻訳における Claude vs. Qwen:各モデルが実際にどこへ導くのか
2025年7月、AlibabaはQwen3-MTをリリースしました。これは、汎用LLMを翻訳用に転用したものではなく、翻訳に特化して構築された機械翻訳モデルです。強化学習を用いて数兆もの多言語および翻訳トークンでトレーニングされており、92の言語をサポートし、WMT24多言語ベンチマークにおいてGPT-4.1やGemini 2.5 Proに匹敵するBLEUスコアを達成する一方で、中国語・英語および英語・ドイツ語のテストセットではGPT-4.1-miniやGemini 2.5 Flashを上回っています。ソース:Alibaba Qwen, qwenlm.github.io, July 2025.
Anthropicによって開発されたClaudeには、翻訳特化型のバリアントは存在しません。それは、翻訳に加えて推論、コーディング、分析、執筆をこなす汎用的な大規模言語モデルです。その翻訳品質は高い(第三者機関による評価において、ヨーロッパの言語ペア全体で実証されている)が、Qwen3-MTのように翻訳のためにゼロから構築されたわけではない。
この非対称性が、2026年における比較を決定づけている。Qwenは、中国発の深い学習を積んだ汎用的なQwen LLMと、専用に構築された翻訳モデルという、2つの明確な強みを備えています。Claudeは、欧州言語の品質とトーンの正確さにおいて、実証された卓越性をもたらします。それぞれがどこに行き着くかを理解することは、その構造上の優位性が発揮される言語ファミリーやコンテンツタイプを理解することを意味します。
Qwenとは何か、そして2025年以降何が変わったのか?
QwenはAlibaba Cloudの大規模言語モデルファミリーであり、学習の起源や商業的な展開の文脈を反映した、中国語およびアジア言語の処理における特有の強みを持っています。
Qwenファミリーは、この記事のオリジナル版が公開されて以来、大幅に拡大しています。2026年5月現在:
Qwen 3.5(2026年3月)— 0.5Bから397B超のパラメータサイズに及ぶ、現在の汎用Qwen LLM。20兆以上のトークンで学習され、卓越した中国語の語彙力と意味的深みを備えており、中国語、日本語、韓国語のベンチマークでリードし、9万社以上の企業に導入されています。開発者の分析により確認:中国語、日本語、韓国語のテキスト処理において、Qwenに匹敵するオープンソースモデルは存在しません。ソース:AI Magicx, March 2026.
Qwen3-MT (July 2025) — Qwen3アーキテクチャ上に構築され、軽量なMixture-of-Expertsバックボーンを備えたAlibabaの翻訳特化型モデル。強化学習を用いて92言語間の翻訳に特化してトレーニングされており、WMT24多言語ベンチマークにおいて、GPT-4.1およびGemini 2.5 Proに匹敵する性能を達成しています — 大幅に低い計算コストで。これにより、Qwenは翻訳専用に構築されたモデルを持つ数少ないAIプロバイダーの1つとなります。ソース:Marktechpost, July 2025.
MachineTranslation.comのSMARTシステムで使用されているQwenは、一般的なQwen LLMであり、Intentoの2025年のシステムドキュメントによれば、具体的にはQwen 2.5 72B Instruct TurboおよびQwQ 32Bバリアントです。
Claudeは現在、Sonnet 4.6およびOpus 4.6(February 2026)です。Claudeには翻訳に特化したバリアントは存在しません。すべての翻訳能力は、その汎用的な学習に由来しています。Claude 4は、Claude 3.5および3.7が築いた方向性を引き継いでおり、ヨーロッパ言語のペア、トーンの正確性、そしてプロフェッショナルなコンテンツにおける文脈理解に強みを持っています。
Qwenは翻訳において、どこに構造的な優位性があるのでしょうか?
Qwenの優位性は構造的なものであり、そのトレーニングの起源に深く根ざしています:中国語、日本語、韓国語のコンテンツこそが、Qwenの奥深さが最も明確に現れる部分です。
中国語処理。QwenはAlibabaによってゼロからトレーニングされ、中国語を第二言語ではなく第一言語としています。ほとんどの欧米発のLLM(Claudeを含む)は、主に英語のデータでトレーニングされており、そこに他の言語が追加されています。Qwenのトレーニングコーパスは、レジスター、ドメイン、歴史的時代にわたる中国語の書き言葉の奥深さを余すところなく反映しています。ビジネス向けの中国語翻訳、中国語から英語への翻訳、そして文化的背景を含んだ表現を持つ中国語コンテンツにおいて、Qwenのトレーニングの深さは、より自然で翻訳調ではない出力を生成します。
Intentoの2025年の評価では、評価されたソリューション全体で重大または致命的なエラーがまったく検出されず、簡体字中国語が極めて優れたパフォーマンスを達成したことが明らかになりました。これは、中国語において優れたパフォーマンスを示すモデルに、中国語の深いトレーニングを積んだシステムが含まれていることが一因となっています。Qwen3-MTは、特に中国語・英語のテストセットにおいてトップクラスのBLEUスコアを達成しており、このペアにおいてGPT-4.1-miniおよびGemini 2.5 Flashを上回っています。ソース:Qwen公式ブログ、2025年7月。
日本語と韓国語。より広範なCJK(中国語、日本語、韓国語)グループは、ヨーロッパの言語とは構造的に異なる翻訳上の課題 — 異なる表記体系、異なる語順、異なる敬語やレジスターの体系 — をもたらします。Qwenのトレーニングには、中国語と並んで日本語と韓国語の深いカバーが含まれています。アジア市場をターゲットとする多言語製品を構築している開発者チームにとって、QwenのCJKパフォーマンスは、構造的に最も困難なペアにおけるポストエディットの削減を意味します。
オープンソースのアクセシビリティとコスト。Qwenのオープンウェイトモデルは、ローカルまたはカスタムインフラストラクチャにデプロイできます。これにより、データを慎重に扱う組織(機密文書、医療記録、または独自のビジネスコンテンツを翻訳する組織)は、データがインフラストラクチャから外部に出ることなく、Qwenを完全に自社環境内で実行するという選択肢を得られます。ClaudeはクローズドソースのAPI専用モデルであり、セルフホストのオプションはありません。
Qwen3-MTによる翻訳特化型トレーニング。翻訳専用モデルの存在は、QwenにClaudeにはない選択肢を与えています。それは、汎用的な能力ではなく、翻訳品質のためにすべての学習決定が特別に行われたモデルという選択肢です。翻訳ファーストのワークフローを構築しているチームにとって、Qwen3-MTの強化学習アプローチ(一般的な言語品質ではなく、翻訳の忠実度を直接最適化する)は、標準的なプロフェッショナル向けコンテンツにおいて、より一貫した出力を生成できます。
Claudeが翻訳において構造的な優位性を持つのはどのような点でしょうか?
Claudeの強みは、欧州言語の品質、トーンとレジスターの正確さ、そしてプロフェッショナル向けコンテンツや文学コンテンツにおける実績にあります。
欧州の言語ペア。Claude (Opus 4 and Sonnet 3.7)は、Intentoの2025年human LQA evaluationにおいて、英語からドイツ語、英語からイタリア語、英語からオランダ語、英語からフランス語、および英語からアラビア語の「best」カテゴリーに選ばれています。これらは独立した、人間が採点した評価であり、自己申告によるベンチマークではありません。Qwenは、同評価における欧州言語ペアのトップティアグループには入っていません。欧州のプロフェッショナル向けコンテンツにおいて、Claudeの実績は独立した評価全体でより優れています。
トーンの正確性とレジスター。Claudeのトレーニングでは、自然な言語の等価性とトーンの忠実性が強く重視されています。AI Tool Clash(2026年2月)が実施した200文の独立テストにおいて、Claudeの総合スコアは8.3/10となり、ChatGPTの7.9に対して、直訳による慣用句のエラーが大幅に少なく(8%対34%)、文学的なトーンやレジスターの維持においてより優れていることが示された。この比較は、Claude対Qwenの直接的な比較ではなくClaude対ChatGPTの比較ですが、トーンが二の次ではないコンテンツにおいて、実証されているClaudeの文脈理解の優位性を反映しています。
西洋の文脈におけるプロフェッショナルかつフォーマルなコンテンツ。西洋のビジネスレジスター、法的な厳格さ、あるいはヨーロッパの文化的文脈が重要となるコンテンツ(ドイツ語の契約書、フランスのオーディエンス向けのマーケティングコンテンツ、イタリア語の企業コミュニケーションなど)において、Claudeの西洋発のトレーニングは、Qwenが優先していない深い文化的文脈をClaudeに与えています。
トーンを含むコンテンツにおける長文の一貫性。Claude Sonnet 4.6の200KトークンのコンテキストウィンドウとClaude Opus 4.6の1Mトークンのベータウィンドウにより、チャンキングなしでドキュメント全体の処理が可能になります。ナラティブコンテンツ、マーケティングキャンペーン、または文書全体で一貫したトーンを維持する必要がある長編レポートにおいて、Claudeのコンテキスト処理は、プロフェッショナルなレビューに適したレベルでレジスターとトーンの一貫性を維持します。
特定のコンテンツタイプにおいて、これらはどのように比較されるでしょうか?
| コンテンツタイプ | 推奨される選択肢 | 理由 |
|---|---|---|
| 中国語・英語 / 英語・中国語 | Qwen | ネイティブトレーニングの深さ、Qwen3-MT翻訳特化型モデル、Intentoによる中国語の卓越性の認定 |
| 日本語および韓国語のコンテンツ | Qwen | CJKトレーニングの深さ。西洋発のLLMでCJK処理においてQwenに匹敵するものはありません |
| 欧州言語(ドイツ語、イタリア語、オランダ語、フランス語) | Claude | ドイツ語、イタリア語、オランダ語においてIntento 2025のトップティア、独立した評価での地位 |
| 文学的およびトーンに敏感な翻訳 | Claude | AI Tool Clashで全体8.3/10、文学的な一節で9.2/10、強力なレジスター保持 |
| 曖昧な原文 | Claude | 一方に偏るのではなく、両方の解釈を提示する |
| 機密 / セルフホストのワークフロー | Qwen | オープンウェイトでのデプロイ、APIへの依存なし、データはオンプレミスに留まる |
| 翻訳優先のAPIワークフロー | Qwen3-MT | 翻訳専用に構築されたモデル、忠実性のために強化学習(RL)で最適化、92言語に対応 |
| 一般的なプロフェッショナル向け欧州言語コンテンツ | どちらでも可 | 両者とも、リソースの豊富な欧州言語のペアを同等の品質レベルでカバー |
コンテンツタイプ全体におけるこのパターンは、構造的なトレーニングの違いを反映しています:アジア言語および翻訳特化型のデプロイメントにはQwen、欧州言語の品質およびトーンの精度が求められるコンテンツにはClaude。どちらの極端にも当てはまらないコンテンツ(ハイリソース言語における一般的なビジネスコミュニケーション)の場合、両者の違いは、いずれかのモデルと検証済みのコンセンサス出力との違いに比べれば、それほど重要ではありません。
両方が同じシステムの一部である場合、どちらを使用すべきか
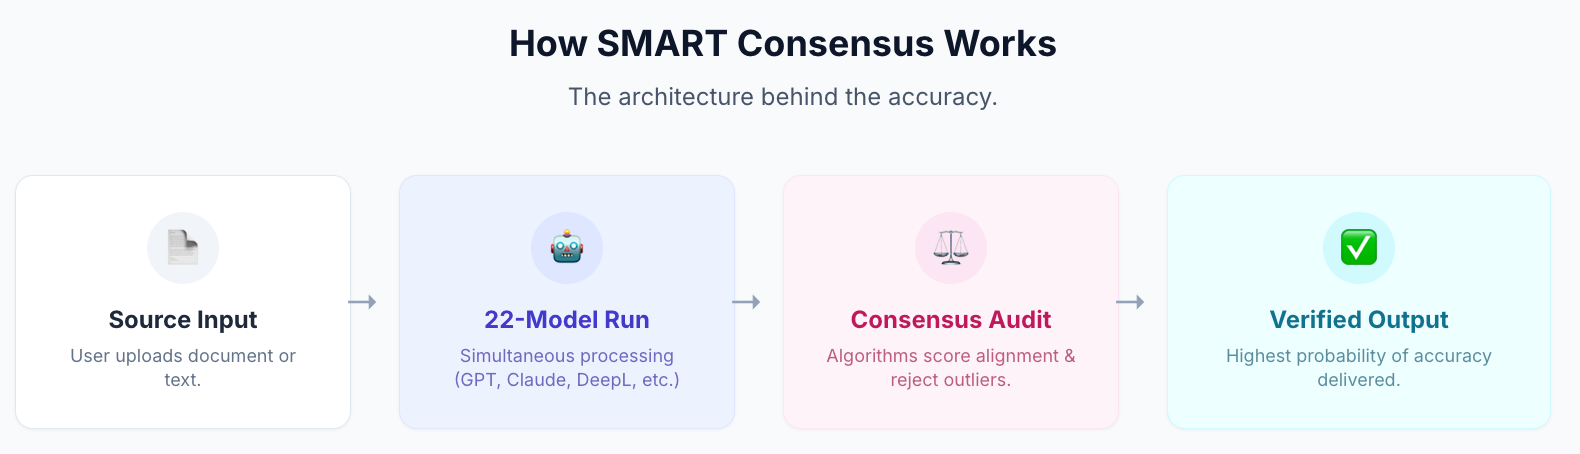
QwenとClaudeはともに、MachineTranslation.comのSMARTシステムに搭載されている22のモデルに含まれています。SMARTは22個すべてを同時に実行し(Qwen(Qwen 2.5 72B Instruct Turbo、QwQ 32B)とClaude(Sonnet 4.6 equivalent tier)の両方を含む)、過半数が合意した出力をTranslation Quality Scoreとともに返します。
特に中国語から英語、または英語から中国語のコンテンツにおいて、SMARTシステムはQwenのCJKの深みとClaudeのトーン理解、Googleの広範な中国語コーパス、そして他の19のモデルを組み合わせます。Qwenの中国語でトレーニングされた出力が、同じ一節に対するClaudeの文脈的な解釈と一致する場合、その一致は強力な品質シグナルとなります。これらが乖離する場合(明確で標準的なテキストよりも、曖昧な一節や文化的に根ざしたコンテンツにおいてその可能性が高くなります)、MachineTranslation.comは、自信に満ちた誤った回答を提示するのではなく、その不確実性を表面化させます。
MachineTranslation.comの内部ベンチマークでは、ClaudeやQwenを含む個々のトップティアモデルが、翻訳品質において100点満点中93〜94点に達しています。22モデルのコンセンサスは98.5/100に達します。
極めて重要なコンテンツ(法的提出書類、臨床文書、規制対象資料)については、Human Verificationにより、同一プラットフォーム内の認定プロフェッショナル査読者へとコンセンサスがエスカレーションされます。100%の精度を保証。
MachineTranslation.comでQwen、Claude、その他20のモデルを使って翻訳 — 無料、登録不要。
よくある質問
1.中国語翻訳において、QwenはClaudeよりも優れていますか?
中国語から英語、および英語から中国語への翻訳において、Qwenには構造的な優位性があります。Alibabaによって中国語のデータでゼロからトレーニングされており、中国語が二次的な言語ではなく、主要なトレーニング言語となっているためです。Alibabaは2025年7月にQwen3-MTもリリースしました。これは、中英のテストセットにおいてGPT-4.1-miniやGemini 2.5 Flashを上回る、優れたBLEUスコアを達成する翻訳特化型モデルです。特に中国語翻訳においては、Qwenの方が実績のある強力な選択肢です。
2.ヨーロッパ言語において、ClaudeはQwenよりも優れていますか?
はい、独立した評価に基づくと、その通りです。Claude Opus 4とSonnet 3.7は、人手によるLQA評価において、英語からドイツ語、イタリア語、オランダ語、フランス語への翻訳におけるIntentoの2025年トップティアにランクインしています。Qwenは、同じ評価における欧州言語ペアのトップグループには入っていません。レジスターやトーンが重要となる欧州のプロフェッショナル向けコンテンツにおいて、Claudeの独立した評価における地位はより強固です。
3.Qwen3-MTとは何ですか?
Qwen3-MT (qwen-mt-turbo)は、Qwen3アーキテクチャに基づいて構築され、2025年7月にAlibabaによってリリースされた機械翻訳モデルです。汎用LLMsとは異なり、それは翻訳に特化して設計およびトレーニングされました — 軽量なMixture-of-Experts backboneと、translation fidelityに最適化されたreinforcement learningを使用しています。92言語に対応し、WMT24ベンチマークにおいてGPT-4.1およびGemini 2.5 Proに匹敵する性能を達成しているほか、用語介入やドメインプロンプトを含む高度なカスタマイズオプションを備えています。
4.Qwenは機密翻訳のためにローカルで実行できますか?
はい。Qwenのオープンウェイトモデルは、外部APIにデータを送信することなく、ローカルインフラストラクチャにデプロイできます。これにより、Qwenは、厳格なデータ主権要件を持つ組織(機密文書を翻訳する医療機関、法務チーム、金融機関など)にとっての選択肢となります。Claudeは、セルフホストのオプションがないクローズドソースのAPI専用モデルです。
5.日本語と韓国語の翻訳にはどちらが良いですか?
Qwen.開発者の分析では、QwenがCJK (Chinese, Japanese, Korean) 処理における最も強力なオープンモデルであると一貫して特定されています。アジア言語におけるそのトレーニングの深さは、アジア市場の90,000以上の企業におけるAlibabaの商業的展開の背景を反映しています。現在のベンチマークにおいて、CJKテキスト処理でQwenに匹敵する欧米発のオープンソースモデルは存在しません。
6.QwenとClaudeはどちらもMachineTranslation.comで利用できますか?
はい。どちらもMachineTranslation.comのSMART systemの22のモデルに含まれています。すべてのSMART翻訳は、Qwen、Claude、およびその他20のモデルを同時に実行し、多数が合意した出力を返します。特に中国語コンテンツにおいては、同じコンセンサスの中にQwenのCJKの深みとClaudeの文脈理解の両方を備えることが、特に価値があります。
7.初期の比較(Claude 3.7 vs Qwen 2.5)から、両方のモデルはどのように変化しましたか?
ClaudeはSonnet 4.6およびOpus 4.6(February 2026)へと進化し、指示追従、推論、および多言語能力が向上しています。Qwenは一般モデルにおいてQwen 3.5 (March 2026)へと進化し、また、最初の比較時点では存在しなかった翻訳特化型モデルであるQwen3-MT (July 2025)もリリースしました。各モデルが持つ構造的な優位性(CJK向けのQwen、ヨーロッパ言語向けのClaude)は、世代を超えて一貫しています。