May 8, 2026
翻訳におけるGrok vs. Claude:ベンチマークが示すもの (2026)
Grok (xAI)とClaude (Anthropic)は、どちらも優れたAI翻訳ツールですが、構造的に異なる強みを持っています。 一般的な翻訳タスクのほとんどでは、それらの間に大きな違いは感じられないでしょう。 2つの具体的なシナリオ(最近の出来事に関するコンテンツの翻訳、および正確性を要する公式文書の翻訳)において、その違いは実在し、それぞれのモデルがどのように構築されたかに基づいています。
この記事では、各モデルが翻訳において実際に何を提供するのか、独立したベンチマークでそれらがどのように位置づけられているのか、そしてどちらのモデルの出力も単体では不十分な場合に何を使用すべきかについて解説します。
翻訳品質において、GrokとClaudeはどのように比較されるでしょうか?
結論から言うと: Claudeは、独立したプロフェッショナル翻訳ベンチマークをリードしています。 Grokの特有の強みはリアルタイムの知識へのアクセスであり、翻訳品質全体ではありません。
MachineTranslation.comの社内ベンチマークでは、Claude (3.5 Sonnet tier)は翻訳品質(正確性、用語、スタイルを総合したもの)において100点満点中93.8点を獲得しています。 Grokは、11の言語ペアにおいて46のMTエンジンとLLMsを評価したIntentoのState of Translation Automation 2025の上位14のソリューションには含まれていません。 Claude Opus 4とClaude Sonnet 3.7は、ともにトップ14に入っています。 ソース: MachineTranslation.comの社内ベンチマーク;Intento State of Translation Automation 2025。
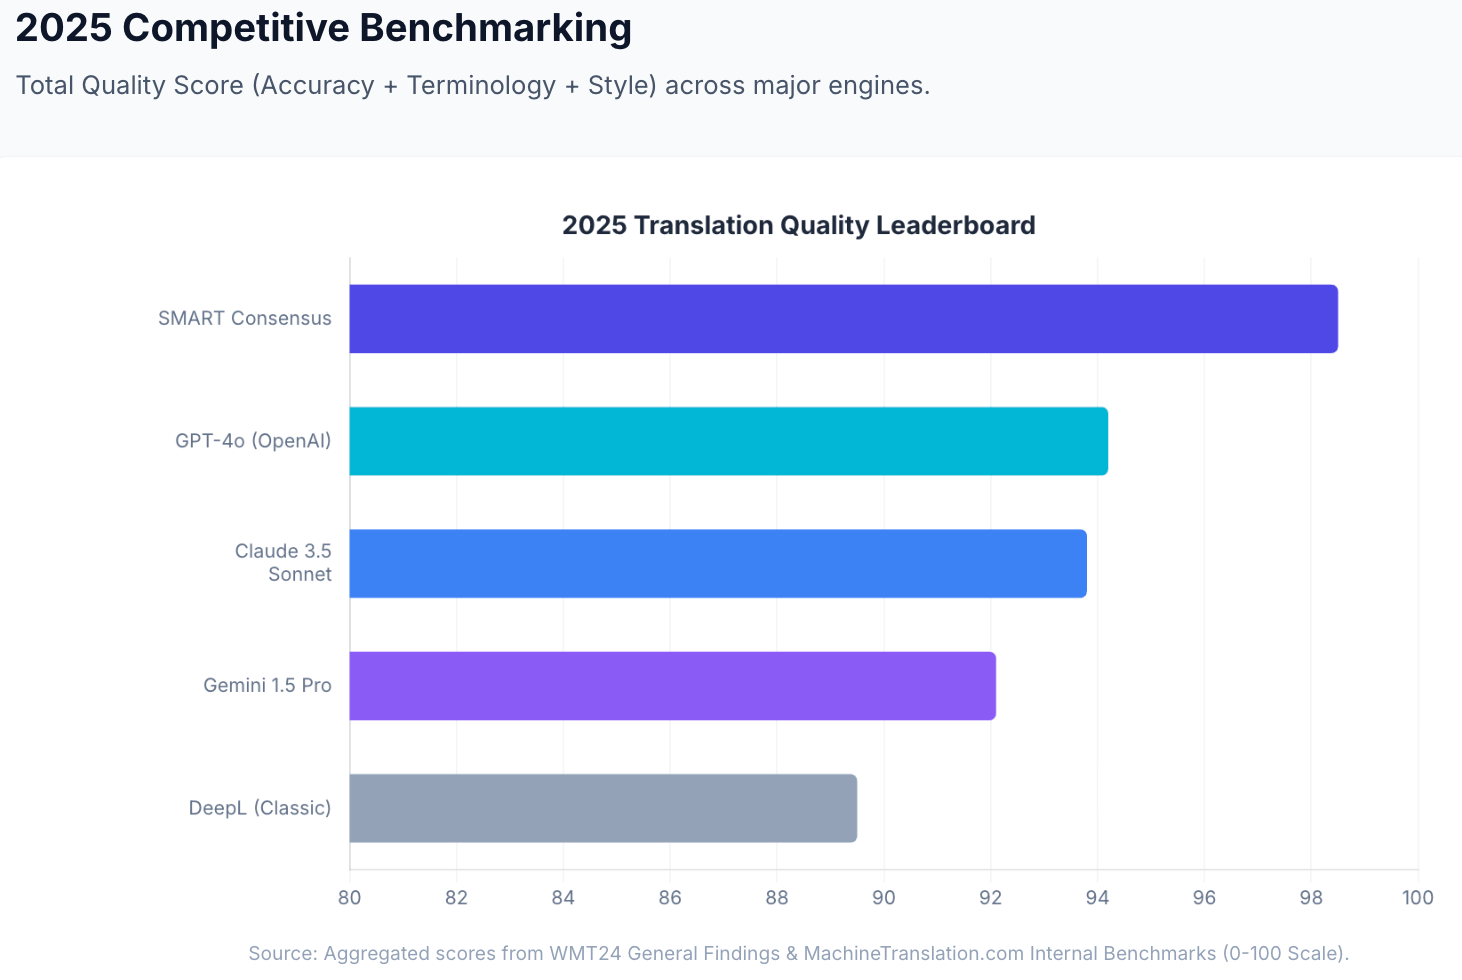
WMT24 (翻訳業界の主要な独立系ベンチマークコンテスト)において、Claude 3.5はGPT-4や専用のニューラルMTエンジンを抑え、11の言語ペアのうち9つで1位を獲得しました。 プロの翻訳者によるLokaliseの2025年ブラインド調査において、Claude 3.5の翻訳の78%が「良い」と評価されました — これはテストされたどのLLMよりも高い割合です。
Grokは、WMT24やIntentoの独立したLQA評価において、同等のレベルで評価されていません。 Slator Pro Guide (2025)は、GrokをGPTやClaudeと並び、プロフェッショナルな環境における翻訳に使用される汎用LLMの1つとして挙げていますが、そのどちらよりも上位には位置付けていません。
| ベンチマーク | Grok | Claude |
|---|---|---|
| MachineTranslation.com内部品質スコア | ベンチマークレベルでは未測定 | 93.8/100 (3.5 Sonnetティア) |
| Intento 2025のトップ14ソリューション | 掲載なし | Claude Opus 4とSonnet 3.7の両方が掲載 |
| WMT24言語ペア | 未評価 | 11言語ペア中9ペアで1位 |
| Lokalise 2025ブラインド調査 | 未評価 | 78%が「良好」(すべてのLLMの中で最高) |
出典: MachineTranslation.comの社内ベンチマーク;Intento State of Translation Automation 2025;WMT24 General MT Findings;Lokalise 2025。
Grokが真の優位性を持つのはどこでしょうか?
リアルタイムおよび時事問題の翻訳。 Grokの決定的なアーキテクチャ上の特徴は、X(旧Twitter)のプラットフォームデータおよびリアルタイムのインターネット検索との統合です。 知識のカットオフが固定された静的なデータセットでトレーニングされているClaudeや他のほとんどのLLMsとは異なり、Grokはリアルタイムの情報を出力に取り入れています。 最近の出来事、新しくリリースされた製品、新たに登場した政治用語、最新のニュース、またはここ数週間の間に起きた出来事に言及するコンテンツを伴う翻訳タスクにおいて、GrokはClaudeにはない文脈にアクセスできます。
これは、特に以下の場合に重要となります:最近の出来事に関するニュース記事の翻訳、変化の激しい市場向けの製品発表のローカライズ、他のモデルの学習データよりも後に登場した新造語やスラングの処理、および最近起きたことを知っているかどうかに意味が左右されるあらゆるコンテンツ。
新たに登場し、進化を続ける用語。 技術分野、産業、そして文化的文脈は、絶えず新しい用語を生み出しています。 最近作られた新語、新たな規制用語、または新しい製品命名法を含む翻訳タスクにおいて、Grokの更新されたトレーニングとリアルタイム検索により、古いトレーニングデータのスナップショットでは捉えられない使用パターンへのアクセスが可能になります。
Grok 4.1のコンテキストウィンドウと推論。 Grok 4.1(2025年後半時点)は、131Kトークンのコンテキストウィンドウと向上した推論機能を備えており、条項間の関係性や論理的整合性が重要となる、複雑で多層的な文書に対応できます。
Claudeが真の強みを持つのはどのような点でしょうか?
独立したベンチマークにおける翻訳品質です。 Claudeの優位性は、自己申告による主張ではなく、独立した専門的な評価によって裏付けられています。 WMT24は、競合全体を対象に、11の言語ペアのうち9つでClaude 3.5を1位にランク付けしました。 Lokaliseの2025年のブラインド調査では、プロの翻訳者がClaude 3.5の出力を78%の「良い」という評価率で支持していることが示されました。これは、同評価におけるGPT-4、DeepL、Google Translateよりも高い数値です。 これらはブラインド評価です。プロの翻訳者が、どのモデルが作成したかを知らずに出力を評価しました。
Intento 2025による特定の言語ペア。 Intentoのhuman LQA evaluationにおいて、Claude Opus 4とSonnet 3.7は、英語からドイツ語、英語から日本語、英語からイタリア語、英語から韓国語、英語からオランダ語、英語からアラビア語、および英語からフランス語において「best」カテゴリーに入っています。 これらのペアにおいて、Claudeは2つのうちでより実績のある選択肢です。
トーンの正確性とニュアンスのあるコンテンツ。 Lokaliseの調査におけるプロの翻訳者は、他のどのLLMよりも高い割合でClaudeの出力を好みました。これは、レジスター、著者の声、および文脈上の意味を維持するという、実証されているClaudeの強みを反映しています。 何を言うかと同じくらい、どのように言うかが重要となる文学翻訳、法的文書、公式なコミュニケーション、およびマーケティングコピーにおいて、Claudeは独立した評価において一貫して優れたパフォーマンスを示しています。
長文における一貫性。 Claude 4.6 Sonnetは200Kトークンのコンテキストウィンドウをサポートしており、Claude Opus 4.6はベータ版で1Mトークンをサポートしています。 長い正式な文書(契約書、技術マニュアル、治験報告書)において、Claudeは文書全体を一度に処理することができ、全体を通して用語の一貫性を維持します。 断片的に処理された文書は、文書全体を処理する場合と比較して、用語の不整合率が28%高くなります。 ソース: MachineTranslation.com 内部データ。
言語サポートと価格の面で、両者はどのように比較されるでしょうか?
言語サポート: Grok 4.1とClaude 4.6はどちらも、世界の主要な言語のほとんどで翻訳をサポートしています。 Claudeは、欧州および東アジアの言語ペアにおいて独立して評価され、優れた結果を示しています。 Grokの多言語サポートは、バージョンを重ねるごとに向上しています。 リソースの少ない言語では、両方のモデルで品質が低下します。そのため、どちらのモデルを使用するかにかかわらず、リソースの少ない言語ペアのコンテンツには人手による確認が適しています。
料金:
| プラン | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| コンシューマー(月額) | SuperGrok: $30/月 | Claude Pro: $20/月 |
| API入力(100万トークンあたり) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API出力(100万トークンあたり) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| 無料プラン | あり(X/Grok.com経由でレート制限あり) | あり(claude.ai経由でレート制限あり) |
コンシューマープランでは、Claude Pro($20/month) is cheaper than SuperGrok ($30/月)。 APIレベルでは、入力の多い翻訳ワークフローにおいて、Grok 4.1はClaude Sonnet 4.6に対してわずかなコスト面での優位性があります。
特定のコンテンツタイプにはどちらが適していますか?
| コンテンツタイプ | 推奨モデル | 理由 |
|---|---|---|
| 最近のニュース / 時事問題 | Grok | リアルタイムデータアクセス。静的にトレーニングされたモデルには最新のコンテキストが欠けています |
| 新しい専門用語 / 新製品の発表 | Grok | ライブ検索の統合により、最近の使用パターンを捉えることができます |
| 正式な法的文書 | Claude | WMT24およびLokalise 2025の独立した評価。トーンの正確性 |
| 医療 / 臨床コンテンツ | Claude | 独立したベンチマークでの地位。レジスターの維持 |
| マーケティングコピー / クリエイティブコンテンツ | Claude | Lokalise 2025のブラインドテストでの選好。トーンのニュアンス |
| 技術文書(長文) | Claude | 200K-1Mのコンテキストウィンドウ。長文全体における用語の一貫性 |
| ソーシャルメディア / 会話型コンテンツ | どちらでも | どちらもリソースの豊富な会話ペアをうまく処理します |
| 開発者 / API統合 | どちらでも | どちらもAPIアクセスを提供。Grokは入力トークンがわずかに安価 |
1つのモデルでは不十分な場合に何を使うべきか
GrokとClaudeはどちらもシングルモデルのツールです。 個々のAIモデルは(その能力がどれほど高くても)、自身の出力に含まれる、自身では検出できないエラーを生み出します。 GrokまたはClaudeによる流暢で自信に満ちた翻訳であっても、意味的に誤っている可能性はあり、クロスチェックなしにそれを知る方法はありません。
GrokとClaudeはどちらも、MachineTranslation.comのSMARTシステムに搭載されている22のモデルに含まれています。 SMARTは22個すべてのモデル(GrokとClaudeを含む)を同時に実行し、多数派が合意した出力を返します。
これがGrok対Claudeの疑問に対して意味すること: Grokのリアルタイムの強みとClaudeの文脈の深さは、どちらも同じコンセンサスに寄与しています。 それらが一致する場合、その一致は強力な品質シグナルとなります。
MachineTranslation.comの社内ベンチマークにおいて、個々のトップティアモデルは翻訳品質において100点中93〜94点を記録しています。 SMARTのコンセンサス出力は98.5/100に達しています。 ソース: MachineTranslation.comの内部ベンチマークおよびWMT24 General Machine Translation Findings。
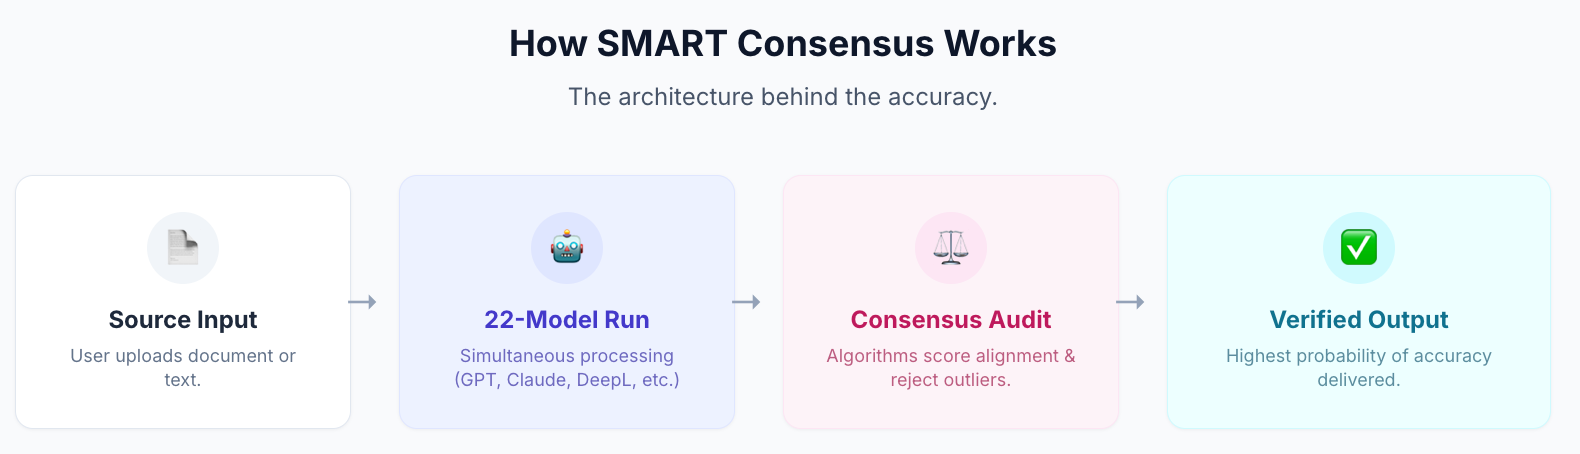
単一エンジン翻訳からSMARTに切り替えたユーザーは、出力の検証と修正に費やす時間が27%減少しました。 Source: MachineTranslation.com 内部データ。
極めて重要なコンテンツ(法的文書、規制当局への提出書類、医療指示書)において、Human VerificationはSMART consensusを同一プラットフォーム内の認定プロフェッショナル査読者へとエスカレーションします。 外部機関なし。 100%の精度を保証。
Grok、Claude、その他20のモデルで翻訳(MachineTranslation.com)— 無料、登録不要。
よくある質問
1. 翻訳において、GrokはClaudeよりも優れていますか?
ほとんどの標準的な翻訳タスクにおいて、Claudeは独立したベンチマークでリードしています。WMT24における11の言語ペアのうち9つで1位、Lokaliseの2025年のブラインド調査で78%の「good」評価、そしてMachineTranslation.comの内部品質ベンチマークで93.8/100を獲得しています。 Grokの具体的な強みは時事問題の知識を必要とするコンテンツにあり、そのリアルタイムデータへのアクセスは、Claudeを含む静的に学習されたモデルにはない文脈をGrokに与えます。 最近のニュース、新たな用語、そして鮮度が重要なコンテンツにおいては、Grokの方がより強力な選択肢です。
2. 翻訳におけるClaudeに対するGrokの優位性は何ですか?
GrokはX(旧Twitter)からのリアルタイムデータとライブインターネット検索を統合しています。 静的なデータセットでトレーニングされたClaudeや他の多くのLLMsとは異なり、Grokは翻訳を生成する際、最近の出来事、新しく作られた用語、および現在のコンテキストに関する情報にアクセスすることができます。 これにより、ニュースコンテンツや最近リリースされた製品、そして意味が過去数週間の出来事や言語パターンに依存するあらゆる資料の翻訳において、特に強みを発揮します。
3. 翻訳におけるGrokに対するClaudeの優位性は何ですか?
Claudeの優位性は、独立した専門家による評価によって裏付けられています。 Claude 3.5はWMT24において11の言語ペアのうち9つで1位を獲得し、Lokaliseの2025年のブラインド調査では、プロの翻訳者がその出力を78%の割合で「良い(good)」と評価しました — これはテストされたどのLLMの中でも最高です。 Claudeも、人手によるLQA評価における複数の言語ペアにわたるIntentoのトップ14のソリューションに含まれている一方で、Grokは含まれていない。 フォーマル、プロフェッショナル、そして極めて重要な翻訳タスクにおいて、Claudeの独立したベンチマークにおける評価は、実証された差別化要因です。
4. 法律翻訳には、GrokとClaudeのどちらが適していますか?
独立した評価に基づくと、法律翻訳にはClaudeの方がより適した選択肢です。 Claude 3.5は、WMT24におけるほとんどの高リソース欧州言語ペアで1位にランクされ、プロの翻訳者からブラインドスタディで最も高い選好評価を獲得しました。 証明された正確性を必要とする法的コンテンツにおいて、どちらのモデル単体でも十分ではありません。MachineTranslation.comのHuman Verificationは、外部ベンダーを必要とせず、同一プラットフォーム内で認定されたプロの査読者による100%の正確性を提供します。
5. GrokとClaudeはどちらもMachineTranslation.comで利用できますか?
はい。 どちらもMachineTranslation.comのSMART systemの22のモデルに含まれています。 SMART翻訳はすべて、Grok、Claude、およびその他20のモデルを同時に実行し、多数派が合意した出力を返します。 それらの中から選択するのではなく、すべてのAIモデルのコンセンサスを受け取ります。
6. GrokとClaudeの価格はどのように比較されますか?
コンシューマー向けプランでは、Claude Proの料金は$20/month versus SuperGrok at $30/月です。 APIレベルでは、Grok 4.1はインプットトークン(Claude Sonnet 4.6の$2/M vs. $3/Mに対して)およびアウトプット($10/M vs. $15/M)においてわずかに安価です。 MachineTranslation.comの無料プランには、SMARTの22モデルのコンセンサスの一部として両方のモデルが含まれており、サインアップは不要です。
7. ニュース記事の翻訳にはどのAIモデルが最適ですか?
ニュース記事の翻訳において、Grokには構造的な優位性があります。リアルタイムのデータ統合により、記述されている出来事に関する最新のコンテキストを把握できるため、静的にトレーニングされたモデルにはそれが欠けている場合があります。 最新性が重要ではない一般的なニュース翻訳において、Claudeのベンチマークパフォーマンスはより優れています。 速報性と正確性の両方が重要となる大量のニュース翻訳において、MachineTranslation.comのSMARTは両方のモデルを実行し、それらの合意出力を返します。