September 9, 2026
Qwen vs DeepSeek:どちらのAIモデルの方が翻訳精度が高いか?
同じ12,000の翻訳セグメントをQwenとDeepSeekで処理すると、大半の言語ペアでDeepSeekが勝利します。それがすべてではありません。結果を翻訳方向別に分けると、特定のパターンが浮かび上がります。特にターゲット言語が英語の場合、Qwenはその差をほとんど縮め、時にはリードすることさえあります。英語からそれ以外の言語に翻訳する場合、ほぼ毎回DeepSeekが勝利します。
単一の言語ペアではなく、数十の言語にわたってコンテンツを翻訳する場合、単一の全体的な勝者よりも、この内訳の方が重要になります。
QwenとDeepSeekとは?
QwenはAlibabaの大規模言語モデルのファミリーです。現在の世代は、2026年8月にリリースされたQwen3.8です:Qwen3.8-Maxは2.4兆パラメータのクローズドでAPI専用のフラッグシップモデルである一方、Qwen3.8-27Bは、その数日後に Apache 2.0 ライセンスでリリースされた、セルフホストを希望するチーム向けの、より小さなオープンウェイトモデルです。
DeepSeekは、わずかな推論コストで最先端の性能に匹敵するMixture-of-Expertsモデルで知られる中国のAIラボです。同社の現世代であるDeepSeek V4は、2026年4月に2つのバリアントでローンチされました:品質を重視するタスク向けのV4 Pro(総パラメータ数1.6兆、トークンあたりのアクティブパラメータ数約490億)と、レイテンシが重視されるワークロード向けのV4 Flash(総パラメータ数2,840億、アクティブパラメータ数約130億)です。いずれも MITライセンスのオープンウェイトとして提供されています。
ベンチマークだけでなく、実際の翻訳においてQwenとDeepSeekはどのように比較されるのでしょうか?
QwenとDeepSeekの比較の多くは、コーディング、数学、推論などの汎用的なベンチマークを引用しています。それらのどれも翻訳品質を直接測定するものではなく、モデルごとに異なる原文を処理させると、精度の差がテキスト自体に起因するものなのかを区別することが不可能になります。
MachineTranslation.comにおける過去28日間の翻訳トラフィックは、両方のモデルがまったく同一の原文を翻訳したため、より明確な答えを示しています。98の言語ペアと12,000以上の対応セグメントにおいて、DeepSeekは83のペアでより高いスコアを獲得し、Qwenは15のペアでより高いスコアを獲得しました。これを、訳文言語が英語である27のペアに絞り込むと、その差は急激に縮まります:DeepSeekがその63%(27中17)で勝利し、Qwenが37%(27中10)で勝利しています。英語がターゲットではない残りの71ペアにおいて、DeepSeekが92%(71ペア中66ペア)で勝利しています。
翻訳方向別の勝率(98の言語ペア、同一テキスト)
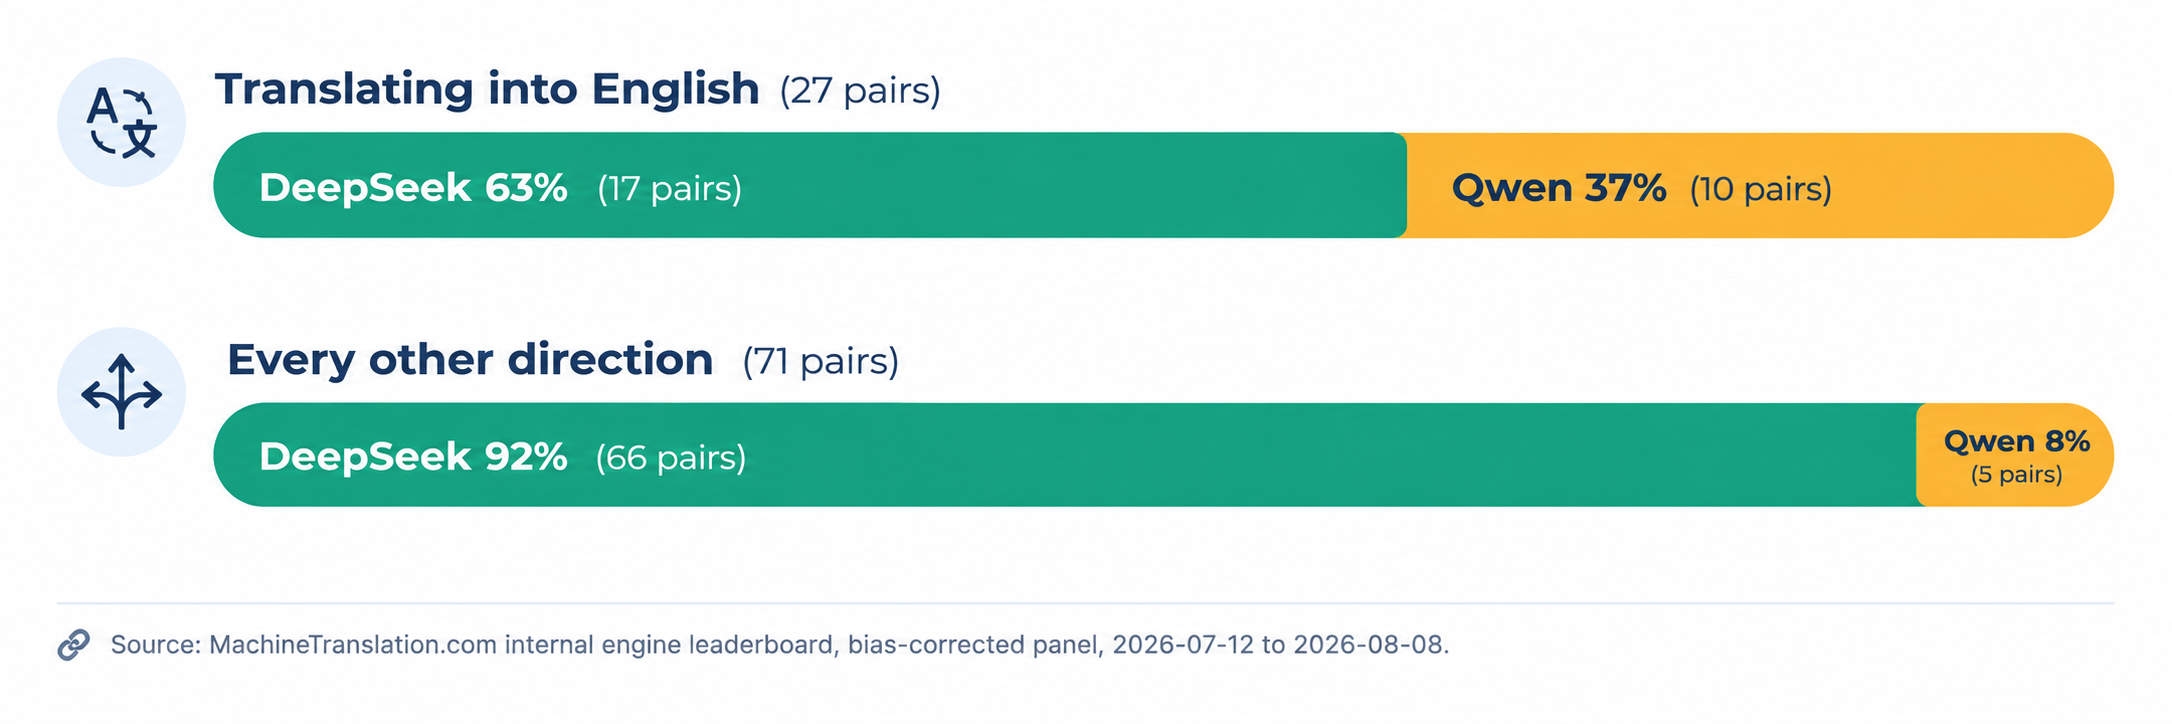
全体として、DeepSeekが大多数の言語ペアで勝利しています。Qwenが競争力を発揮できる範囲は狭いものの確かに存在します。それは英語への翻訳においてであり、そこでは3分の1以上の言語ペアでQwenが優位に立っています。データ:MachineTranslation.comの社内エンジンリーダーボード、バイアス補正済みパネル、2026年7月12日〜8月8日。
すべてのマッチしたセグメントにおける加重平均では、DeepSeekが10点満点中9.13、Qwenが8.98となっています。それは確かな差ですが、均一に分布しているわけではありません。コンテンツが複数の方向に翻訳される場合、このことを知っておく方がより有用です。これは、MachineTranslation.comがこの1つのペアだけでなく、その 全モデルの比較テスト全体で採用しているのと同じ直接対決アプローチです。
この集計された数値は、個別のテストケースでも同様に成り立ちます。フランス語のフレーズ "Elle est directrice adjointe du département commercial" をテストしたところ、DeepSeekとQwenは同じ英語表現 "deputy director of commercial department" に収束した。その ライブテスト結果 は、直接ご確認いただけます。"as soon as possible"のスペイン語への翻訳をテストした際、DeepSeekは「se haga」ではなく「esté hecho」を使用し、4つのモデルによる合意から外れました。これは間違いではなく、プロセスと結果という文法上の区別を反映した 真の乖離ケース です。
なぜQwenは、特に英語への翻訳において優れているのでしょうか?
データはその理由を説明しているのではなく、どこでそうなっているかを示しているにすぎません。Qwenが特に得意とする英語への翻訳ペアの一部は、タミル語、中国語、ポーランド語、イタリア語、ヘブライ語であり、これらはモデル開発者が一般的に利用できる、大規模で十分に整備された英語の学習コーパスが存在するソース言語です。その一つの方向以外では、DeepSeekの優位性は、英語からの翻訳、および非英語言語ペア間の翻訳の双方において、ほぼあらゆるケースで維持されます。
これにより排除されるのは、どちらかのモデルを万能なデフォルトとして扱うことです。製品リストをスペイン語から6言語に翻訳するチームが、中国語のサポートチケットを英語に翻訳した際に見られたものと同じ性能ランキングを期待しているとすれば、それは誤った方向から誤った教訓を適用していることになります。これは、MachineTranslation.comの スペイン語から英語へのモデル分析に現れているものと同じ非対称性であり、そこでは上位のモデルが逆方向で上位になるモデルとは異なります。
QwenとDeepSeekは無料でオープンソースですか?
ライセンスの適用はそれぞれ異なります。DeepSeekは、最も寛容なオープンソースライセンスの一つであるMITライセンスの下でV4 ProとV4 Flashの両方を提供しているため、どちらも制限なしに無料でセルフホストできます。Qwenは分かれています:Qwen3.8-27BはApache 2.0の下でリリースされており、無料でセルフホストできますが、フラッグシップモデルであるQwen3.8-Maxはクローズドソースのままで、API提供のみ、かつAlibaba独自のカスタムライセンスの下で提供されています。
実質的には、DeepSeek側には両方の品質層で、完全にオープンウェイトかつMITライセンスの選択肢が存在することを意味します。Qwen側では、オープンウェイトを選択することは、フラッグシップモデルを諦めることを意味します。
QwenとDeepSeekを大規模に運用する場合のコストはどのくらいですか?
2026年5月のDeepSeekの恒久的な値下げに伴い、現在公表されているAPI料金は、V4 Proが出力100万トークンあたり$0.435 per million input tokens (cache miss) and $0.87であり、V4 Flashはレイテンシ最適化層としてさらに低価格に設定されています。
ホスト型APIを使用する代わりにどちらかのモデルをセルフホストするチームの場合、コストの比較は完全にGPUインフラストラクチャへと移行し、トークンあたりの料金ではなく、パラメータ数とアクティブパラメータの効率の関数になります。
どちらかのモデルは、法律、医療、または規制対象のコンテンツに対して十分に安全ですか?
どちらのモデルも翻訳に特化した安全性認証を公開しておらず、一般的な安全性ベンチマークでは、規制対象 of コンテンツにおいて重要となる失敗モード(用量の誤訳、免責条項のずれ、不整合な法的用語など)のテストは行われません。MachineTranslation.com独自のテストでは、法律および医療分野の言語において、モデル間でまさにこの種の相違が見出されています。これには、一般的な品質指標で双方とも高得点を獲得しているにもかかわらず、モデルが 異なる適用範囲を持つ異なる法的用語 を使用したケースも含まれます。
契約書、移民書類、または臨床コンテンツにおいては、どちらのモデルが生成したかにかかわらず、単一のAI出力を額面通りに信頼するのではなく、どちらのモデルの出力であっても 人間の翻訳確認ステップ と組み合わせるべき理由がここにあります。
同時に多くの言語にローカライズする場合、これは何を意味しますか?
1つの言語ペアに基づいて構築された比較は、40番目のペアについてはほとんど何も教えてくれません。ここで文書化された「英語への翻訳/英語からの翻訳」の分岐が98の言語ペアのサンプル全体で維持されたのは、まさにその規模でテストされたためです。大半のQwen対DeepSeekの比較で実行されるような、単一の英語からスペイン語へのテストだけでは、DeepSeekが余裕でリードしていることしか示されず、タミル語、ポーランド語、またはヘブライ語がパイプラインに入ってきたときに何が起こるかについては何もわかりません。
これこそが、大規模なローカリゼーションプログラムをデフォルトで単一のモデルの出力に固定すべきではないという実用的な論拠です。MachineTranslation.comは、すべての翻訳においてQwenとDeepSeek、さらには20以上の他のモデルを実行し、それらのモデルが最も合意したバージョンを提示します。そのため、68言語での展開が、誰かが最初にテストした1つの言語ペアでたまたま勝利したモデルに左右されることはありません。任意の翻訳においてどのモデルが合意し、どのモデルが相違したかは、プラットフォームがすべての結果に対して表示する 翻訳ごとのモデル内訳 で正確に確認できます。
すべての翻訳は、QwenやDeepSeekが単独で提供できるよりも幅広いモデルに対してチェックされます。これこそが、コンテンツの翻訳方向が一つだけでなくなったときに何が起こるかに対する直接的な答えです。
よくある質問
1.翻訳にはQwenとDeepSeekのどちらが優れていますか?
同一の原文でテストされた98の言語ペアにおいて、DeepSeekは83のペアでより高いスコアを獲得しました。Qwenが勝利したケースは、一つの特定の方向に集中しています。それは英語への翻訳であり、約3分の1の割合でQwenが勝利しています。それ以外のすべての方向において、DeepSeekは90%以上の確率で勝利しています。
2.Qwenは無料で利用できますか?
Qwen3.8-27BはApache 2.0の下でオープンウェイトとして提供されており、無料でセルフホストが可能です。フラッグシップモデルであるQwen3.8-Maxはクローズドであり、Alibaba Cloudの有料APIを通じてのみ利用可能です。
3.DeepSeekは無料で利用できますか?
はい。DeepSeek V4 ProとV4 FlashはどちらもMITライセンスのオープンウェイトで提供されているため、ライセンス費用なしでいずれかをセルフホストできます。DeepSeekは、自社インフラの管理を希望しないチーム向けに有料APIも提供しています。
4.QwenとDeepSeekのどちらが高速ですか?
DeepSeek V4 Flashは低レイテンシ向けに特別に構築されており、トークンあたりのアクティブパラメータ数はV4 Proの490億に対して130億です。Qwenの同等レベルのより軽量な選択肢であるQwen3.8-27Bは、mixture-of-expertsではなくデンスモデルであるため、同等の品質において一般的にトークンあたりの速度が遅くなります。
5.翻訳にQwenとDeepSeekを組み合わせて使用することはできますか?
はい。MachineTranslation.comは、すべての翻訳においてこれら両方のモデルに加えて20以上の他のモデルを実行し、最も一致するバージョンを提示します。そのため、1つのモデルを選択してそれが特定の言語ペアに対してより強力な選択肢であることを期待する、という状況に陥ることはありません。
6.QwenとDeepSeekのライセンスの違いは何ですか?
DeepSeekは両方のV4バリアントを、利用可能な最も寛容なオープンソースライセンスの1つであるMITライセンスの下でライセンス提供しています。Qwenのラインナップは分かれています。Qwen3.8-27Bのような小型モデルはApache 2.0の下で提供されますが、フラッグシップのQwen3.8-Maxはカスタムライセンスの下で非公開のままです。