May 8, 2026
Grok vs. Claude trong dịch thuật: kết quả benchmark cho thấy điều gì (2026)
Grok (xAI) và Claude (Anthropic) đều là những công cụ dịch thuật AI có năng lực, nhưng chúng có những thế mạnh khác biệt về mặt cấu trúc. Đối với hầu hết các tác vụ dịch thuật thông thường, bạn sẽ không nhận thấy sự khác biệt đáng kể giữa chúng. Đối với hai trường hợp cụ thể (dịch nội dung về các sự kiện gần đây và dịch các tài liệu chính thức yêu cầu độ chính xác), sự khác biệt là có thật và bắt nguồn từ cách mỗi mô hình được xây dựng.
Bài viết này đề cập đến những gì mỗi mô hình thực sự cung cấp cho việc dịch thuật, vị trí của chúng theo các đánh giá độc lập, và nên sử dụng phương án nào khi kết quả đầu ra của riêng từng mô hình là không đủ.
Grok và Claude so sánh với nhau như thế nào về chất lượng dịch thuật?
Câu trả lời ngắn gọn là: Claude dẫn đầu trong các bài kiểm tra đánh giá dịch thuật chuyên nghiệp độc lập. Lợi thế đặc thù của Grok là khả năng truy cập kiến thức theo thời gian thực, chứ không phải chất lượng dịch thuật tổng thể.
Trong các đánh giá hiệu năng nội bộ của MachineTranslation.com, Claude (phiên bản 3.5 Sonnet) đạt 93.8 trên 100 điểm về chất lượng dịch thuật — kết hợp giữa độ chính xác, thuật ngữ và văn phong. Grok không xuất hiện trong top 14 giải pháp trong báo cáo State of Translation Automation 2025 của Intento, vốn đánh giá 46 công cụ MT và LLMs trên 11 cặp ngôn ngữ. Cả Claude Opus 4 và Claude Sonnet 3.7 đều xuất hiện trong top 14. Nguồn: Đánh giá hiệu năng nội bộ của MachineTranslation.com; Báo cáo Thực trạng Tự động hóa Dịch thuật 2025 của Intento.
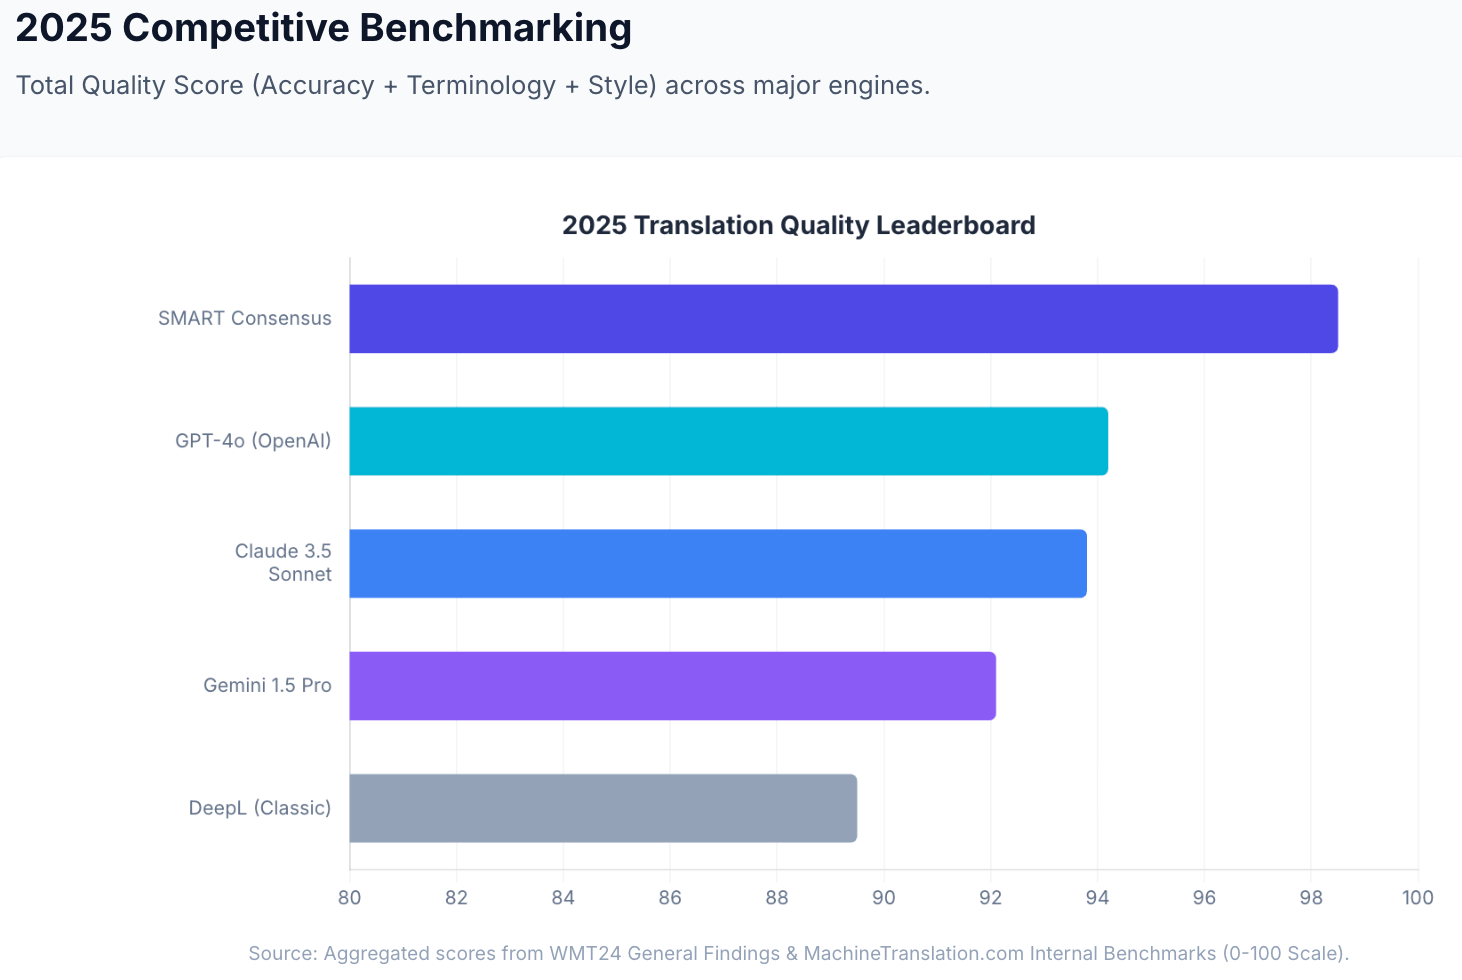
Tại WMT24 (cuộc thi đánh giá hiệu năng độc lập hàng đầu của ngành dịch thuật), Claude 3.5 xếp thứ nhất ở 9 trên 11 cặp ngôn ngữ, vượt qua GPT-4 và các công cụ dịch máy nơ-ron chuyên dụng. Trong nghiên cứu mù năm 2025 của Lokalise do các dịch giả chuyên nghiệp thực hiện, 78% bản dịch của Claude 3.5 được đánh giá là tốt — mức cao nhất trong số các LLM được thử nghiệm.
Grok chưa được đánh giá trong WMT24 hoặc trong đánh giá LQA độc lập của Intento ở mức độ tương đương. The Slator Pro Guide (2025) liệt kê Grok là một trong những LLM đa dụng được sử dụng để dịch thuật trong môi trường chuyên nghiệp, bên cạnh GPT và Claude, nhưng không xếp hạng nó cao hơn cả hai.
| Benchmark | Grok | Claude |
|---|---|---|
| Điểm chất lượng nội bộ của MachineTranslation.com | Không được đo lường ở cấp độ benchmark | 93.8/100 (cấp độ 3.5 Sonnet) |
| Top 14 giải pháp của Intento 2025 | Không có trong danh sách | Cả Claude Opus 4 và Sonnet 3.7 đều có trong danh sách |
| Các cặp ngôn ngữ WMT24 | Không được đánh giá | Xếp thứ 1 trong 9/11 cặp ngôn ngữ |
| Nghiên cứu mù Lokalise 2025 | Không được đánh giá | 78% tốt (cao nhất trong số các LLM) |
Nguồn: Đánh giá hiệu năng nội bộ của MachineTranslation.com; Báo cáo Tình trạng Tự động hóa Dịch thuật Intento 2025; Kết quả dịch máy chung WMT24; Lokalise 2025.
Grok thực sự có lợi thế ở đâu?
Dịch thuật thời gian thực và sự kiện thời sự. Đặc điểm kiến trúc đặc trưng của Grok là sự tích hợp của nó với dữ liệu nền tảng X (trước đây là Twitter) và tìm kiếm internet trực tiếp. Không giống như Claude và hầu hết các LLMs khác, vốn được huấn luyện trên các tập dữ liệu tĩnh với giới hạn kiến thức cố định, Grok tích hợp thông tin thời gian thực vào kết quả đầu ra của mình. Đối với các tác vụ dịch thuật liên quan đến các sự kiện gần đây, các sản phẩm mới ra mắt, thuật ngữ chính trị mới nổi, tin tức thời sự, hoặc nội dung đề cập đến những việc đã xảy ra trong vài tuần qua, Grok có quyền truy cập vào bối cảnh mà Claude không có.
Điều này đặc biệt quan trọng đối với: dịch các bài báo về các sự kiện gần đây, bản địa hóa các thông báo sản phẩm cho các thị trường biến động nhanh, xử lý các thuật ngữ hoặc tiếng lóng mới được tạo ra sau dữ liệu đào tạo của các mô hình khác, và bất kỳ nội dung nào mà ý nghĩa phụ thuộc vào việc biết những gì đã xảy ra gần đây.
Các thuật ngữ mới nổi và đang phát triển. Các lĩnh vực kỹ thuật, ngành công nghiệp và bối cảnh văn hóa liên tục tạo ra các thuật ngữ mới. Đối với các tác vụ dịch thuật liên quan đến các thuật ngữ mới được tạo ra gần đây, ngôn ngữ quy định mới hoặc danh pháp sản phẩm mới, quá trình đào tạo được cập nhật và tính năng tìm kiếm theo thời gian thực của Grok giúp nó tiếp cận được các cách thức sử dụng mà các ảnh chụp nhanh dữ liệu đào tạo cũ hơn không ghi nhận được.
Cửa sổ ngữ cảnh và khả năng lập luận của Grok 4.1. Grok 4.1 (tính đến cuối năm 2025) sở hữu cửa sổ ngữ cảnh 131K-token và khả năng suy luận được cải thiện, giúp nó xử lý tốt các tài liệu phức tạp, nhiều tầng nơi mối quan hệ giữa các điều khoản và tính mạch lạc logic đóng vai trò quan trọng.
Claude có lợi thế thực sự ở điểm nào?
Chất lượng dịch thuật trên các benchmark độc lập. Lợi thế của Claude được ghi nhận bởi đánh giá chuyên môn độc lập chứ không phải các tuyên bố tự công bố. WMT24 xếp Claude 3.5 đứng đầu trong 9 trên 11 cặp ngôn ngữ so với toàn bộ các đối thủ cạnh tranh. Nghiên cứu mù năm 2025 của Lokalise cho thấy các dịch giả chuyên nghiệp ưa thích kết quả đầu ra của Claude 3.5 với tỷ lệ tốt đạt 78% — cao hơn GPT-4, DeepL và Google Translate trong cùng cuộc đánh giá. Đây là các đánh giá mù: các dịch giả chuyên nghiệp đã đánh giá bản dịch đầu ra mà không biết mô hình nào đã tạo ra nó.
Các cặp ngôn ngữ cụ thể theo Intento 2025. Claude Opus 4 và Sonnet 3.7 xuất hiện trong danh mục tốt nhất cho các cặp dịch tiếng Anh sang tiếng Đức, tiếng Anh sang tiếng Nhật, tiếng Anh sang tiếng Ý, tiếng Anh sang tiếng Hàn, tiếng Anh sang tiếng Hà Lan, tiếng Anh sang tiếng Ả Rập, và tiếng Anh sang tiếng Pháp trong đánh giá LQA bằng con người của Intento. Đối với các cặp này, Claude là lựa chọn được ghi nhận là mạnh hơn trong cả hai.
Độ chính xác về tông giọng và nội dung sắc thái. Các dịch giả chuyên nghiệp trong nghiên cứu của Lokalise ưa chuộng kết quả đầu ra của Claude với tỷ lệ cao nhất so với bất kỳ LLM nào — phản ánh thế mạnh đã được ghi nhận của Claude trong việc duy trì văn phong, giọng điệu tác giả và ý nghĩa ngữ cảnh. Đối với dịch thuật văn học, tài liệu pháp lý, giao tiếp chính thức và nội dung tiếp thị, nơi mà cách thức diễn đạt cũng quan trọng như nội dung được truyền tải, Claude luôn thể hiện tốt qua các đánh giá độc lập.
Tính mạch lạc của tài liệu dài. Claude 4.6 Sonnet hỗ trợ cửa sổ ngữ cảnh 200K token, với Claude Opus 4.6 hỗ trợ 1M token trong phiên bản beta. Đối với các tài liệu chính thức dài (hợp đồng, hướng dẫn kỹ thuật, báo cáo thử nghiệm lâm sàng), Claude có thể xử lý toàn bộ tài liệu trong một lượt duy nhất, duy trì sự nhất quán về thuật ngữ xuyên suốt. Tài liệu được xử lý theo từng phần cho thấy tỷ lệ không nhất quán về thuật ngữ cao hơn 28% so với xử lý toàn bộ tài liệu. Nguồn: Dữ liệu nội bộ của MachineTranslation.com.
Chúng so sánh thế nào về hỗ trợ ngôn ngữ và giá cả?
Hỗ trợ ngôn ngữ: Cả Grok 4.1 và Claude 4.6 đều hỗ trợ dịch thuật trên hầu hết các ngôn ngữ lớn trên thế giới. Claude đã được đánh giá độc lập trên các cặp ngôn ngữ châu Âu và Đông Á với kết quả xuất sắc. Khả năng hỗ trợ đa ngôn ngữ của Grok đã được cải thiện qua các phiên bản liên tiếp. Đối với các ngôn ngữ ít tài nguyên, cả hai mô hình đều bị giảm chất lượng — việc đánh giá bởi con người là phù hợp cho nội dung thuộc các cặp ngôn ngữ ít tài nguyên bất kể mô hình nào được sử dụng.
Bảng giá:
| Gói | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Người dùng cá nhân (hàng tháng) | SuperGrok: $30/tháng | Claude Pro: $20/tháng |
| Đầu vào API (trên mỗi triệu token) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Đầu ra API (trên mỗi triệu token) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Gói miễn phí | Có (bị giới hạn tần suất qua X/Grok.com) | Có (bị giới hạn tần suất qua claude.ai) |
Ở phân khúc người dùng cá nhân, Claude Pro ($20/month) is cheaper than SuperGrok ($30/tháng). Ở cấp độ API, Grok 4.1 có lợi thế nhỏ về chi phí so với Claude Sonnet 4.6 đối với các quy trình dịch thuật có lượng dữ liệu đầu vào lớn.
Lựa chọn nào tốt hơn cho các loại nội dung cụ thể?
| Loại nội dung | Mô hình đề xuất | Lý do |
|---|---|---|
| Tin tức gần đây / sự kiện thời sự | Grok | Truy cập dữ liệu thời gian thực; các mô hình được huấn luyện tĩnh thiếu ngữ cảnh hiện tại |
| Thuật ngữ mới nổi / các đợt ra mắt sản phẩm mới | Grok | Tích hợp tìm kiếm trực tiếp giúp nắm bắt các xu hướng sử dụng gần đây |
| Tài liệu pháp lý chính thức | Claude | Đánh giá độc lập từ WMT24 và Lokalise 2025; độ chính xác về giọng điệu |
| Nội dung y tế / lâm sàng | Claude | Vị thế trong các bài kiểm tra hiệu năng độc lập; bảo toàn văn phong |
| Bản thảo marketing / nội dung sáng tạo | Claude | Sự ưu tiên trong nghiên cứu mù của Lokalise 2025; sắc thái giọng điệu |
| Tài liệu kỹ thuật (dài) | Claude | Cửa sổ ngữ cảnh 200K-1M; tính nhất quán của thuật ngữ xuyên suốt độ dài văn bản |
| Mạng xã hội / nội dung hội thoại | Cả hai | Cả hai đều xử lý tốt các cặp ngôn ngữ hội thoại có tài nguyên lớn |
| Nhà phát triển / tích hợp API | Cả hai | Cả hai đều cung cấp quyền truy cập API; Grok rẻ hơn một chút về token đầu vào |
Nên dùng gì khi một mô hình là không đủ
Cả Grok và Claude đều là các công cụ đơn mô hình. Mỗi mô hình AI riêng lẻ (bất kể năng lực của nó đến đâu) đều tạo ra những lỗi mà chính nó không thể tự phát hiện trong kết quả đầu ra của mình. Một bản dịch trôi chảy, tự tin từ Grok hoặc Claude vẫn có thể bị sai về mặt ngữ nghĩa, và nếu không kiểm tra chéo thì không có cách nào để biết được.
Cả Grok và Claude đều nằm trong số 22 mô hình thuộc hệ thống SMART của MachineTranslation.com. SMART chạy đồng thời tất cả 22 mô hình (bao gồm cả Grok và Claude) và trả về kết quả mà đa số đồng thuận.
Điều này có ý nghĩa gì đối với câu hỏi Grok vs. Claude: Sức mạnh thời gian thực của Grok và chiều sâu ngữ cảnh của Claude đều góp phần tạo nên cùng một sự đồng thuận. Khi chúng đồng thuận, sự đồng thuận đó là một tín hiệu mạnh mẽ về chất lượng.
Trong các đánh giá chuẩn nội bộ của MachineTranslation.com, các mô hình hàng đầu riêng lẻ đạt điểm 93-94 trên 100 về chất lượng dịch thuật. Đầu ra đồng thuận của SMART đạt 98.5/100. Nguồn: Các đánh giá hiệu năng nội bộ của MachineTranslation.com và Các phát hiện về Dịch máy Tổng quát WMT24.
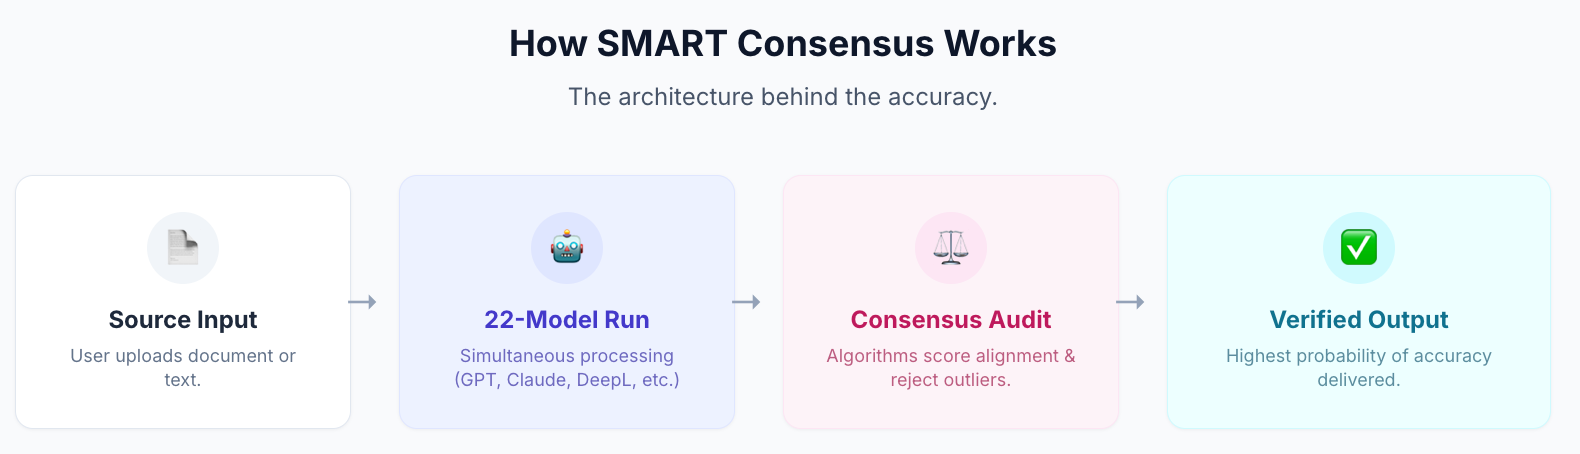
Người dùng chuyển từ dịch thuật bằng một công cụ duy nhất sang SMART đã dành ít hơn 27% thời gian để xác minh và chỉnh sửa kết quả đầu ra. Nguồn: Dữ liệu nội bộ của MachineTranslation.com.
Đối với nội dung có tính rủi ro cao (tài liệu pháp lý, hồ sơ quản lý, hướng dẫn y tế), Xác minh bởi con người sẽ chuyển tiếp sự đồng thuận SMART đến một chuyên gia đánh giá chuyên nghiệp được chứng nhận trong cùng một nền tảng. Không có đơn vị bên ngoài. Đảm bảo chính xác 100%.
Dịch bằng Grok, Claude và 20 mô hình khác tại MachineTranslation.com — miễn phí, không cần đăng ký.
Câu hỏi thường gặp
1. Grok có tốt hơn Claude trong việc dịch thuật không?
Đối với hầu hết các tác vụ dịch thuật tiêu chuẩn, Claude dẫn đầu trong các bài kiểm tra đánh giá độc lập: đứng đầu ở 9 trên 11 cặp ngôn ngữ tại WMT24, đạt tỷ lệ đánh giá tốt 78% trong thử nghiệm mù năm 2025 của Lokalise, và đạt 93.8/100 trong các bài kiểm tra đánh giá chất lượng nội bộ của MachineTranslation.com. Lợi thế đặc biệt của Grok là đối với các nội dung yêu cầu kiến thức về các sự kiện thời sự, khả năng truy cập dữ liệu thời gian thực mang lại cho nó bối cảnh mà các mô hình được huấn luyện tĩnh, bao gồm cả Claude, không có. Đối với tin tức gần đây, thuật ngữ mới nổi và nội dung có tính thời điểm, Grok là lựa chọn tốt hơn.
2. Lợi thế của Grok so với Claude trong dịch thuật là gì?
Grok tích hợp dữ liệu thời gian thực từ X (trước đây là Twitter) và tìm kiếm internet trực tiếp. Không giống như Claude và hầu hết các LLM khác được huấn luyện trên các tập dữ liệu tĩnh, Grok có thể truy cập thông tin về các sự kiện gần đây, các thuật ngữ mới được đặt ra và bối cảnh hiện tại khi tạo bản dịch. Điều này giúp nó đặc biệt mạnh mẽ hơn trong việc dịch nội dung tin tức, các sản phẩm mới ra mắt gần đây, và bất kỳ tài liệu nào mà ý nghĩa phụ thuộc vào các sự kiện hoặc mẫu ngôn ngữ từ vài tuần qua.
3. Lợi thế của Claude so với Grok trong việc dịch thuật là gì?
Lợi thế của Claude được ghi nhận thông qua đánh giá chuyên môn độc lập. Claude 3.5 đứng đầu ở 9 trên 11 cặp ngôn ngữ tại WMT24, và các dịch giả chuyên nghiệp trong nghiên cứu mù năm 2025 của Lokalise ưa chuộng kết quả đầu ra của nó với tỷ lệ tốt là 78% — mức cao nhất so với bất kỳ LLM nào được thử nghiệm. Claude cũng xuất hiện trong top 14 giải pháp của Intento trên nhiều cặp ngôn ngữ trong đánh giá LQA bởi con người, trong khi Grok thì không. Đối với các tác vụ dịch thuật trang trọng, chuyên nghiệp và có tính chất quan trọng, vị thế benchmark độc lập của Claude chính là yếu tố khác biệt đã được ghi nhận.
4. Grok hay Claude tốt hơn cho dịch thuật pháp lý?
Claude là lựa chọn vượt trội hơn cho dịch thuật pháp lý dựa trên đánh giá độc lập. Claude 3.5 xếp thứ nhất ở hầu hết các cặp ngôn ngữ châu Âu tài nguyên cao tại WMT24 và nhận được đánh giá mức độ ưa chuộng cao nhất trong nghiên cứu mù từ các dịch giả chuyên nghiệp. Đối với nội dung pháp lý yêu cầu độ chính xác được chứng nhận, không một mô hình riêng lẻ nào là đủ — tính năng Human Verification của MachineTranslation.com cung cấp độ chính xác 100% từ một chuyên gia đánh giá chuyên nghiệp được chứng nhận ngay trên cùng một nền tảng, không cần nhà cung cấp bên ngoài.
5. Cả Grok và Claude đều có trên MachineTranslation.com phải không?
Có. Cả hai đều nằm trong số 22 mô hình thuộc hệ thống SMART của MachineTranslation.com. Mỗi bản dịch SMART chạy đồng thời Grok, Claude và 20 mô hình khác, trả về kết quả mà đa số đồng thuận. Thay vì phải lựa chọn giữa chúng, bạn nhận được sự đồng thuận của tất cả các mô hình AI.
6. Grok và Claude so sánh về giá cả như thế nào?
Ở phân khúc người dùng cá nhân, Claude Pro có giá $20/month versus SuperGrok at $30/tháng. Ở cấp độ API, Grok 4.1 rẻ hơn một chút về token đầu vào ($2/M vs. $3/M cho Claude Sonnet 4.6) và đầu ra ($10/M vs. $15/M). Gói miễn phí của MachineTranslation.com bao gồm cả hai mô hình như một phần của sự đồng thuận 22 mô hình của SMART, không cần đăng ký.
7. Mô hình AI nào tốt nhất để dịch các bài báo?
Đối với việc dịch các bài báo, Grok có lợi thế về mặt cấu trúc: việc tích hợp dữ liệu thời gian thực của nó đồng nghĩa với việc nó có bối cảnh hiện tại về các sự kiện đang được mô tả, điều mà các mô hình huấn luyện tĩnh có thể thiếu. Đối với dịch thuật tin tức chung khi tính cập nhật không quá quan trọng, hiệu suất benchmark của Claude mạnh hơn. Đối với dịch thuật tin tức với khối lượng lớn, nơi mà cả tính cập nhật và độ chính xác đều quan trọng, SMART của MachineTranslation.com chạy cả hai mô hình và trả về kết quả đồng thuận của chúng.