October 9, 2026
Qwen vs ChatGPT:どちらのAIモデルがより優れた翻訳をするのか?
ChatGPTの現行世代 および Qwen は、いずれもMachineTranslation.comがすべての翻訳で実行するモデル群の一部であり、プラットフォーム自体と比較評価される2つの外部の競合相手というわけではありません。同一のセグメントで同じテキストを両方のモデルで処理すると、全体としてはChatGPTの方が多くの言語ペアで高い評価を得ます。しかし、翻訳の方向別に結果を分類すると、英語への翻訳という特定のケースにおいてその差が大幅に縮まり、両者はほぼ互角となります。
翻訳においてChatGPTより優れたAIは存在するのか?
競合モデルの性能向上に伴い、ChatGPTの代替となるモデルへの一般的な関心は高まっていますが、その理由はユースケースによって大きく異なり、ひとつの説明で片付けられるものではありません。特に翻訳に関しては、どちらのモデルが特定の言語ペアで実際に優れた性能を発揮するかという、感覚的な問題ではなく検証可能な問いを立てることがより有益です。
MachineTranslation.comの過去28日間のトラフィックにおいて、両モデルは98の言語ペアにわたり同一の原文を翻訳しました。そのうち77のペアでChatGPTの方が高いスコアを獲得し、Qwenの方が高かったのは21ペアでした。一致する出力全体の加重平均スコアは、ChatGPTが10点中9.10点、Qwenが8.98点でした。これは平均すると確かにわずかな差ですが、翻訳の方向性を加味すると、はるかに明確な違いが隠されていることがわかります。
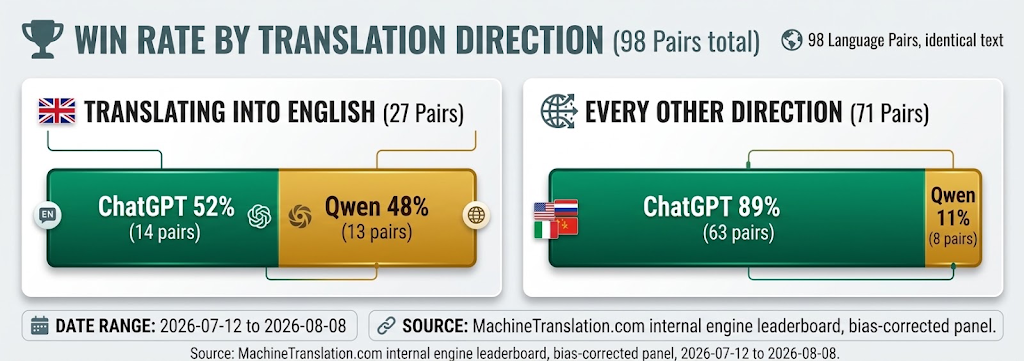
英語への翻訳においては、両モデルはほぼ同等の結果を残しています。それ以外のすべての翻訳方向では、テストされた言語ペアの大半でChatGPTが勝利しています。
| ChatGPT | Qwen | |
|---|---|---|
| スコア評価された出力の割合 | 54.76% | 42.6% |
| 平均スコア | 8.89 / 10 | 8.87 / 10 |
| 下位10%のスコア | 7.8 | 7.6 |
| 英語への翻訳における勝率 | 52% | 48% |
| その他すべての言語方向における勝率 | 89% | 11% |
なぜ英語への翻訳では差がほぼなくなるのか?
データは差が生じている箇所を示しているだけで、その理由を示しているわけではありません。明らかなのは、Qwenの競争力が均等に発揮されているわけではないということです。翻訳先言語が英語である27の言語ペアのうち、Qwenは13ペアで勝利しており、実質的にコイントス(ほぼ互角)の状態です。英語からの翻訳と2つの非英語言語間の翻訳の両方を含む残りの71ペアでは、ChatGPTがその89%にあたる63ペアで勝利しています。Qwenの英語への翻訳におけるパフォーマンスが、英語からの翻訳や非英語ペア間の翻訳にも通じると想定することは、誤った方向から誤った教訓を引き出すことになります。
Qwenは中国の企業なのか、そしてそれは翻訳において重要なのか?
Qwenは中国に拠点を置くAlibaba Cloudによって開発されています。それ自体がモデルによる文の翻訳精度を左右するわけではなく、上記のデータはモデルがどこで構築されたかに関係なく、実際の出力品質を反映しています。重要となり得るのはデータ処理の面です。規制対象のコンテンツや機密性の高いコンテンツ(契約書、医療記録、個人情報)を翻訳する企業は、AIプロバイダーがそうしたコンテンツをどこで処理し保存しているかという問題を、翻訳品質そのものとは別の、実質的なデューデリジェンス項目として扱う必要があります。これはQwenに限らずあらゆるAIプロバイダーに当てはまることであり、MachineTranslation.comがこの問題を未解決のままにせず、自社のデータ処理およびセキュリティプラクティスを直接公開している理由の一つでもあります。
法務やビジネス翻訳において、どちらかのモデルの方がより信頼性が高いのか?
一貫してそうとは言えません。また、その違いは必ずしもどちらのモデルが高スコアを獲得するかだけの問題ではありません。MachineTranslation.comが実際の契約書の文章を用いて行った検証では、法務テキストにおいてどちらかのモデルを信頼する前に知っておくべき2つの事例が見つかりました。慣用表現では逆の現象が起きることもあります。別の直接対決テストでは、ChatGPTがドイツ語の慣用句を文字通りに訳して誤訳したのに対し、Qwenは正しい慣用的な意味を捉えていました。これは、集計データにおける全体的な優位性が、一文一文のレベルでは必ずしも当てはまらないことを思い起こさせます。
| テストケース | ChatGPT | Qwen |
|---|---|---|
| ドイツ語への「At-will employment」の翻訳 | 実用的で機能する表現 | 無関係な法的概念を適用 |
| スペイン語への責任限定条項の翻訳 | 「que surjan de」 | 「derivados de」(適用範囲を変えてしまう差異) |
| 「Ich verstehe nur Bahnhof」(ドイツ語の慣用句) | 直訳され、不正確 | 正しい慣用的な意味 |
これら3つのケースにおいて、どちらのモデルも一貫して優れているわけではありません。モデルの全体的な集計スコアは、特定の用語やフレーズにおける挙動を予測するものではないのです。だからこそ、どちらのモデルが初稿を作成したかにかかわらず、法務や契約関連のテキストには人手による確認ステップが不可欠なのです。
言語カバレッジについてはどうでしょうか?
ChatGPTもQwenも、翻訳品質が低下する言語ペアについての検証済みかつ第三者によって確認されたリストを公開していません。どちらも広範な多言語トレーニングを受けた汎用モデルですが、これは特定の言語セットにおける実測された翻訳性能とは異なる主張です。MachineTranslation.comは、モデルの一般的な言語能力を実際の翻訳精度の代用として信頼するのではなく、330以上の言語にわたって翻訳品質を直接テストおよびスコアリングしています。
ビジネス翻訳のためにChatGPTやQwenに貼り付けるべきではないものは何ですか?
ChatGPTもQwenも専用の翻訳プラットフォームとして構築されたわけではなく、機密性の高いビジネスコンテンツを汎用チャットインターフェースに直接貼り付けることには、他のコンシューマー向けAIツールに貼り付ける場合と同様のデータ処理に関する懸念が伴います。つまり、入力データがどこで処理され、保持されるのか、誰がアクセスできるのかという問題です。契約書、医療記録、移民関連書類、財務諸表などは、翻訳後ではなく翻訳前にその問いに答えるべき典型的なコンテンツです。これが、基盤となるモデルが何であれ、公開され検証可能なデータ処理慣行を備えた専用の翻訳プラットフォームが、汎用チャットインターフェースとは根本的に異なる選択肢となる明確な理由です。
MachineTranslation.comが実際に両方のモデルを活用する方法
MachineTranslation.comは、すべての翻訳でChatGPT、Qwen、および20を超える他のAIモデルを実行し、それらのモデル間で最も意見が一致したバージョンを提示します。QwenとChatGPTの性能が翻訳方向によって大きく分かれることを考慮すると、一方のモデルを一律のデフォルトとして選択することは、予測可能な一定割合の言語ペアで誤った選択をすることを意味します。翻訳方向に依存するこの同様のパターンは、MachineTranslation.comのQwen対DeepSeekの比較でも見られます。現在の各モデルが互いにどのようにテストされているかの全体像については、MachineTranslation.comの完全なモデル比較テストをご覧ください。
よくある質問
1. 翻訳にはQwenとChatGPTのどちらが優れていますか?
同一のソーステキストでテストされた98の言語ペアのうち、ChatGPTは77のペアでより高いスコアを獲得しました。Qwenが最も強みを発揮するのは英語への翻訳であり、この分野では両者がほぼ互角です。それ以外のすべての方向ではChatGPTが大多数のペアで優勢であるため、率直な答えとしては、コンテンツがどちらの言語方向に翻訳されるかに大きく依存します。
2. ChatGPTとQwenのどちらがより多くの言語をサポートしていますか?
どちらも汎用AIモデルであり、言語ごとの制限について検証・公開されたリストはありません。どちらも第三者によって確認された言語ペアのカバレッジデータを公開しておらず、多言語トレーニングに関する一般的な主張に頼るのではなく、330以上の言語にわたって翻訳品質を直接テストおよびスコアリングするプラットフォームとは異なります。
3. 法務およびビジネス翻訳にはQwenとChatGPTのどちらが優れていますか?
全面的にどちらかが確実に優れているということはありません。ドイツの雇用法の用語をテストした際、DeepSeekとChatGPTは実用的な機能的表現を生成した一方、ClaudeとQwenはどちらも無関係な法的概念を引き合いに出しました。これは、一般的にどちらのモデルが強いかではなく、用語や文脈によって結果が分かれることを示しています。
4. MachineTranslation.comはChatGPTやQwenと競合していますか?
いいえ。MachineTranslation.comは、すべての翻訳においてChatGPT、Qwen、および20を超える他のAIモデルを実行し、それらのモデル間で最も意見が一致したバージョンを提示します。単独の競合モデルとして機能するのではなく、これらのモデルをテストして組み合わせます。
5. 大規模なローカリゼーションプロジェクトにはどのモデルを選ぶべきですか?
コンテンツが多数の言語にわたって双方向に移動する場合、どちらか一方のみを安全なデフォルトとすることはできません。ここで示された翻訳方向による差異は、英語への翻訳で優れた性能を発揮するモデルであっても、英語からの翻訳では、一度に数十もの言語ペアにわたって全く異なる性能を示す可能性があることを意味します。
6. 翻訳にはどのQwenモデルが最適ですか?
現時点ではまだ確認できません。他のプロバイダーとは異なり、MachineTranslation.comのトラッキングでは現在、Qwenをモデルバージョンのタグなしで単一のエンジンとして記録しているため、報告できるサブバージョンごとの品質データが存在しません。これが修正されれば、Qwen3.8-MaxとQwen3.8-27Bの詳細な比較が可能になりますが、現時点では、これは単なる未測定の細部ではなく、明確なデータの空白となっています。