November 13, 2026
翻訳におけるQwen vs Gemini、そして翻訳方向が重要な理由
手元に2つのモデルと言語ペアのリストがあり、プロジェクトをどちらのモデルに任せるべきかを判断しなければならないとします。QwenとGeminiの比較の多くは、1つの総合スコアで結論を出しています。しかし、単一のスコアでは、結果を左右する要因である翻訳の方向が見えなくなってしまうと私は考えています。
私はMachineTranslation.comで稼働するモデルの検証方法に携わっているため、同一のテキストでスコア測定された98の言語ペアにおいてQwenとGeminiを比較することができます。そのうち68ペアでGeminiが、29ペアでQwenが高いスコアを獲得し、平均スコア差は10点満点中0.08点でした。この総合結果だけでは、ウルドゥー語から英語、あるいは英語からハイチクレオール語への翻訳でどちらのモデルを選ぶべきかはわかりません。
この記事では、両モデルの差がわずかである領域と、それぞれが優位に立つ領域を明らかにします。また、現時点では断言できない点についても説明します。今回のデータは、Googleが10月にGemini 4を発表する前の2026年8月8日までのものなので、両モデルの旧バージョンを対象としています。
主なポイント
- 同一テキストでスコア測定された98の言語ペア(2026年7月12日〜8月8日)において、Geminiが68ペア、Qwenが29ペアで高いスコアを記録し、1ペアは同点でした。
- 平均スコア差は小さく、Qwenの8.98点に対してGeminiは9.06点であり、98ペア中60ペアが0.1点差以内に収まっています。
- 英語への翻訳では、27ペア中7ペアでQwenが、3ペアでGeminiが0.1点を超える差をつけてリードしており、残りの17ペアは0.1点以内の差でした。
- 英語からの翻訳では、29ペア中13ペアでGeminiが0.1点を超える差をつけてリードしており、Qwenがリードしたペアはありませんでした。
- このデータはGoogleが2026年10月にGemini 4を発表する前のものであるため、以前のGeminiバージョンを対象としており、最新情報として扱うには再検証が必要です。
翻訳にはQwenとGeminiのどちらが優れているか?
それは方向によります。目的言語が英語である場合は両モデルの性能が拮抗しており、それ以外のペアの多くではGeminiの方が高いスコアを出しているためです。全98ペア中、Geminiは68ペアでより高いスコアを獲得しました。MachineTranslation.comによる2026年7月12日から8月8日までのスコアでは、Geminiの平均が10点満点中9.06点、Qwenが8.98点であり、平均差は0.08点でした。
この検証パネルでは、ChatGPT、Claude、DeepSeek、Gemini、Qwenのすべてが実際のスコアを獲得したセグメントのみを集計しているため、すべてのモデルが同一の原文テキストで評価されます。各言語ペアには少なくとも30のセグメントが含まれています。このパネルを使用しているのは、異なるテキストでモデル同士を比較するという、よくある誤りを排除するためです。
勝敗数で見ると、Geminiが68ペア(69%)、Qwenが29ペア(30%)でリードし、1ペアは同点でした。しかし、98ペア中60ペアが0.1点差以内であるため、勝敗数だけでは差が過大に見えてしまいます。次のセクションでは、結果を方向別およびスコア差別で詳しく見ていきます。
それぞれのモデルにはどの翻訳方向が有利か?
英語が原文言語である場合、またはどちらの言語も英語でない場合はGeminiが優位に立ち、英語が目的言語である場合はQwenがGeminiと同等かそれ以上の結果を出しています。英語からの翻訳では、29ペア中13ペアでGeminiが0.1点を超える差をつけてリードしており、Qwenがリードしたペアはありませんでした。英語への翻訳では、27ペア中7ペアでQwenがその差をつけてリードし、Geminiは3ペアでした。
| 翻訳方向 | ペア数 | Geminiが0.1ポイント超リード | 0.1ポイント以内 | Qwenが0.1ポイント超リード | 平均差 |
|---|---|---|---|---|---|
| 英語への翻訳 | 27 | 3 | 17 | 7 | Qwen +0.04 |
| 英語からの翻訳 | 29 | 13 | 16 | 0 | Gemini +0.16 |
| 英語以外の言語間 | 42 | 14 | 27 | 1 | Gemini +0.13 |
英語への翻訳では、27ペア中17ペアが0.1ポイント以内の差であり、Qwenが7ペア、Geminiが3ペアでリードしています。英語からの翻訳では、29ペア中16ペアが0.1ポイント以内の差であり、Geminiが13ペアでリードし、Qwenがリードしたペアはありません。両言語とも英語ではないペアでは、42ペア中27ペアが0.1ポイント以内の差であり、Geminiが14ペア、Qwenが1ペアでリードしています。
英語への翻訳において、Qwenは27ペア中24ペアでGeminiとの差が0.1ポイント以内であるか、Geminiを上回っています。方向別に平均すると、英語への翻訳ではQwenが約0.04ポイントリードしているのに対し、英語からの翻訳ではGeminiが約0.16ポイント、英語以外の2言語間ではGeminiが0.13ポイントリードしています。
なぜこのような差が生じるのかは分からず、今回のデータからそれを知ることもできません。最初に検証すべき説明としては各モデルのトレーニングデータの構成比が挙げられますが、その検証はまだ行っていません。QwenはChatGPTに対しても同様の傾向を示しています。同じ検証において、当社のQwen対ChatGPTの比較では、英語への翻訳において両者はほぼ互角であり、その他のペアではChatGPTが89%でリードしていました。
どの言語ペアで最も大きな差が見られますか?
最大の差がついたケースはいずれもGeminiが優勢です。ロシア語からカザフ語、英語からハイチ・クレオール語、英語からタガログ語、スペイン語からギリシャ語、アラビア語からペルシャ語において、Geminiは0.51から0.95ポイントリードしています。Qwenの最大のリード幅はそれよりも小さく、0.15から0.26ポイントにとどまり、上位5ペアのうち4ペアが英語への翻訳です。
| 言語ペア | Geminiスコア | Qwenスコア | 差 |
|---|---|---|---|
| ロシア語からカザフ語 | 9.27 | 8.32 | Gemini +0.95 |
| 英語からハイチ・クレオール語 | 9.19 | 8.27 | Gemini +0.92 |
| 英語からタガログ語 | 9.14 | 8.43 | Gemini +0.70 |
| スペイン語からギリシャ語 | 8.90 | 8.33 | Gemini +0.57 |
| アラビア語からペルシャ語 | 8.84 | 8.34 | Gemini +0.51 |
| ウルドゥー語から英語 | 8.56 | 8.81 | Qwen +0.26 |
| 中国語から英語 | 9.00 | 9.19 | Qwen +0.19 |
| スウェーデン語から英語 | 8.29 | 8.46 | Qwen +0.16 |
| 中国語からインドネシア語 | 9.03 | 9.19 | Qwen +0.16 |
| ビルマ語から英語 | 8.94 | 9.09 | Qwen +0.15 |
これらを最終的なランキングとして扱うべきではないでしょう。最も差が大きかったロシア語からカザフ語、英語からハイチ・クレオール語の2組は、言語ペアの中央値よりもサンプル数が少なくなっています。英語からタガログ語、スペイン語からギリシャ語、アラビア語からペルシャ語はより多くのサンプルに基づいているため、これら3組のほうが信頼できます。サンプル数が少ない2組のスコア差については、判断基準にする前に再テストを行うべきだと考えます。
0.1ポイントの差は何を意味するのか?
私の見解では、0.1点未満の差は勝者を決めるには小さすぎます。98組のペアのうち60組がその差の範囲内に収まっており、各ペアは限られた数のセグメントでスコア化されています。0.1という基準は私自身の暫定的な閾値であり、これらのペアについて有意性検定を実施したわけではありません。
また、スコアだけでは見落とされる違いもあります。一般的なフレーズのテストにおいて、アラビア語の「sorry」を22のAIモデルで処理しました。GeminiとQwenはどちらもカジュアルな「آسف」を選択しました。ChatGPTと統合結果はフォーマルな「عذرًا」を選択しました。どのモデルも9.5のスコアを獲得したため、2つの単語にはレジスター(言葉遣い・使用域)の違いがあるものの、スコアには変動がありませんでした。
だからこそ、私はスコア差とレジスターの具体例を併せて見ています。目に見えるレジスターの違いを伴うわずかな差については、人間の判断が必要です。サンプルの少ないペアにおける大きな差については、再テストが必要です。
QwenとGeminiでは、異なるタイプの間違いをしますか?
はい。2026年ワールドカップの引用文テストにおいて、両モデルとも他のモデルが選ばなかった表現を少なくとも1つ選択しており、スコアはほとんど動きませんでした。Geminiはエムバペ選手のフレーズを「with each game」と訳し、ヴィルツ選手の引用文を逐語訳したのに対し、Qwenはスカローニ監督の引用文に対して異なる解釈を示しました。これらの事例のスコアは9.2から9.5の範囲でした。
詳細は、ワールドカップの引用文テストによるものです。先を見据えることに関するエムバペ選手の引用文では、他のモデルが「match」を維持したのに対し、Geminiは「with each game」と表記し、レジスターのわずかなズレによりスコアは9.4でした。ヴィルツ選手の引用文では、Geminiはあるフレーズを逐語訳して意味を変えてしまい、こちらも9.4でした。スカローニ監督の引用文では、ほとんどのモデルが1つの解釈に収束したのに対し、Qwenは「that is what matters」と表記し、スコアは9.4でした。エムバペ選手の戦術に関する引用文では、ClaudeとDeepSeekがイギリスのサッカー英語を選んだのに対し、Gemini、Qwenなどはアメリカ英語を選び、Qwenのスコアは他よりも低い9.2となりました。
私はこれらをちょっとした癖だと捉えています。Geminiの例は、レジスターや逐語的な言い回しに関するものです。Qwenの例は、文のどの解釈を選択するかに関するものです。4つの例だけでパターンと呼ぶには少なすぎますが、単一のスコアに隠されてしまう違いの種類を示しています。
翻訳に最適なQwenのモデルはどれですか?
MachineTranslation.comのスコアではQwenがバージョンタグなしの単一モデルとして扱われているため、当社のデータから判断することはできません。Alibabaの Qwen3.8ファミリー は2026年8月にHugging Faceに登場したため、現在では複数のバージョンが存在しますが、本記事のスコアではそれらを区別していません。
これらをバージョンごとに分けたいところですが、現時点ではまだできません。プラットフォームレベルの数値は、対象期間中に稼働していた複数のQwenバージョンの平均値となっている可能性があります。プロジェクトのためにQwenのバージョンを選定する場合は、ご自身のテキストのサンプルを用いて比較することをお勧めします。
翻訳においてGeminiの代替となるモデルにはどのようなものがありますか?
ChatGPT、Claude、DeepSeek、Qwen、Grok、Mistral AIはすべてMachineTranslation.comで稼働しており、適切な代替モデルは言語ペアによって異なります。2026年7月12日から8月8日のスコアでは、英語への翻訳27ペアのうち24ペアで、QwenがGeminiとの差0.1点以内、あるいはGeminiを上回っています。当社のMistral AIのフランス語スコアを見ると、フランス語から英語への平均はGeminiを0.40点上回っています。
代替としてChatGPTを検討する場合も、結果は言語ペアによって分かれます。当社が公開したスペイン語から英語の内訳では、Geminiがセグメントの31%で勝利し、ChatGPTは21%でした。フランス語については、どちらのモデルも両方向で勝っているわけではありません。言語ペアによって最適な選択肢が変わるため、MachineTranslation.comは特定の代替モデルを1つだけ選ぶことはしません。それらを併用して実行します。
私の提案は、言語ペアと翻訳方向から始め、その上でどの代替モデルが適しているかを確認することです。
MachineTranslation.comは、QwenとGeminiの意見が分かれる箇所をどのように表示しますか?
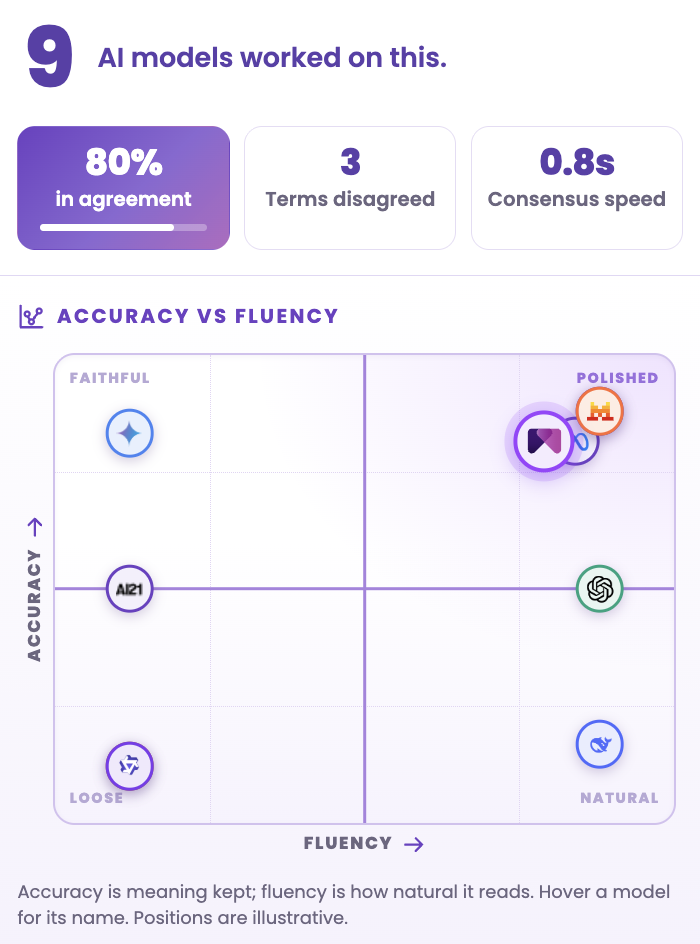
MachineTranslation.comは、すべての翻訳において両方のモデルを実行し、モデル同士が一致した箇所と分かれた箇所を表示します。合意パネルには、テキストの処理に携わったAIモデルの数、一致率、意見が分かれた用語の数、そして合意が形成されるまでの所要時間が表示されます。
これらの結果はどの程度最新のものですか?
これらの結果は2026年7月12日から8月8日を対象としているため、当時稼働していたGeminiおよびQwenのバージョンについて説明しています。Googleは Gemini 4 を2026年10月に発表しました。AlibabaのQwen3.8ファミリーは2026年8月に登場しました。新しいプロジェクトでこれらの数値を当てにする前に、パネルを再実行することをお勧めします。
同一のテキストをノイズの許容範囲を持たせて比較するという手法は有効であり続けると予想しています。スコア差の大きさについては変化すると予想しています。新たな実行で首位が入れ替わる言語ペアについては、以前の差がノイズの範囲内であった兆候として扱うべきでしょう。
プロジェクトではQwenとGeminiのどちらを選ぶべきでしょうか?
私の考えとしては、言語ペアと翻訳方向ごとに選び、プロジェクト全体でひとつのモデルに統一することは避けるべきです。実際には、0.1ポイント未満の差は引き分けとして扱い、言語ペアによって優位なモデルが変わることを想定するということです。私が進める手順は以下のとおりです。
- プロジェクト内のすべての言語ペアをリストアップし、その翻訳方向を記録します。
- この記事で各ペアの差を確認してください。0.1ポイント未満の差は同点として扱います。
- 差が大きい場合は、優勢なモデルから始めて、自前のテキストのサンプルでテストしてください。
- コンテンツが双方向に及ぶ場合は、ペアによって優勢なモデルが変わることを想定しておいてください。
- いずれかのモデルが新しいバージョンをリリースした際には、再度確認してください。
MachineTranslation.comでは、すべての翻訳において両モデルが他の20のモデルとともに実行されます。それらの大半が合意したバージョンが返されるため、プロジェクト全体で一度きりの選択をする必要はありません。モデルの結果の完全なセットは、当社のモデル比較テストでご確認いただけます。
よくある質問
1. 翻訳にはQwenとGeminiのどちらが優れていますか?
英語への翻訳27ペア中24ペアにおいてQwenがGeminiの0.1ポイント以内、またはリードしているため、方向によります。それでもMachineTranslation.comの2026年7月12日から8月8日のスコアでは、98ペア中68ペアでGeminiの方が高いスコアを獲得しました。10点満点中の平均差は0.08ポイントであるため、ペアごとに選ぶことをお勧めします。
2. 翻訳に最適なQwenモデルはどれですか?
MachineTranslation.comのスコアではQwenをバージョンタグなしの1つのモデルとして扱っているため、当社のデータからは判断できません。AlibabaのQwen3.8ファミリーは2026年8月にHugging Faceに登場したため、現在では複数のバージョンが存在します。スコアでそれらが区別されるようになるまでは、プロジェクトに向けて1つを選択する前に、自前のテキストのサンプルで各バージョンを比較することをお勧めします。
3. 翻訳においてGeminiの代替となるモデルにはどのようなものがありますか?
MachineTranslation.comでは、ChatGPT、Claude、DeepSeek、Qwen、Grok、Mistral AIのすべてが稼働しています。当社の2026年7月12日から8月8日のスコアでは、英語への27ペア中24ペアでQwenがGeminiの0.1ポイント以内、またはリードしています。フランス語から英語へのMistral AIの平均はGeminiを0.40ポイント上回りました。適切な代替モデルはペアによって異なります。
4. 翻訳においてGeminiはChatGPTより優れていますか?
あらゆるケースで勝利する単一のAIモデルは存在しないため、言語ペアによります。公開されているスペイン語から英語の内訳では、Geminiがセグメントの31%で勝利し、ChatGPTは21%でした。フランス語では、どちらのモデルも両方向で勝利しているわけではありません。両者の間で選択する前に、必要なペアと方向を確認することをお勧めします。
5. Geminiは翻訳において正確ですか?
はい、MachineTranslation.comの2026年7月12日から8月8日のスコアにおいて、Geminiは98の言語ペア全体で10点中平均9.06点を記録したためです。ただし、精度は言語ペアによって異なります。Geminiのリードは英語からの翻訳で最も大きく、英語への翻訳では27ペア中7ペアでQwenがGeminiを0.1点以上リードしています。