October 2, 2026
Qwen vs Grok: どちらのAIモデルの翻訳が優れているか?
QwenとGrokはどちらも汎用AIモデルであり、翻訳特化型のツールではありません。また、どちらもMachineTranslation.comが各翻訳を実行する際に使用するモデル群の一部です。このことは、以降の内容を読み解く上で重要になります。これは、プラットフォームに組み込まれた2つのモデルのパフォーマンスを互いに比較するものであり、外部の競合モデル2つとプラットフォーム自体の対決ではありません。また、この種のデータに伴う現実的な注意点を含んだ上での考察となります。
QwenとGrokとは?
Qwen はAlibabaの大規模言語モデルファミリーであり、現在はQwen3.8世代にあたります。プラットフォームの継続的な拡張の一環として、MachineTranslation.comのモデルプールに追加されました。 Grok はxAIのモデルラインであり、執筆時点ではGrok 4.7となっています。この記事で当初比較したバージョンから数回のリリースを経ており、別のタイミングでプラットフォームに追加されました。どちらのモデルも翻訳専用に開発されたものではありません。両者とも、より広範な言語機能の一部として多くの言語を扱える汎用システムであり、翻訳品質を専門として構築・テストされたプラットフォームとは出発点が異なります。
MachineTranslation.comの独自データにおいて、QwenとGrokの比較結果はどうなるでしょうか?
過去28日間のプラットフォームのトラフィックにおいて、GrokはQwenよりも高い平均スコアを記録しました(10点満点中、Qwenの8.87に対してGrokは9.26)。Grokのスコアが最も低かった下位10%の翻訳でも平均9.2を維持したのに対し、Qwenの下位10%は7.6まで低下しており、下位層においては平均スコアから受ける印象以上に大きな差が開いています。
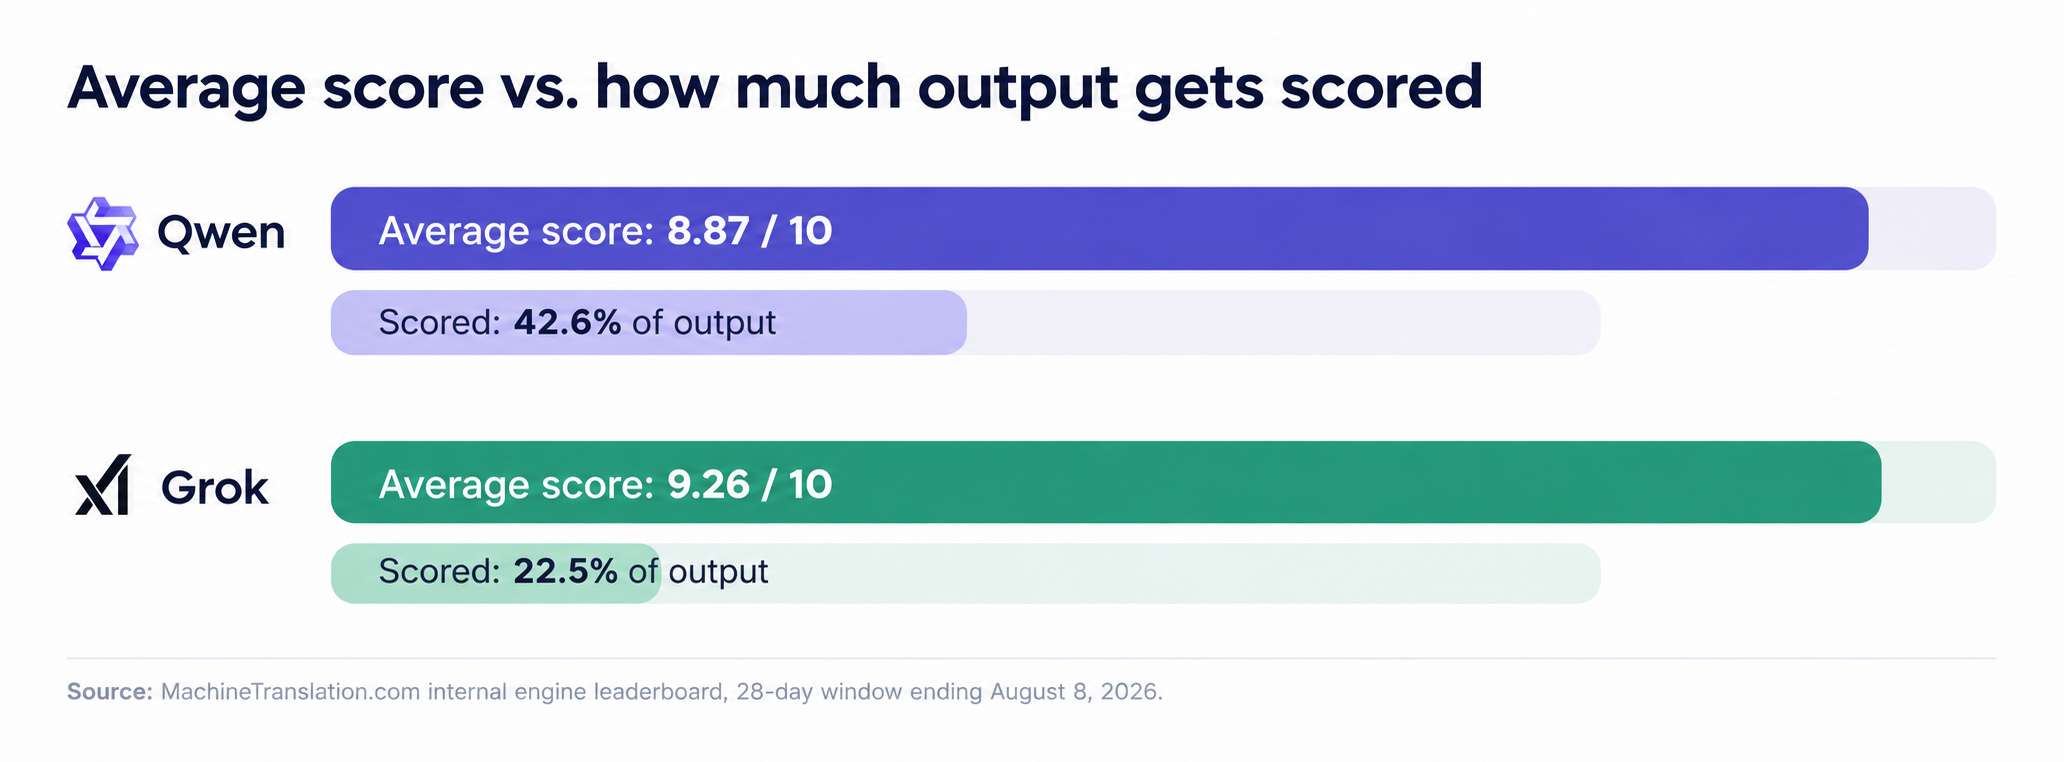
Grokの平均スコアの方が高いものの、これは出力の4分の1未満しかスコア付けされていないことに基づく結果であり、Qwenの出力のほぼ半分がスコア付けされているのとは対照的です。この2つの棒グラフは、同じ事象の異なる側面を示しています。
| Qwen | Grok | |
|---|---|---|
| スコア付けされた出力の割合 | 42.6% | 22.5% |
| 平均スコア | 8.87 / 10 | 9.26 / 10 |
| スコアの下位10% | 7.6 | 9.2 |
出典: MachineTranslation.comの内部エンジンリーダーボード、August 8, 2026までの28日間。
Grokのスコアが高いということは、Grokの方が優れた選択肢であるということでしょうか?
それだけでは判断できません。プラットフォーム上でGrokが使用される頻度はQwenよりもはるかに低く、Qwenの翻訳のほぼ半分がスコア化されているのに対し、Grokの翻訳は4分の1未満しかスコア化されていません。サンプル数が少なく、代表性に欠ける場合、Qwenと同じデータ量で評価した場合よりも平均値が良く見えたり、悪く見えたりする可能性があります。このデータに関するMachineTranslation.com独自のレポートでは、スコア化の対象範囲を単なる補足ではなく、実際の制限事項として扱っています。つまり、トラフィックの狭い範囲でしかスコア化されていないエンジンは、出力のほぼ半分にわたってスコア化されているエンジンほど徹底的にテストされていないということです。
正直なところ、Grokの数値は有望ですが、データとしては薄いと言えます。一方、Qwenの数値は平均的には低いものの、はるかに大きく、より代表的なデータに基づいています。どちらの事実も、もう一方を打ち消すものではありません。
言語カバレッジについてはどうでしょうか?
QwenもGrokも、パフォーマンスが低下する言語ペアの検証済みリストを公開しておらず、それを確認するための独立したテストも存在しません。確かなことは、どちらのモデルも、専用の翻訳プラットフォームのように特定の言語セット全体での翻訳品質を重視して構築されたわけではないということです。MachineTranslation.comは270以上の言語を直接テストしてサポートしていますが、これは汎用モデルの幅広くもテストされていない多言語機能とは異なる種類の主張です。
MachineTranslation.comでのQwenとGrokの実際の使用方法
MachineTranslation.comでは、すべての翻訳に対してQwen、Grok、その他20以上のAIモデルを実行し、それらのモデル間で最も一致したバージョンを提示します。平均スコアが低いからといって、どちらのモデルも除外されることはありません。多くのモデルを同時に実行することで、平均スコアの高いモデルが間違えた特定の文章を、平均スコアの低いモデルが正しく翻訳するケースを捉えることができます。Qwenのパフォーマンスは翻訳方向や言語ペアによっても異なるため、単一のモデルを選択する前に知っておくべき重要なポイントがあります。これについては、MachineTranslation.comのQwenとDeepSeekの比較でさらに詳しく説明されています。モデル同士が直接どのように比較テストされているかについての詳細は、MachineTranslation.comの完全なモデル比較テストをご覧ください。
よくある質問
1. 翻訳にはQwenとGrokのどちらが適していますか?
MachineTranslation.com独自の28日間のエンジンデータでは、10点満点中、Grokの平均スコアは9.26、Qwenは8.87と、Grokの方が高くなっています。しかし、Grokは出力のうちのかなり少なく、代表性に欠ける部分のみでスコア化されているため、これはセグメントを揃えたテストのような純粋な直接比較ではありません。
2. Grokの平均スコアが高いのに、スコア付けされた翻訳が少ないのはなぜですか?
プラットフォーム上でGrokが使用される頻度は低く、Qwenの出力の42.6%がスコア化されるのに対し、Grokの出力は約22.5%しかスコア化されません。サンプル数が少なく代表性に欠ける場合、平均値が過大評価または過小評価される可能性があるため、この比較は決定的なものではなく、傾向を示すものとして読み取るべきです。
3. QwenとGrokのどちらがより多くの言語に対応していますか?
どちらも汎用AIモデルであり、言語固有の制限に関する検証済みのリストは公開されていません。どちらも翻訳に特化して構築されたものではありません。これは、測定された翻訳パフォーマンスの代用として広範な多言語トレーニングに依存するのではなく、270以上の言語にわたる翻訳品質を直接テストしてスコア付けするプラットフォームとは異なります。
4. MachineTranslation.comはQwenやGrokと競合していますか?
いいえ。MachineTranslation.comは、すべての翻訳でQwen、Grok、その他20以上のAIモデルを実行し、それらのモデルが最も一致するバージョンを提示します。独自の独立したモデルとして競合するのではなく、このようなモデルをテストして組み合わせています。
5. MachineTranslation.comは翻訳にどのAIモデルを推奨していますか?
デフォルトでは推奨するモデルはありません。言語ペアやコンテンツの種類によってモデルのパフォーマンスは異なり、何を翻訳するかによって、モデル間の差はどちらの方向にも開く可能性があります。このようなばらつきがあるからこそ、プラットフォームは単一のモデルを常時推奨するのではなく、すべての翻訳で複数のモデルを実行しているのです。